
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
LLM научили лучше решать трудные задачи, меняя не фильтр правильности, а состав собственных учебных ответов. В препринте University of Edinburgh, который не проходил рецензирование и содержит замеры самих авторов, разнообразные, но ошибочные решения от Qwen3-4B дали лучший результат, чем правильные ответы от Qwen3-235B. Для команд это повод пересмотреть генерацию данных перед дообучением: ещё один похожий правильный ответ может быть менее полезен, чем новая стратегия с ошибкой.
Почему независимые ответы повторяют одну стратегию
Обычное самообучение устроено так: модель несколько раз отвечает на одну задачу, проверка отбрасывает ошибки, а на оставшихся примерах модель дообучают. Ответы получают через независимую выборку из одного распределения (IID), поэтому формулировки меняются, но способ решения часто остаётся прежним.
Такой набор закрепляет то, что модель и без обучения выбирала чаще всего. Повышение температуры добавляет случайности на уровне токенов, но не гарантирует перехода к другому алгоритму, структуре данных или плану развития сюжета.
Проблема проявляется после обучения. Если модель снова генерирует несколько кандидатов, они отличаются мало: проверяющему модулю почти не из чего выбирать, при обучении с подкреплением ответы получают одинаковые оценки, а объединение нескольких решений не приносит нового материала.
Работа предлагает сначала заставить модель перечислить разные подходы и только затем написать по каждому полный ответ. Verbalized Sampling формирует неструктурированный список стратегий с предполагаемыми вероятностями. GROOT строит дерево решений и выбирает разные пути от корня к листьям, поэтому два ответа должны расходиться хотя бы в одном существенном решении.
Выбранную стратегию передают модели как скрытую инструкцию. Итоговый учебный пример сохраняет обычный формат рассуждения и ответа, а упоминания самой инструкции автоматически удаляют. При применении модели дерево больше не строят: дополнительная генерация нужна только при подготовке данных.
Разные подходы помогли там, где правильные ответы редки
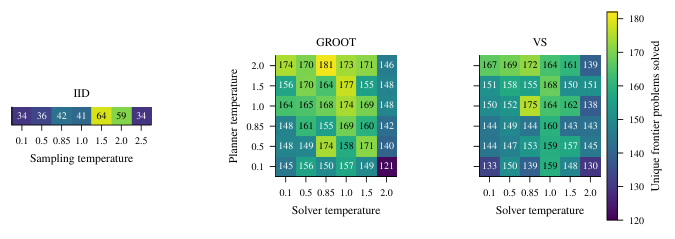
На сложной части обучающего набора Cobalt при бюджете в четыре кандидата обычная выборка решила хотя бы раз 42 задачи из 1 833. GROOT решил 155, а Verbalized Sampling — 137. На отложенных задачах по программированию обученные таким способом модели более чем утроили долю случаев, где хотя бы один из нескольких ответов проходил тесты; увеличение бюджета обычной выборки сопоставимого эффекта не дало.
Фильтр правильности оказался не главным источником выигрыша. Дообучение только на ошибочных, но стратегически разных трассах превзошло обучение на правильных независимо сгенерированных решениях. Небольшая Qwen3-4B также подготовила для себя более полезный набор через стратегическую выборку, чем крупная Qwen3-235B через обычную дистилляцию.
Эффект сохранился после следующих этапов конвейера. Стратегически обученные модели давали более удачную начальную точку для обучения с подкреплением и для Recursive Self-Aggregation — метода, который несколько раз объединяет набор кандидатов в новые ответы.
В планировании следующей главы результат повторился без автоматической проверки правильности. Обычное обучение на лучших планах почти не улучшало исходную модель, а наборы с разными стратегиями чаще давали планы, которые помогали предсказывать реальное продолжение текста. Значит, эффект не сводится к особенностям тестов для кода.
Когда стоит менять конвейер подготовки данных
Работа касается систем, где из одной задачи генерируют несколько учебных ответов, а затем оставляют лучшие. Если кандидаты различаются словами, но используют один алгоритм или один план, увеличение числа генераций расходует вычисления на повторение уже представленной стратегии.
Практическое изменение локально: перед генерацией полных ответов можно добавить этап планирования подходов, а обучение и применение модели оставить прежними. GROOT подходит областям с последовательными зависимыми решениями, как в программировании. Неструктурированный Verbalized Sampling уместнее там, где пространство вариантов трудно представить деревом.
При расчёте стоимости нужно учитывать дополнительный вызов модели для построения списка или дерева. Авторы не включали его в заявленный бюджет кандидатов, хотя сравнивали стратегические наборы с обычной выборкой существенно большего размера. Поэтому работа показывает направление оптимизации данных, но не даёт готового расчёта экономии для промышленного конвейера.
Границы проверки достаточно узкие: основные опыты провели на Qwen3-4B-Instruct и повторили ключевые тенденции на Nemotron3 Nano-4B. Модели обучали на Cobalt, проверяли на Cobalt, LiveCodeBench и OJBench, а перенос за пределы программирования изучали на Next-Chapter Prediction. Основной выигрыш искали на задачах у границы возможностей конкретной модели, где обычная выборка редко находила рабочее решение.
Менять всю схему дообучения по этой работе не требуется. Сначала имеет смысл проверить, сколько разных стратегий уже содержит текущий набор, затем сравнить обычную генерацию с явным планированием подходов при одинаковом числе полных ответов. Если последующие этапы зависят от нескольких кандидатов, разнообразие следует измерять по способам решения, а не по различию формулировок.
Источники
Иллюстрация: рисунок из статьи «Strategically Diverse Sampling for Self-Training», Alexander Gurung, Esmeralda S. Whitammer, Mirella Lapata, CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


