
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Систему научили переносить удачные способы рассуждения между задачами, а не искать их заново для каждого продукта. Хотя работа Taiming Lu, Qi Xu, Zhigang Hua и Zhuang Liu не прошла рецензирование и числа получили сами авторы, Strategist обошёл сильнейший базовый метод на 24 из 30 тестов и при сопоставимой точности снизил вычислительную стоимость на 39%. Это предлагает командам новый слой архитектуры: отдельно развивать не только модель и подсказки, но и исполняемый код, который управляет вызовами модели.
Стратегия стала исполняемым компонентом
Стратегия вывода определяет, какие модели вызвать, в каком порядке, когда запросить проверку и как собрать итоговый ответ. Обычно такую логику пишут под конкретную задачу: команда вручную соединяет подсказки, инструменты, повторные попытки и голосование, а затем оставляет получившуюся конструкцию внутри одного сервиса.
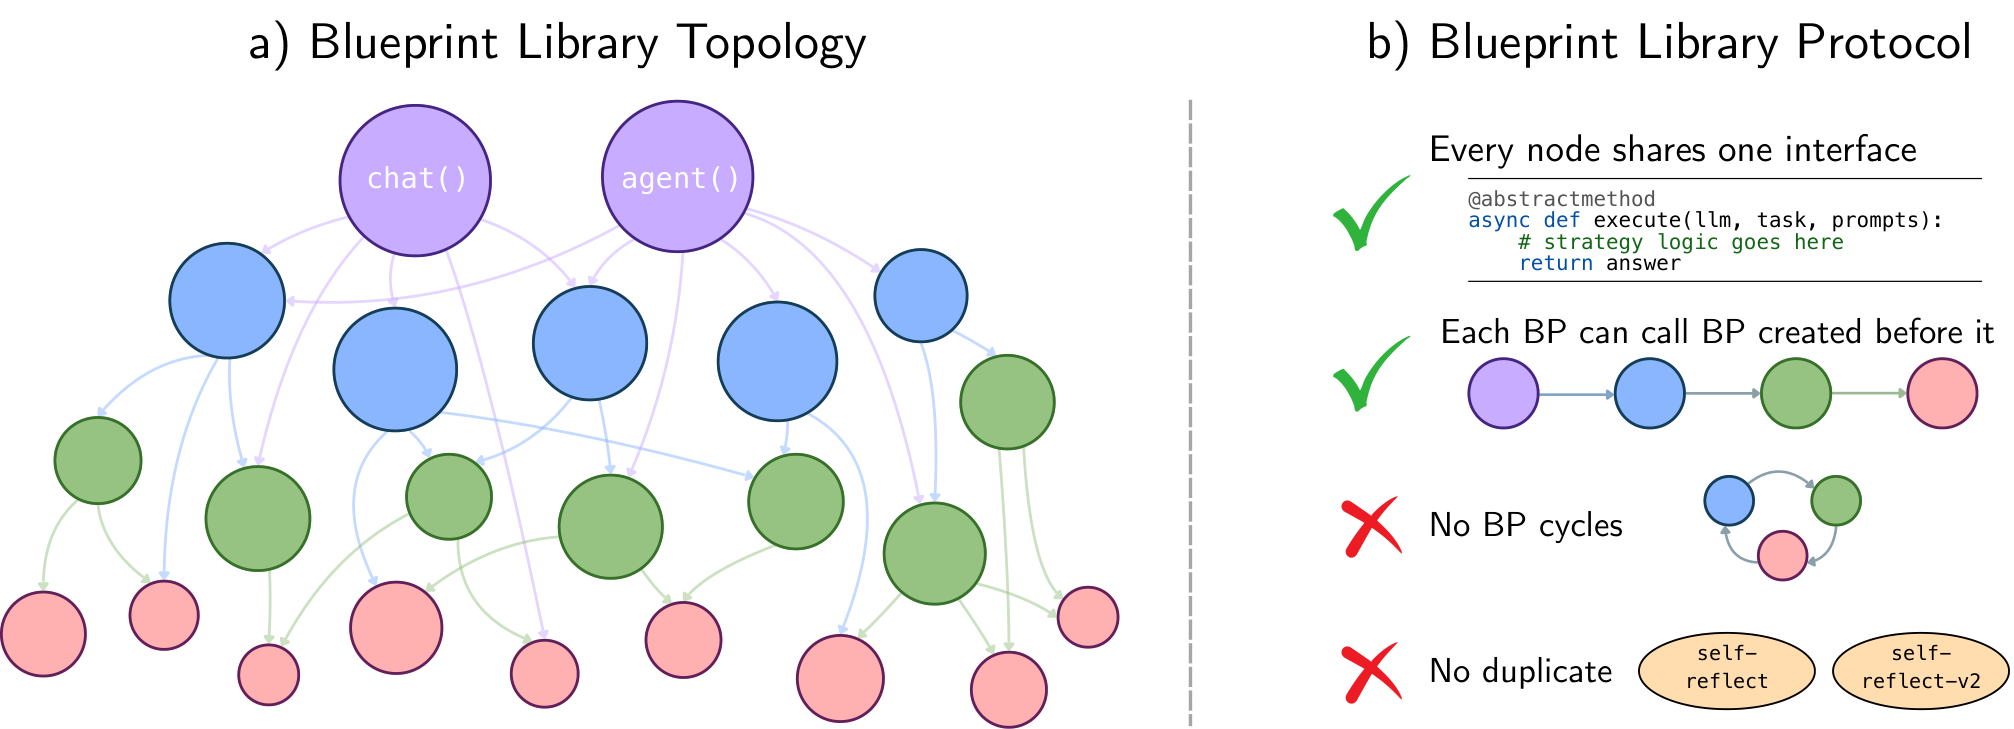
Strategist меняет единицу переиспользования. Он хранит не готовую подсказку, а схему стратегии (Strategy Blueprint) — программу на Python с общим интерфейсом execute(llm, task) -> str. В ней остаются структура рассуждения, ветвления и выбор класса модели, но нет привязанных к задаче подсказок.
Общий интерфейс позволяет одной схеме вызывать другую. Например, новая стратегия может взять готовое извлечение фактов, добавить независимую проверку и передать спорные случаи более сложной модели. Библиотека запрещает циклические вызовы и хранит вместе с кодом результаты замеров и заметки о том, где схема сработала или дала сбой.
При работе над новой задачей Strategist ищет в библиотеке близкие схемы и намеренно добавляет несколько отличающихся примеров. Затем GPT-6 пишет кандидатов: полностью новые, собранные из прежних компонентов или повторно применяющие готовую структуру с другими подсказками.
Кандидаты запускаются на реальных примерах. На учебной части мета-агент видит оценки и полные трассы выполнения, на проверочной — только сводный результат. Отдельная скрытая часть помогает выбрать стратегию между итерациями, а финальная тестовая часть не участвует в поиске. Все модели, которые решают сами задачи, остаются замороженными: меняется только управляющий ими код.
Библиотека перенесла результат на незнакомые задачи
Метод проверяли на математике, программировании, логике, знаниях, здравом смысле, многошаговых вопросах и рекомендациях. В роли исполнителей выступали три Qwen3 разного размера, а сравнение включало прямые подсказки, цепочки рассуждений, голосование, самопроверку, применение инструментов и многоагентные схемы. Для каждого теста базовым считали метод, который лучше всего показал себя на доступной учебной части.
Стоимость измеряли не в деньгах, а во взвешенных токенах. Токены более крупных моделей получали больший вес пропорционально числу параметров. Поэтому заявленная экономия показывает снижение приблизительной вычислительной нагрузки внутри эксперимента, но не заменяет расчёт счёта конкретного API.
После основного поиска библиотеку проверили на десяти отложенных тестах без новой серии итераций. Полученная стратегия превзошла базовый метод на восьми из них, а средняя точность выросла с 77,8 до 81,4%. Это наиболее содержательная часть результата: накопленный код оказался полезен за пределами задач, на которых его создавали.
Схемы, найденные на Qwen3, также без изменений запускались на GPT-5 и Gemini-2.5 и в большинстве проверок превосходили заново запущенные базовые методы. Этот результат стоит читать осторожно: часть преимущества на GPT-5 возникла потому, что некоторые базовые процессы возвращали ответы в неверном формате, тогда как схемы Strategist продолжали работать.
Командам нужен реестр стратегий, а не замена модели
Работа не предлагает новую LLM и не требует обучать веса. Она показывает, как превратить накопленный опыт разработки агентов в инженерный актив: вынести структуру рассуждения из прикладного кода, задать ей стабильный интерфейс и хранить вместе с измеренными точностью, стоимостью и условиями применения.
Для команды, которая строит несколько близких ИИ-функций, практический план меняется. Вместо отдельных цепочек подсказок в каждом сервисе имеет смысл завести реестр исполняемых стратегий, единый стенд оценки и маршрутизацию между доступными моделями. Новую задачу тогда можно начинать с проверенных схем извлечения, проверки, голосования или работы с инструментами, а не с пустого файла.
Автоматический поиск пока не стоит принимать как готовую замену архитектору. Эксперименты проведены на стандартизированных тестах, с небольшими исполнительными Qwen3 и отдельной GPT-6 в роли проектировщика. Для продуктового процесса всё равно понадобятся собственные примеры, проверки формата, ограничения времени ответа и расчёт цены у выбранного поставщика.
Главный вывод уже применим без Strategist: стратегия работы с моделью должна быть версионируемым компонентом с тестами и историей замеров. Если такие компоненты используют общий интерфейс, опыт одной функции можно переносить в следующую — вручную сейчас и автоматическим поиском позже.
Источники
Иллюстрация: рисунок из статьи «Strategist: Evolving Reasoning with Agents», Taiming Lu, Qi Xu, Zhigang Hua и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


