
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Детекторы временных рядов, которые не обновляют модель на каждом новом фрагменте, чаще находят аномалии точнее потоковых методов. Работа EDF R&D и ENS сравнила оба подхода на реальных данных, хотя препринт не рецензирован и числа получили сами авторы. Для продукта это меняет порядок разработки: сначала стоит проверить замороженную модель, а потоковое обновление добавлять только под подтверждённые ограничения.
Замороженная модель тоже может работать с потоком
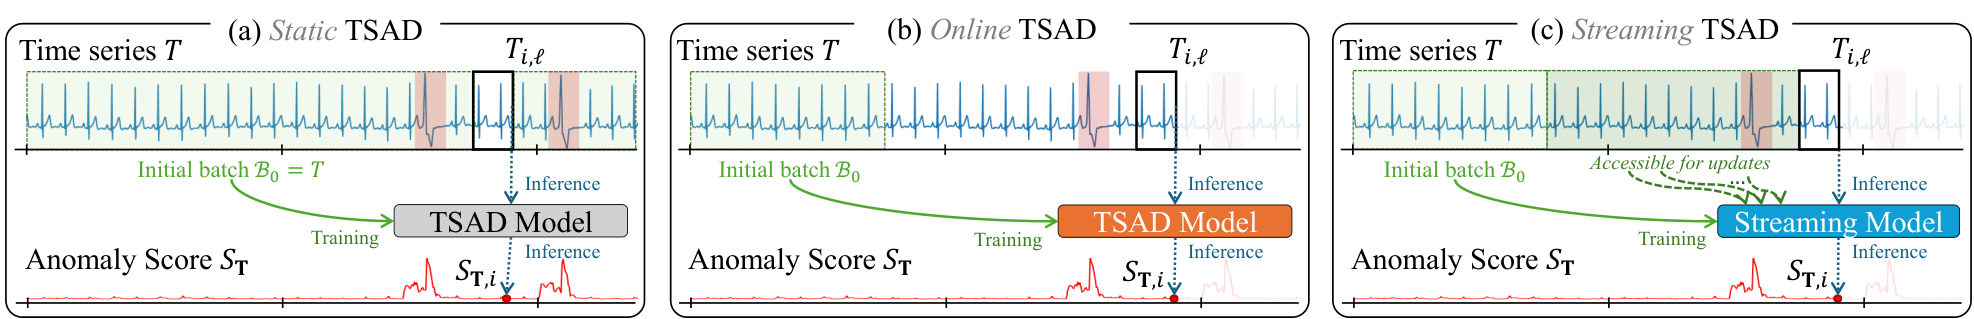
Авторы разделяют три режима. Статический метод видит временной ряд целиком и может учитывать будущие точки при оценке прошлых. Такой режим подходит для анализа уже собранных данных, но не для работающего в реальном времени сервиса.
Онлайн-метод сначала обучается на начальном фрагменте, затем последовательно оценивает новые точки, но больше не меняет параметры. Потоковый метод делает то же самое и дополнительно обновляет своё состояние по мере поступления данных. Именно онлайн- и потоковый режимы сравниваются в главном эксперименте.
Это различие существенно для архитектуры продукта. Возможность обрабатывать события по одному не требует постоянно переобучать модель: обученный детектор можно оставить неизменным и запускать на скользящем окне последних наблюдений.
В StrAD вошли 17 наборов реальных многомерных временных рядов, 19 статических и онлайн-методов и 10 потоковых. Эксперимент остаётся в рамках обучения без разметки: начальный фрагмент может содержать аномалии, а правильные ответы используют только для итоговой оценки.
Качество измеряли площадью под кривой точность—полнота. Этот показатель учитывает одновременно долю верных срабатываний и долю найденных аномалий; чем он выше, тем лучше метод отделяет редкие отклонения от нормальных точек. Скорость оценивали числом точек, которые модель обрабатывает за секунду.
Потоковые методы устойчивее к сдвигу, но всё равно менее точны
Онлайн-модели без обновлений чаще опережали потоковые по качеству. Разрыв особенно заметен на аномалиях, которые занимают целый отрезок ряда и проявляются как изменение формы или последовательности, а не как одиночный выброс.
Причина лежит в происхождении потоковых алгоритмов. Многие из них проектировали для поиска отдельных необычных точек и ради скорости ограничивали сложность модели. Методы временных рядов лучше учитывают связи между соседними наблюдениями и поэтому распознают коллективные аномалии, которые лёгкий потоковый детектор принимает за норму.
Для отдельной проверки сдвига распределения авторы собрали TSB-drift из реальных рядов, где статистические свойства меняются между начальным и последующим фрагментами. Потоковые методы действительно теряли меньше качества: 70% из них оказались устойчивее, чем 70% онлайн-моделей. Однако меньшая потеря относительно собственного результата не закрыла исходный разрыв в абсолютной точности.
Тип сдвига тоже влияет на итог. При трёх из четырёх рассмотренных вариантов лучшие потоковые и онлайн-методы работали почти одинаково. При медленном непрерывном изменении онлайн-модели сохранили преимущество: модели, которые выучили форму сигнала, могли узнавать её и после смещения значений.
Цена точности — вычисления. На границе между скоростью и качеством оказались подходы обоих классов, а самый медленный из отобранных там методов обрабатывал в среднем 770 точек в секунду. Потоковые модели занимают область высокой пропускной способности и малого расхода памяти, но обновления делают время ответа менее стабильным.
Обновление модели стоит добавлять после замера дрейфа
Работа не поддерживает правило «есть поток данных — нужна потоковая модель». Для промышленного мониторинга, телеметрии или медицинских сигналов разумной исходной архитектурой становится онлайн-инференс с неизменными параметрами. Он проще в эксплуатации и в этом сравнении чаще даёт более точные оценки.
Потоковый метод остаётся оправданным, когда продукт ограничен памятью, должен обрабатывать особенно быстрый поток или сталкивается с заметным сдвигом распределения. Даже тогда устойчивость к сдвигу нельзя подменять итоговым качеством: адаптирующаяся модель может деградировать меньше, но всё ещё пропускать больше аномалий.
Практический выбор стоит строить вокруг характера самих отклонений. Если опасное событие выглядит как короткий выброс, лёгкие потоковые алгоритмы конкурентоспособны. Если оно проявляется в форме участка, взаимном движении нескольких показателей или длительном изменении режима, приоритет получает модель, которая умеет представлять временной контекст, даже если её параметры остаются замороженными.
Границы вывода заданы самим сравнением: авторы проверяли обучение без разметки на многомерных реальных рядах, давали моделям начальный фрагмент и затем имитировали последовательное поступление данных. Результат относится к рассмотренным детекторам и видам сдвига, а не доказывает бесполезность любых будущих способов обновления.
Источники
Иллюстрация: рисунок из статьи «In a Streaming World, Should You Stand Still? A Comprehensive Benchmark of Anomaly Detection in Streams», Magali Parrino, Antoine Ajenjo, Emmanuel Remy и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


