
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Инструментального ИИ-агента научили выбирать между действием, поиском информации и уточняющим вопросом, а затем вовремя возвращать управление исходной модели. В ToolSandbox ограниченное вмешательство повысило итоговый результат, тогда как постоянный контроль его ухудшил. Для продуктовых команд это аргумент в пользу отдельного контроллера поверх готового агента, хотя работа не рецензирована и числа в ней получены самими авторами.
Каждое решение проверили в нескольких возможных продолжениях
Обычный журнал работы агента показывает только выбранное действие. Если агент сразу вызвал инструмент и успешно закончил задачу, из журнала нельзя понять, дал бы предварительный поиск тот же результат дешевле или предотвратил бы ошибку.
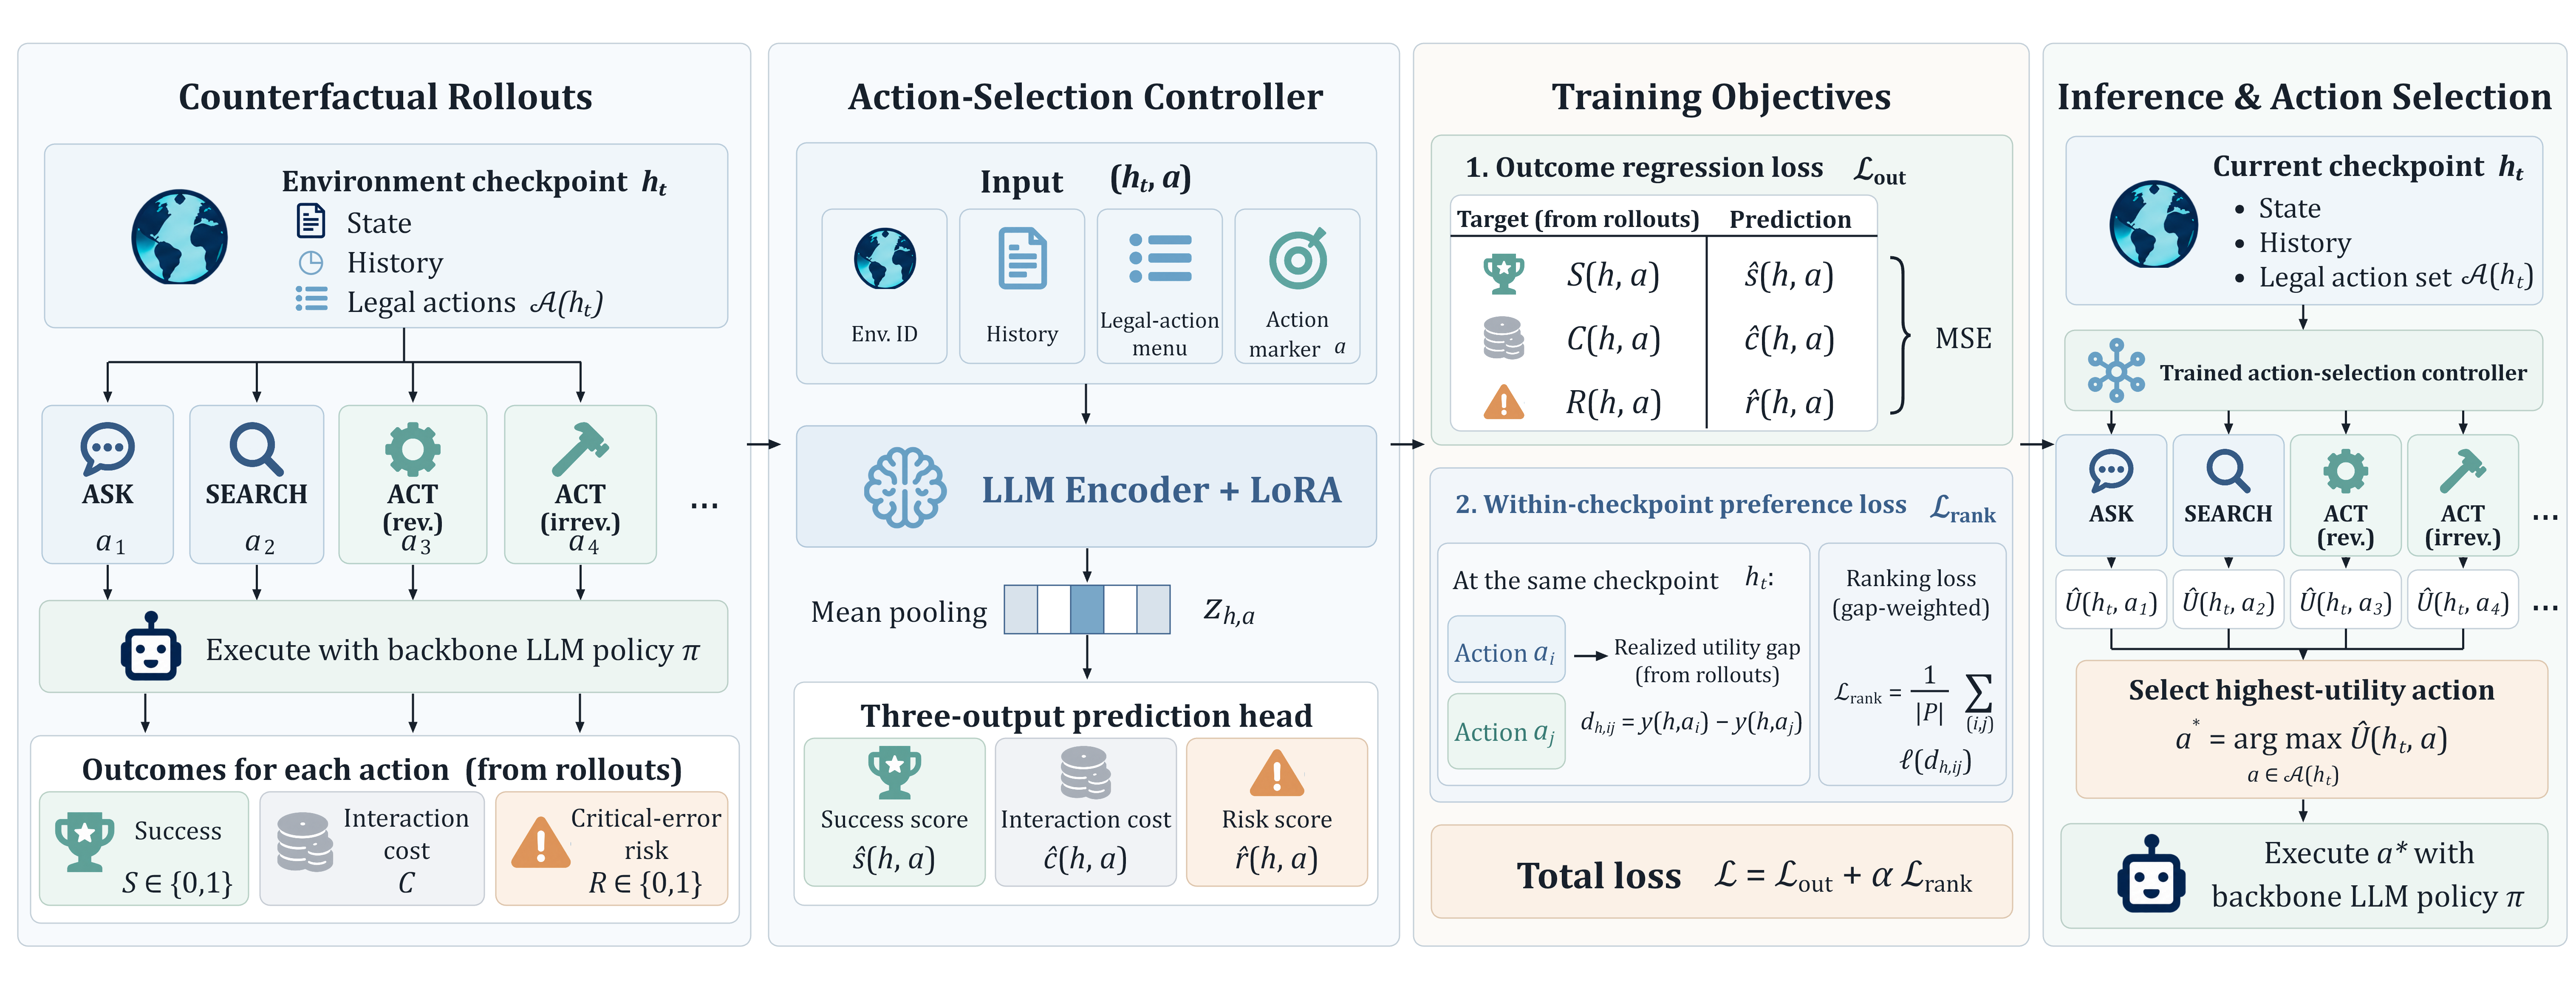
SURE-Act собирает недостающие исходы в исполняемой среде. Система сохраняет состояние перед решением, создаёт его копии и в каждой принудительно выбирает один допустимый вариант: спросить пользователя, найти сведения без изменения среды, выполнить обратимое действие или сделать необратимое изменение. После первого шага ограничение снимают, и замороженная базовая модель заканчивает задачу сама.
Так получился набор из 1 036 точек принятия решения и 3 115 продолжений. Для каждого продолжения среда оценивает выполнение задачи, стоимость взаимодействий и критическую ошибку — необратимое действие без требуемого разрешения.
На этих примерах обучают отдельный контроллер. Он получает историю взаимодействия и возможное действие, предсказывает три результата, сводит их в полезность с заранее заданными штрафами и выбирает лучший вариант. Базовую модель при этом не дообучают.
Одного прогноза результата оказалось недостаточно: небольшая ошибка в абсолютной оценке может поменять порядок двух близких действий. Поэтому SURE-Act дополнительно учится сравнивать варианты внутри одного сохранённого состояния и ставить выше тот, который дал лучший итог.
Контроллер не остаётся главным до конца эпизода. Если он три раза подряд предлагает один тип действия, система прекращает вмешательство до выполнения последнего предложения, а задачу продолжает исходный агент. Это не новый вариант действия и не отказ от задачи, а передача управления обратно базовой модели.
Постоянный контроль оказался хуже ограниченного
Добавление прямого сравнения действий повысило полезность автономного выбора на 0,0309 пункта относительно обучения только по прогнозу результатов. То есть преимущество дал не более точный прогноз сам по себе, а умение правильно расставить доступные варианты.
В сквозном прогоне контроллер с правилом возврата управления прибавил 0,0344 пункта к сводному баллу ToolSandbox. Тот же контроллер без остановки, напротив, снизил результат на 0,0707 пункта. Отдельный хороший выбор не гарантирует хороший эпизод, если система снова вмешивается на каждом следующем шаге и уводит продолжение от поведения, на котором строились обучающие примеры.
Метки для обучения тоже нельзя считать точным ожидаемым результатом действия. Для каждого варианта запускали одно продолжение при нулевой температуре; при повторной разметке лучший вариант поменялся в 345 из 725 общих состояний. Контроллер учится на наблюдавшемся исходе, который может не совпасть со средним результатом при многократных запусках.
Для внедрения нужен разветвляемый стенд, а не новая базовая модель
Работа меняет прежде всего план разработки управляющего слоя. Вместо дообучения всего агента команда может заморозить рабочую модель, определить несколько типов решений и обучить небольшой контроллер на продолжениях из собственного испытательного контура. Это отделяет выбор стратегии — спросить, проверить или выполнить — от генерации конкретного вызова инструмента.
Цена такого подхода лежит в подготовке среды. Она должна сохранять состояние, безопасно создавать копии, принудительно разрешать только выбранный тип действия и автоматически оценивать завершённую траекторию. Если бизнес-процесс нельзя воспроизвести без реальных платежей, сообщений или изменений данных, контрфактические продолжения придётся строить в симуляторе.
Проверка охватывает один симулированный бенчмарк ToolSandbox, три размера Qwen3 и отдельный пул из 89 незнакомых семейств задач. Положительный итоговый эффект относится ко всей связке из контроллера и правила остановки: эксперименты не отделяют вклад обученного выбора от расписания вмешательств с сопоставимой частотой. Кроме того, улучшенная система чаще базового агента попадала под условия критической ошибки, поэтому рост сводного балла нельзя трактовать как доказательство безопасности.
Практический вывод уже применим к проектированию испытаний: контроллер следует оценивать не только по качеству следующего решения, но и в полном цикле. Нужны отдельные проверки того, как часто он перехватывает управление, когда возвращает его базовой модели и не накапливает ли локально разумные вмешательства в худший итог.
Источники
Иллюстрация: рисунок из статьи «Agents' Last Doubt: Knowing When to Act and When to Step Back in Tool-Using Agents», Qisai Liu, Qingyue Jiao, Bangwei Guo и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


