
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Задачи для проверки программирующих агентов научились создавать прямо во время оценки, чтобы они не попадали в обучающие данные и не устаревали вместе с ростом моделей. В работе SMU, которая пока не прошла рецензирование и содержит замеры самих авторов, задания новейшей версии одной серии побеждали фиксированного агента-проверяющего в 42,9% случаев против 4,0% у старых версий. SWE-Duel может дольше сохранять полезность, чем статические наборы задач.
В каждом раунде один агент добавляет в реальный репозиторий новую функцию, пишет для неё тесты и прячет в коде ошибку. Задачу принимают, только если обычные тесты проходят, закрытые тесты обнаруживают ошибку, а новая сессия того же агента может исправить её без подсказки. Второй агент получает изменения на проверку, но не знает, что внутри обязательно есть дефект; для победы он должен сохранить функцию, убрать ошибку и не сломать прежнее поведение.
Такой порядок убирает заранее опубликованные задания и эталонные исправления. Сложность задаёт не составленный людьми набор, а способность соперника придумать дефект, который другой агент пропустит. При этом проверка собственного исправления ставит потолок: автор задачи должен уметь найти и устранить свою ошибку в новой сессии.
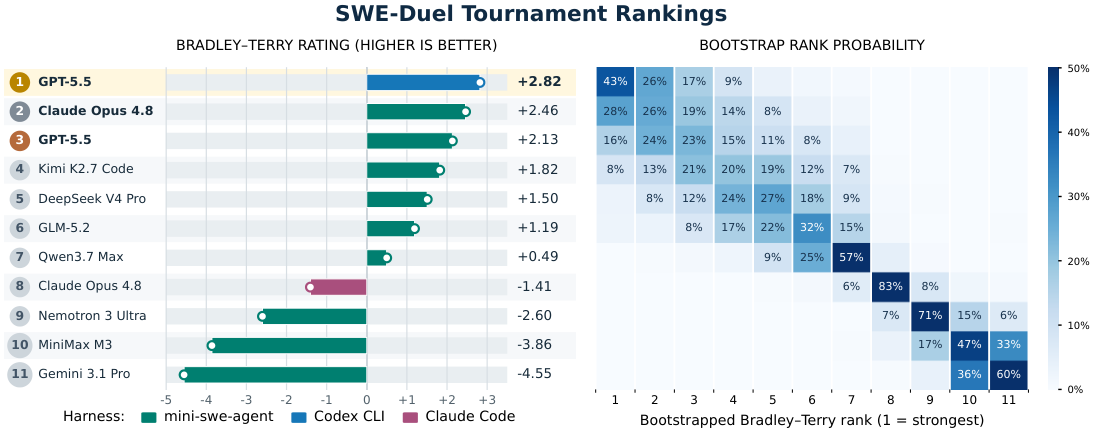
SWE-Duel проверили в турнире между разными сочетаниями моделей и сред агентов на реальных репозиториях с кодом на пяти языках. За 1500 ходов GPT-5.5 с Codex CLI исправил 98,3% дефектов, которые получил на проверку. Результаты показывают не только общий рейтинг: бенчмарк отдельно выявляет агентов, которые хорошо чинят чужой код, и агентов, которые создают трудные, но проверяемые задачи.
Источники
Иллюстрация: рисунок из статьи «SWE-Duel: Towards a Self-Scaling Arena for Coding Agents», Wei Minn, Zhensu Sun, Lwin Khin Shar и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


