
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Прошлые попытки решения задачи можно использовать для обучения кодового агента, не показывая ему эту историю. Хотя препринт University of Connecticut и Ant Group не рецензировали и все числа получили сами авторы, собранные методом SWE-Trail данные превзошли независимые прогоны на двух тестах ремонта репозиториев. Для команд, которые дообучают собственные модели, это меняет устройство сборщика данных, а не самого агента.
Независимые прогоны повторяют одни и те же решения
Кодовый агент исследует репозиторий, редактирует файлы и запускает проверки. Вся последовательность действий образует траекторию, которую затем можно использовать для дообучения модели.
Обычно для одной задачи запускают несколько независимых попыток, а после оставляют успешные или чистят ошибки. Но каждый следующий прогон всё чаще исследует уже известные файлы и повторяет прежние действия. В наборе SeedBank первая попытка решала в среднем 58,4 задачи, вторая добавляла 13,1, а пятая — только 3,4.
История особенно полезна там, где успешная и неудачная попытки расходятся после похожего состояния. Даже если все попытки провалились, они могут раз за разом менять одни файлы или продолжать чтение после правки вместо запуска тестов. Такие повторения показывают, где стоит потратить дополнительные вычисления на альтернативный шаг.
Прямой путь — пересказать прошлые попытки агенту как совет. Тогда он принимает решения с информацией, которой не будет при обычном применении. Обучающая траектория закрепляет зависимость от подсказки, поэтому условия обучения расходятся с условиями работы модели.
История управляет ветвлением, но не попадает в контекст
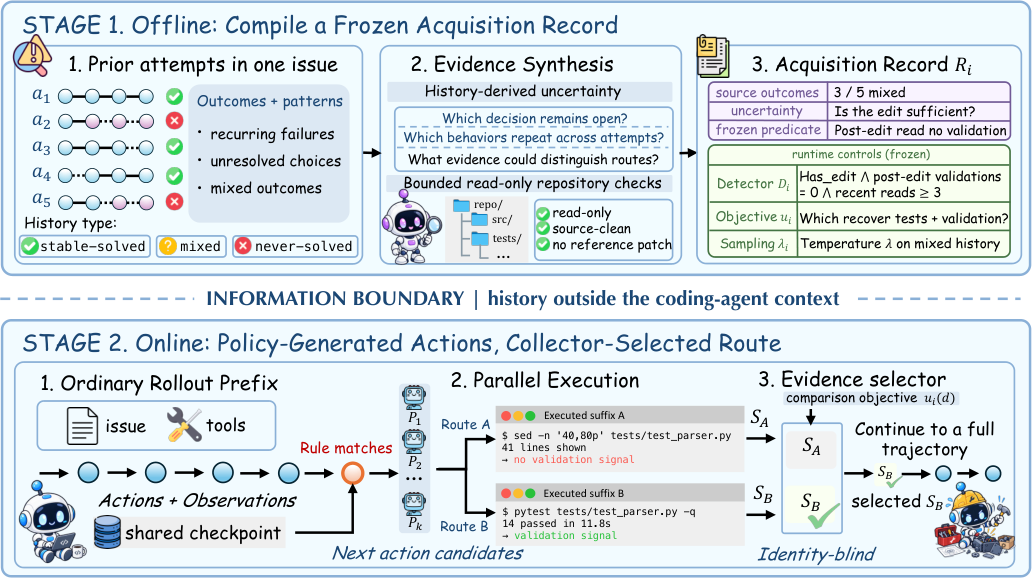
SWE-Trail разделяет сборщик и кодового агента. До запуска сборщик изучает предыдущие траектории, выполняет ограниченные проверки репозитория только для чтения и создаёт правила, которые распознают спорные состояния. История и результаты этой подготовки остаются закрытыми для агента.
Когда новое прохождение достигает такого состояния, агент предлагает следующие действия из своего обычного контекста. Сборщик выбирает одну подходящую альтернативу, восстанавливает две изолированные копии рабочего состояния и ненадолго выполняет оба варианта от одной контрольной точки.
Продолжает работу маршрут, который лучше подтверждён состоянием репозитория: например, результатами тестов или найденным кодом. Сборщик не сообщает оценщику, какой вариант был исходным, а при отсутствии убедительной разницы сохраняет исходный шаг. В одной траектории допускается только одно такое сравнение, поэтому процесс не превращается в разрастающееся дерево поиска.
В обучающий набор попадает только выбранная ветвь. Исходные рассуждения и действия агента не переписывают, а вторую ветвь, историю и служебные решения сборщика удаляют. В результате запись выглядит как обычная непрерывная работа агента без скрытой подсказки.
Прирост есть, но внедрять нужно на этапе сбора данных
На студенте Ling-3.0-flash-base траектории SWE-Trail-H5 повысили долю решённых задач относительно независимых прогонов на 2,33 процентного пункта в SWE-bench Multilingual и на 1,60 пункта в SWE-bench Pro. Та же схема без истории дала на первом тесте лишь 0,11 пункта, хотя собирала больше успешных траекторий. Значит, для дообучения важен не только итоговый патч, но и то, где сборщик исследовал альтернативы.
Результат сохранился на другом студенте: Qwen3-14B-Base прибавил 3,11 пункта в SWE-bench Multilingual и 2,42 пункта в SWE-bench Pro. Это снижает риск, что эффект связан только с одной обучаемой моделью.
Эксперимент охватывает 300 задач SWE-rebench V2, для каждой собирали по пять траекторий. Все прогоны выполняла GLM-5.1 через OpenHands, а студентов проверяли на SWE-bench Multilingual и SWE-bench Pro; репозитории из набора для сбора не встречались в тестах. Работа сравнивает две модели-студента, но только одну модель-сборщик и одну оболочку агента.
Команде, которая уже собирает траектории для дообучения кодового агента, стоит вынести историю в отдельный управляющий слой. Ему понадобятся контрольные точки, изолированные рабочие копии, исполняемые проверки и возможность скрыть служебные данные из итоговой записи. Простого добавления прошлых решений в запрос недостаточно: именно граница между сборщиком и агентом устраняет расхождение условий.
Для продукта, который вызывает готовую модель через API и не дообучает её на собственных траекториях, работа не требует менять текущую архитектуру. SWE-Trail улучшает подготовку обучающих данных; он не заменяет стратегию агента во время обычного запуска и добавляет расходы на краткое выполнение альтернативных ветвей.
Источники
Иллюстрация: рисунок из статьи «SWE-Trail: History-Guided Trajectory Collection for Coding Agent Training», Ziming Li, Lu Yu, Jiatan Huang и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


