
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Стало возможно находить в неудачном запуске LLM-агента конкретный шаг, где совет эксперта меняет итог. В препринте Amazon, который пока не прошёл рецензирование и приводит числа, полученные самими авторами, SynAct повысил точность на отложенных задачах в среднем на 11,7 процентного пункта. Такой подход позволяет тратить экспертное время на отдельные решения, а затем выполнять процесс без эксперта.
Как отличают важное решение от случайного расхождения
Многошаговый агент ошибается по двум причинам. Иногда он знает правильный путь, но допускает случайный промах — тогда помогает повторный запуск. В другом случае ему не хватает знания о предметной области или правилах среды, поэтому новые попытки воспроизводят ту же ошибку.
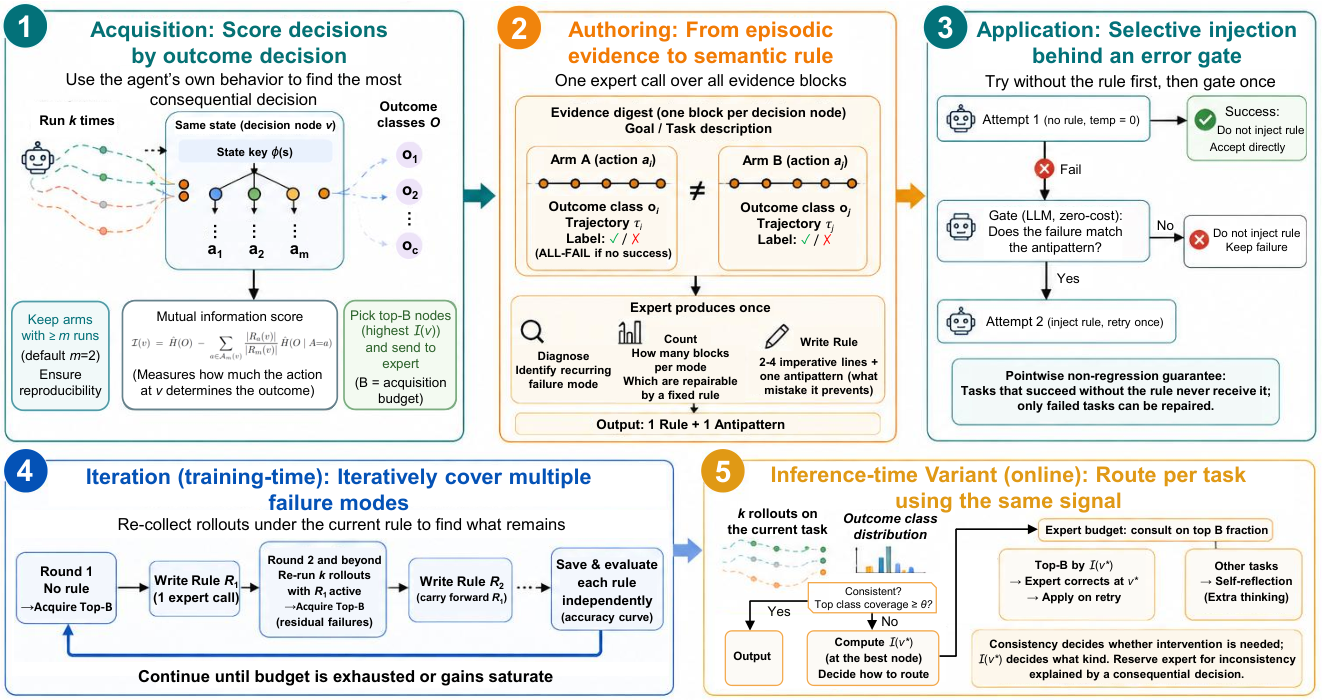
SynAct несколько раз запускает агента на одной задаче и сопоставляет моменты, когда разные запуски пришли в одинаковое состояние, но выбрали разные действия. Затем метод проверяет, связаны ли эти действия с разными конечными результатами.
Связь измеряет взаимная информация: она показывает, насколько знание выбранного действия уменьшает неопределённость относительно итога. Если разные действия заканчиваются одинаково, совет эксперта в этой точке вряд ли поможет. Если действия ведут к разным результатам, решение получает высокий приоритет.
Методу не нужен правильный ответ или хотя бы один успешный запуск. Даже когда все попытки провалились, они могут завершиться разными командами, SQL-запросами или наборами вызванных инструментов. Оценка по успеху сочла бы такие попытки одинаковыми, а SynAct сохраняет различия между неудачными исходами.
По умолчанию для задачи делали восемь запусков и учитывали вариант действия, только если он повторился хотя бы дважды. Это отсекает единичные случайности, но одновременно мешает находить редкие ошибки. Качество ранжирования также зависит от того, можно ли надёжно определить одинаковое состояние и содержательно разделить конечные результаты.
Как одна поправка становится переносимым правилом
Эксперт получает не всю траекторию, а отобранные точки принятия решений. В одном обращении он формулирует правило из двух частей: как следует действовать и какой ошибочный шаблон это правило предотвращает.
Правило не добавляют в контекст каждого запуска. Сначала агент пытается решить задачу самостоятельно, затем фильтр проверяет неудачную траекторию на известный ошибочный шаблон. Только при совпадении правило включают в следующую попытку. Модель при этом не дообучают, а её параметры остаются замороженными.
Такой фильтр нужен из-за регрессий: полезная в одном случае инструкция может ухудшить уже решённые задачи. Разделение на правило и ошибочный шаблон позволяет хранить накопленный опыт, не превращая его в постоянную добавку к каждому запросу.
Метод проверяли на четырёх наборах задач: преобразовании текста в SQL, составном создании предметов, командах оболочки и диалогах с инструментами. В экспериментах участвовали модели из трёх семейств, а роль эксперта выполнял Claude Opus. При маршрутизации обращений во время выполнения SynAct обошёл каскад моделей, оценку неопределённости и модель-оценщик в 15 из 16 сочетаний условий; одна направленная поправка также оказалась полезнее семи дополнительных попыток без конкретной цели.
Когда подход меняет план агентной системы
SynAct имеет смысл закладывать в архитектуру, если процесс состоит из повторяемых шагов, результаты можно автоматически классифицировать, а экспертное время дороже запусков агента. Вместо проверки каждой неудачной траектории команда может собирать несколько вариантов выполнения, ранжировать решения и отдавать эксперту только верх списка.
Для этого журнал агента должен хранить состояние среды, выбранное действие и конечный результат. Состояния придётся нормализовать: убрать счётчики и другие поля, которые меняются между одинаковыми по смыслу попытками. Ошибка в таком ключе либо разделит одно решение на несколько групп, либо объединит разные ситуации и сделает оценку бесполезной.
Подход предлагает два режима. Во время подготовки продукта эксперт создаёт правила, после чего агент применяет их самостоятельно. В рабочей среде тот же сигнал может направлять к эксперту только те запросы, где разные действия действительно меняют исход, но тогда эксперт остаётся частью контура выполнения.
Границы эксперимента важны для внедрения: задачи выполнялись в средах с формализованным состоянием и автоматической проверкой, а человеческого эксперта заменял Claude Opus. Фильтр также может пропустить уверенную и одинаковую во всех запусках ошибку. Поэтому SynAct скорее дополняет предметную проверку и наблюдаемость процесса, чем заменяет их.
Источники
Иллюстрация: рисунок из статьи «SynAct: Synergistic Active Feedback Learning for LLM Agents», Ning Liu, Ian Li, Kristina Klinkner, CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


