
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Быстрые модели принятия решений уже могут заменить генеративную модель-оценщика в части задач, где нужно выбрать лучший ответ или проверить его по эталону. С эталонным ответом они приблизились к моделям с рассуждением при расходах примерно в 16 раз ниже. Shreyas Subramanian из Scale AI описал это в препринте, который не рецензировали и где все числа получил сам автор; результат позволяет вынести массовую проверку ответов в дешёвый первый этап.
Сильные модели сравнялись с GPT-5.6 без рассуждения
Модель принятия решений System-1 не пишет объяснение и не строит длинную цепочку рассуждений. Она за один проход отвечает на вопрос в заданном формате: выбирает вариант, возвращает «да» или «нет» либо ставит оценку. Вместе с ответом модель выдаёт вероятность, поэтому её уверенность можно использовать для маршрутизации спорных случаев.
В работе сравнили 14 таких моделей с четырьмя генеративными моделями-оценщиками на одиннадцати известных наборах задач. Проверка охватывала парное сравнение ответов, выбор лучшего варианта из группы, соответствие оценкам людей и устойчивость к инструкциям, которые пытаются повлиять на оценщика.
Пять моделей — DReX-Max, d1-ultra, Mercury-Decide, Jev 1.14 и pplx-decider 1.2 — не отличались от GPT-5.6 без рассуждения во всех проверках парного выбора и выбора лучшего из четырёх. Разница находилась в пределах погрешности. При этом результаты внутри класса System-1 различались сильно: само устройство модели не гарантирует качества, поэтому выбирать её только по типу интерфейса нельзя.
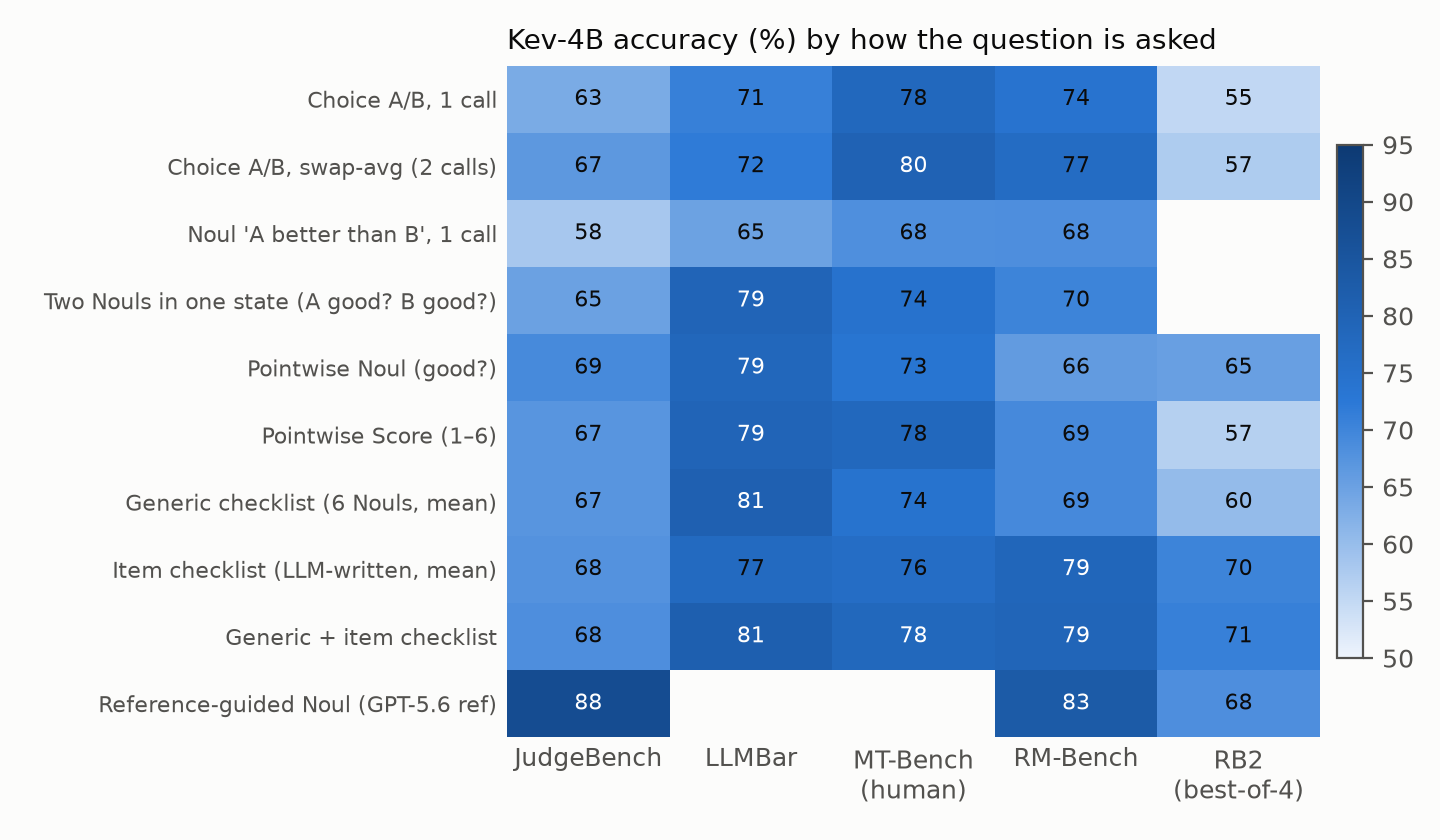
Простой запрос работал лучше всего для сильных моделей: оценщик сразу видел два ответа и выбирал один. Список отдельных критериев — правильность, полнота, следование инструкции и другие — помогал в основном слабым моделям. Для сильных он добавлял сложность, но обычно не улучшал результат.
Эталонный ответ компенсирует отсутствие рассуждения
Главный практический приём — один раз получить короткий эталонный ответ от GPT-5.6, а затем поручить дешёвой модели сравнивать с ним все варианты. На JudgeBench одиннадцать моделей достигли точности 90,3–93,4% и статистически не отличались от GPT-5.6 и Claude Opus с рассуждением.
При выборе ответа из множества кандидатов эталон особенно выгоден: его создают один раз на запрос, после чего повторяют только дешёвую проверку. Такой режим подходит для отбора лучшей генерации, фильтрации синтетических данных и подготовки сигнала для обучения. Без эталона сильные System-1-модели оставались на уровне генеративных оценщиков без рассуждения, но уступали моделям, которые тратят токены на анализ.
Второй вариант — многоступенчатая схема. System-1-модель проверяет каждый ответ, а случаи с низкой уверенностью передаёт Claude Opus. На LLMBar такая схема достигла точности Opus, отправив ему только 17% примеров. Это работает лишь с хорошо откалиброванной моделью: её уверенность должна действительно указывать, где она чаще ошибается.
Калибровка полезна и за пределами маршрутизации. Она позволяет задать порог для автоматического принятия ответа, отправки человеку или повторной проверки другой моделью. Несколько System-1-моделей в работе оценивали собственную уверенность точнее всех генеративных моделей из сравнения.
Планы меняются для массовой оценки, но не для всех проверок
Командам, которые вызывают модель-оценщика тысячи раз на один пакет данных, имеет смысл добавить System-1 в архитектурный выбор. Базовая схема выглядит так: сильная модель принятия решений обрабатывает очевидные случаи, генеративная модель создаёт эталон там, где ответ можно проверить, а сложные и неуверенные случаи уходят модели с рассуждением.
Перед внедрением придётся проверить конкретную модель на собственных данных. Добавленная к ответу инструкция для оценщика меняла до 4,7% верных решений у пяти устойчивых моделей, но от 16,7% до 49% у остальных. Значит, общий ярлык System-1 ничего не говорит о защите от инъекций: этот тест нужен отдельно, особенно если ответы приходят от пользователей или оптимизируются автоматически.
Длинные входы тоже остаются слабым местом: на LongRewardBench даже лучшие быстрые оценщики уступали GPT-5.6 на 10–12 процентных пунктов. Для проверки больших документов, длинных диалогов и траекторий агентов полностью убирать генеративный второй этап рано.
Работа не предлагает универсальную замену LLM-судьи. Она даёт более узкое архитектурное правило: для большого потока однотипных оценок стоит сначала проверить сильную System-1-модель, добавить общий эталон там, где существует проверяемый ответ, и маршрутизировать остаток по уверенности. Экономия появляется не от одной дешёвой модели, а от разделения простых и сложных решений.
Источники
Иллюстрация: рисунок из статьи «To Jev or Not to Jev: When Can System-1 Decision Models Replace LLM Judges?», Shreyas Subramanian, CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


