
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Обвязку LLM-агента научили чинить точечно, не меняя веса модели и не ломая уже успешные задачи. В препринте, который не проходил рецензирование и приводит замеры самих авторов, T2A обошёл лучшие сравниваемые подходы в среднем на 6,2–30,3 балла в зависимости от модели. Для продуктовой команды это переносит акцент с перебора промптов на воспроизводимую диагностику каждой правки.
Одинаковые сбои требуют разных правок
Под обвязкой авторы понимают всё, что управляет работой модели вокруг её весов: системные инструкции, память, карточки навыков, сбор контекста, проверки действий и интерфейсы инструментов. Ошибка в итоговом ответе не показывает, какой из этих компонентов подвёл.
Агент может не знать нужную процедуру. Но внешне так же выглядит случай, когда процедура уже записана в карточке навыка, однако условие вызова не добавило её в контекст. В первом случае нужно менять содержание карточки, во втором — правило её доставки.
Итоговый балл скрывает ещё одну проблему: после устранения первого препятствия агент доходит до следующего и снова терпит неудачу. Правка при этом могла сработать именно так, как задумано, хотя задача по-прежнему не завершена.
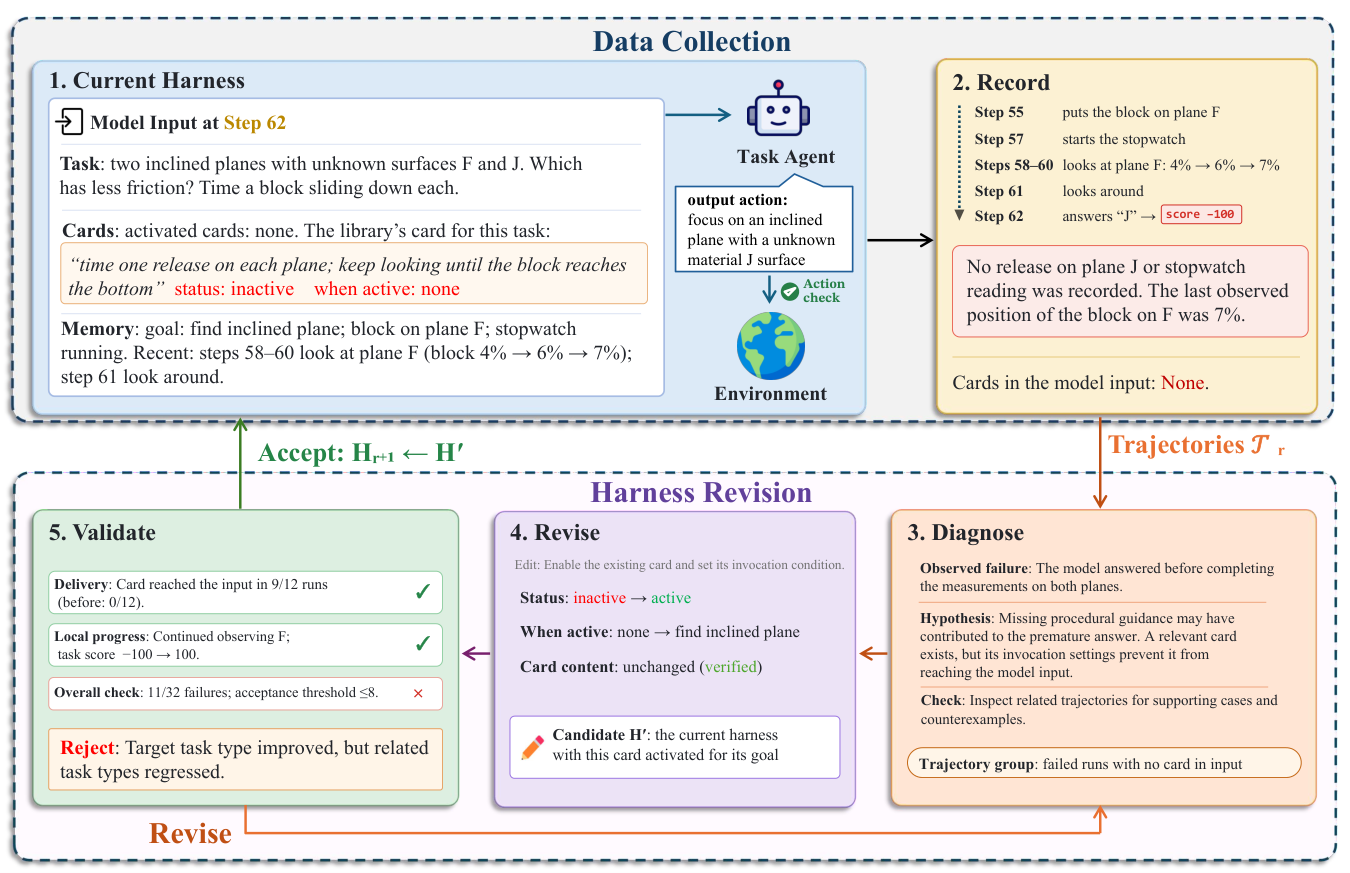
T2A поэтому анализирует трассу выполнения — последовательность входов модели, её решений, действий, ответов среды и итогового результата. Система сопоставляет неудачный запуск с близкими успешными случаями и ищет момент, где их поведение расходится.
Все задачи с неполным результатом группируют по наблюдаемым признакам. Для каждой группы агент-разработчик формулирует причину сбоя, условия, при которых она проявляется, и указывает конкретные записи, подтверждающие гипотезу. Если трасс недостаточно, он меняет правила журналирования или запускает целевое сравнение, а не выбирает правку наугад.
Как трасса превращается в проверяемую правку
Подтверждённая причина указывает на компонент обвязки. T2A может переписать карточку навыка, изменить условие её вызова, уточнить правило выбора действия, добавить проверку недопустимой команды или исправить обновление памяти.
До запуска кандидатной версии агент-разработчик записывает условия приёмки. Правка должна улучшить целевые задачи, сохранить результат на связанных успешных задачах и действительно сработать во время выполнения. Последнее проверяют по входу модели, вызову компонента или прохождению нужной ветки кода.
Такой порядок отделяет полезную правку от случайного роста оценки. Если компонент ни разу не вызвался, улучшение нельзя приписать ему. Если целевая ошибка исчезла, но соседние задачи сломались, кандидат не становится новой принятой версией.
После принятия система собирает новые трассы и начинает следующий цикл диагностики. Обвязка меняется последовательно: текущая версия остаётся основной, пока кандидат не выполнит заранее записанные условия.
Проверка охватила бытовые задачи ALFWorld, научные эксперименты ScienceWorld и работу с приложениями в AppWorld. Агентами служили Qwen3.5-27B, Qwen3.5-9B и DeepSeek V4.1 Flash, а правки готовил Claude Opus 5 через Claude Code. T2A сравнивали с минимальным промптом, ReAct, GEPA, WorldEvolver, SkillNet и Meta-Harness при общей исходной обвязке.
Когда T2A меняет план разработки агента
Самая полезная деталь видна не в средней оценке, а в движении ошибок. Среди 384 задач AppWorld, где Qwen3.5-9B сначала не мог сформировать или выполнить вызов приложения, после правок 216 завершились успешно, 150 дошли до ошибок уже в содержании, и только 18 сохранили прежний тип сбоя. Исправление нижнего слоя открыло следующий узкий участок.
Отдельный опыт с Meta-Harness показывает ценность самого процесса. При той же исходной обвязке, внешнем отборе, модели-разработчике и доступных ресурсах инструкции T2A повысили среднюю оценку в ScienceWorld на 21,6 балла. Значит, результат дала не только расширенная телеметрия, но и требование связать диагноз, правку и условия её приёмки.
Для команды, которая уже строит агента с инструментами и памятью, работа предлагает поменять порядок разработки. Сначала стоит сохранять входы модели, решения, результаты инструментов и изменения памяти; затем группировать повторяющиеся сбои; перед каждой правкой фиксировать целевые и защищённые сценарии.
Полностью автоматизировать этот цикл пока рискованно. В T2A агент-разработчик сам толкует трассы и сам решает, выполнены ли смысловые условия приёмки: отдельная программа не проверяет его вывод. Результат также зависит от модели-разработчика, сохранённого контекста, версии Claude Code и доступных инструментов.
Работа сравнивает качество полученных обвязок, а не стоимость цикла правок, поэтому бюджет внедрения из неё не вывести. Практический первый шаг — не воспроизводить весь T2A, а добавить структурированные журналы, неизменяемую принятую версию и регрессионные задачи для каждого изменяемого компонента.
Источники
Иллюстрация: рисунок из статьи «Trace-to-Architecture: Capability Bottleneck Diagnosis for Harness Revision», Wenfeng Wang, Jianrui Shi, Mingang Guo и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


