
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Модель для вызова инструментов научили работать с таджикскими запросами, но промежуточное обучение на обычных текстах сначала уничтожило штатный формат команд и часть самого навыка. В препринте команды Saidzoda AI Lab, который не прошёл рецензирование и содержит замеры самих авторов, точность полного вызова выросла с 20,69% до 64,14% после последующего обучения на примерах. Для команд вывод практический: языковую адаптацию нельзя принимать по качеству текста — вызовы надо проверять после каждого этапа отдельными тестами.
Как отделили сломанный формат от утраченного навыка
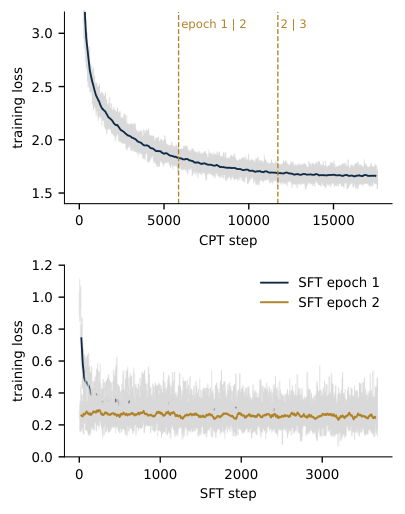
За основу взяли LFM2.5-2.6B-Base и построили обучение в два этапа. Сначала модель продолжила предобучение на таджикских веб-текстах через LoRA, затем её обучили на размеченной смеси таджикских и английских вызовов инструментов, а также обычных инструкций на таджикском.
Английские примеры добавили повторно, чтобы восстановить исходный навык и штатную запись команд. Названия инструментов, схемы API и ключи аргументов оставили на английском: такой вариант ближе к системе, где пользователь пишет по-таджикски, а внутренний API не локализован.
Проверка строилась на наборе из 174 заданий BFCL v3. Пользовательские запросы машинно перевели на таджикский, а определения инструментов и эталонные вызовы сохранили без изменений. Полный вызов считали правильным, только если модель выбрала все нужные функции, точно передала ключи и значения аргументов и не добавила лишних команд.
Строгий анализатор принимал только родной синтаксис LFM2.5. Дополнительный анализатор искал те же команды в JSON, Python-подобной и XML-подобной записи. Такое разделение показывает, перестала ли модель понимать задачу или лишь записывает правильное действие в неожиданной форме.
Эксперимент охватывает одну модель, один запуск и жадное декодирование, при котором модель каждый раз выбирает наиболее вероятный следующий токен. Тестовые запросы перевела та же система, что готовила учебные примеры, и носители языка их не проверяли. В собственном корпусе также нашли строки, которые декодировали не тем токенизатором; все результаты относятся к модели, обученной с этим дефектом.
Ноль после текстов скрывал две разные поломки
После каждого проверенного этапа продолженного предобучения строгая точность стала равна 0% в обоих языках. Модель почти перестала выдавать специальные теги LFM2.5 и переключилась на другие способы записи команд. Для рабочей системы это полноценный отказ: анализатор не сможет исполнить даже содержательно верный ответ.
Однако замена анализатора не вернула исходный результат. На английских заданиях мягкая проверка после первого этапа дала 35,17% против 76,55% у базовой модели. Значит, обучение на обычном тексте повредило не только оболочку ответа: модель чаще ошибалась при выборе функции и заполнении аргументов.
Обучение на размеченных вызовах вернуло штатный формат и восстановило английский результат до уровня базы. На таджикском лучше всего работали одиночные и параллельные команды, а многошаговые сценарии оставались слабыми. Среди оставшихся ошибок чаще встречались неверные значения аргументов, а не неверно выбранные функции.
Отдельная проблема — отказ от вызова, когда подходящего инструмента нет. Финальная модель правильно воздерживалась лишь в 6,9% таджикских заданий такого типа против 31,0% у базы при мягкой проверке. Поэтому её нельзя ставить перед API, который меняет данные или проводит операции, без проверки команды.
Что менять в плане языковой адаптации
Работа меняет план для команд, которые переносят готовую модель вызова инструментов на новый язык. Продолженное предобучение стоит считать отдельной миграцией, после которой прежние прикладные навыки могут исчезнуть, даже если модель стала лучше продолжать текст на нужном языке.
После каждого этапа полезны две проверки. Строгий анализатор должен воспроизводить реальный контракт приложения и отклонять любой неожиданный формат. Мягкий нужен только для диагностики: он показывает, сохранила ли модель смысл команды, когда нарушила синтаксис.
В учебную смесь следует заранее включить исходный язык, штатный формат вызовов и примеры, где модель не должна вызывать ничего. В этой работе английское повторение входило в успешный рецепт, но отдельного запуска без него не было, поэтому его вклад нельзя отделить от остальных данных.
Для многошаговых операций недостаточно проверить отдельный JSON или список аргументов. Нужен тест с состоянием процесса, результатами предыдущих вызовов и посторонними инструментами среди доступных. Финальную команду следует пропускать через проверку схемы, допустимых значений и бизнес-правил, а опасные действия — подтверждать человеком.
Saidzoda-Tajik-LFM-2.6B показывает рабочий способ получить таджикские вызовы на небольшой модели, но не доказывает, что продолженное предобучение обязательно. Практическая ценность работы в другом: нулевая точность может означать сразу поломку протокола и потерю навыка, а различить их можно до внедрения.
Источники
Иллюстрация: рисунок из статьи «Saidzoda-Tajik-LFM-2.6B: Adapting a 2.6B Hybrid Model to Tajik Tool Calling, and What Continued Pretraining Takes Away», Tohir Saidzoda, Nekruz Maxudov, Bedil Karimov и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


