
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Языкового агента для многошаговых задач научились уменьшать без пропорциональной потери успешности. В препринте Yuanzhe Li и коллег, который не прошёл рецензирование и опирается на замеры самих авторов, после удаления 60% каналов агент сохранил 99,2% исходного результата на ALFWorld. Для команд, которые развёртывают специализированных агентов, это превращает структурное прореживание из разовой процедуры в цикл: вырезать, восстановить и заново оценить оставшуюся модель.
Как TAP решает, какие каналы вырезать
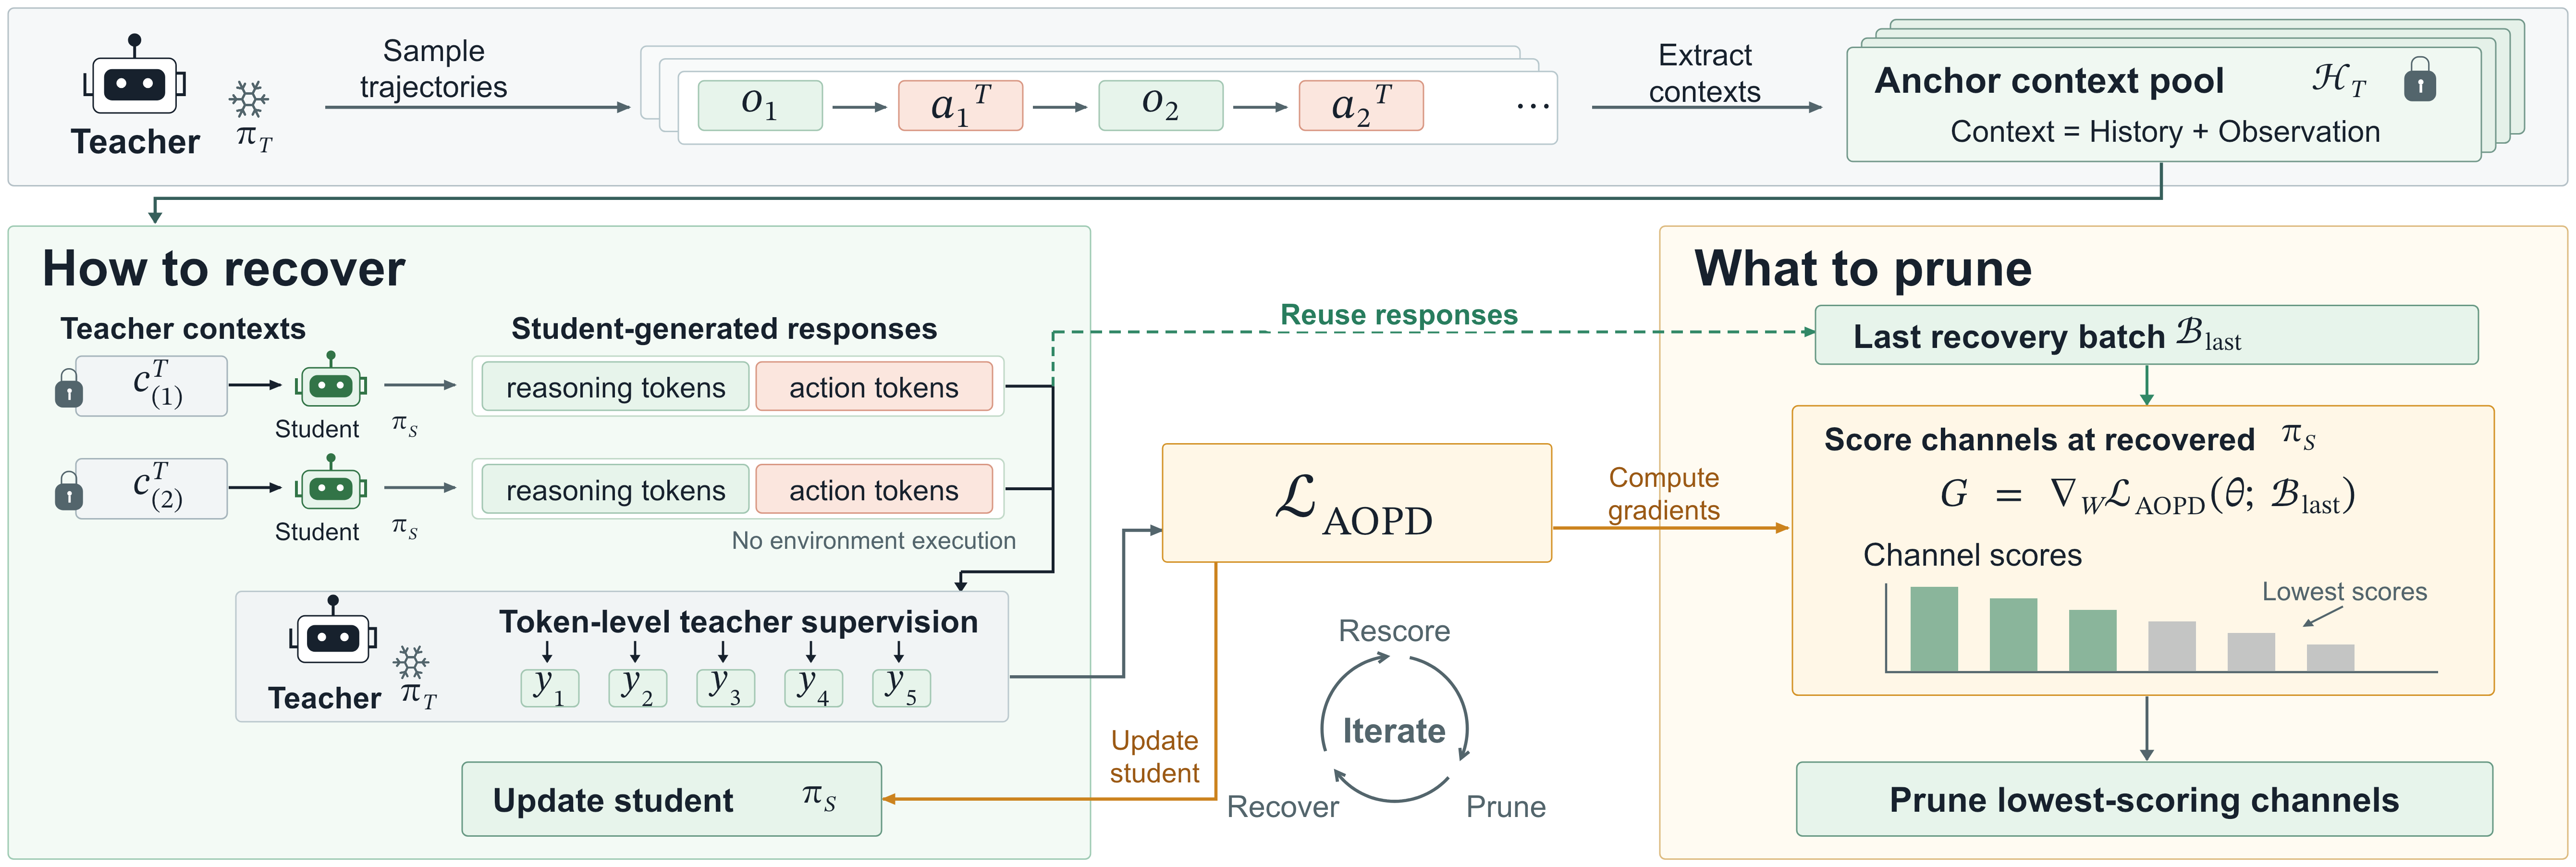
TAP удаляет целые каналы из полносвязных блоков FFN. Метод убирает соответствующие строки и столбцы матриц, поэтому итоговая модель работает через обычные плотные операции на GPU: ей не нужны специальные ядра для разреженных весов.
Канал считают маловажным, если его удаление почти не увеличивает расхождение между ответами учителя и ученика. Для оценки используют градиенты той же функции потерь, по которой затем восстанавливают модель. Так критерий учитывает не общую способность предсказывать текст, а поведение агента в контекстах с наблюдениями, историей и допустимыми действиями.
Одной оценки перед прореживанием недостаточно. После каждого сокращения ученик меняет параметры и частично приспосабливается, поэтому прежний рейтинг каналов устаревает. TAP чередует удаление каналов с восстановлением, а перед следующим шагом пересчитывает их важность на уже адаптированной модели.
На первом шаге учитель и ученик совпадают, из-за чего нужные градиенты равны нулю. TAP временно добавляет небольшой гауссов шум к копии модели, получает начальный рейтинг каналов и применяет его к исходной версии без шума. Это техническая деталь, но без неё общий критерий восстановления нельзя использовать с самого начала.
Почему восстановление держится за траекторию учителя
Обычная дистилляция обучает сокращённую модель на готовых ответах учителя. На развёртывании агент продолжает уже собственные рассуждения, включая неудачные формулировки и действия, которых не было в обучающих данных. Падающая функция потерь поэтому ещё не означает, что агент сохраняет рабочий формат действий.
В одном из опытов с WebShop потери дистилляции сократились примерно на 84%, однако неправильный или отсутствующий блок действия встречался в 87–93% шагов. Модель лучше повторяла распределение учителя на заданных ей последовательностях, но не научилась устойчиво продолжать собственные ответы.
TAP берёт контекст из сохранённой траектории плотного учителя, а полный ответ с рассуждением и действием генерирует ученик. Учитель оценивает каждый следующий токен этого ответа. Сгенерированное действие не выполняют в среде: следующий обучающий контекст снова приходит из траектории учителя.
Так ученик тренируется на собственных префиксах внутри одного ответа, но его ошибка не меняет все последующие состояния. Полные самостоятельные траектории решают первую проблему, однако создают вторую: слабый ученик уводит обучение в состояния, которые учитель не посещал, а ошибки накапливаются между ходами. На длинных эпизодах ALFWorld такой вариант выдавал допустимые действия, но часто не завершал задачу до лимита шагов.
Когда TAP меняет план развёртывания
Метод проверяли на обученных с подкреплением агентах Qwen2.5 двух размеров, в средах ALFWorld и WebShop. Прореживали только каналы FFN, а сравнивали результат с LLM-Pruner, CFSP, SlimGPT и продолжением обучения с подкреплением во время сокращения. Это проверка специализированных агентов на двух интерактивных средах, а не универсальный рецепт сжатия любой LLM.
На WebShop сокращённый агент сохранил 88% успешности плотной модели. Затраты GPU на одну успешно завершённую задачу снизились на 22% в ALFWorld и на 17% в WebShop: метрика учитывает не только ускорение одного вызова, но также дополнительные шаги и неудачные попытки.
Предел показывает самый жёсткий режим прореживания на ALFWorld. Модель отвечала быстрее, но стала делать больше шагов, поэтому полная стоимость успешной задачи выросла. Для агентных систем скорость генерации нужно проверять вместе с длиной траектории и долей завершённых задач, иначе локальное ускорение даст неверный прогноз затрат.
TAP меняет план команд, у которых уже есть плотный учитель, узкая задача и набор успешных траекторий. В таком случае стоит закладывать поэтапное удаление каналов, восстановление на собственных ответах и повторный расчёт маски вместо одноразового прореживания с обычной дистилляцией.
Если рабочая среда часто приводит агента в состояния за пределами траекторий учителя, одного якорного восстановления недостаточно: оно не обучает модель на каждом контексте, который встретится после развёртывания. Такой сценарий требует отдельной проверки на полных самостоятельных траекториях до выбора целевого размера модели.
Источники
Иллюстрация: рисунок из статьи «TAP: Efficient Long-Horizon Agent Pruning via Trajectory-Anchored Recovery», Yuanzhe Li, Pengxin Wang, Yuxin Ren и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


