
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
При обучении LLM на длинных ответах расхождения между моделью, которая собрала примеры, и обновлённой моделью накапливаются по всему пути, даже если разница на каждом токене остаётся небольшой. Работа Tsinghua University и ByteDance Seed показала, что учёт этого накопления повышает средний результат Qwen3-8B на математике на 48%, а на коде — на 12% относительно GRPO, хотя препринт не рецензирован, а числа получили сами авторы. Для команд, которые обучают модели рассуждать на длинных траекториях, TAPO предлагает заменить локальный контроль обновлений на контроль всего пройденного пути.
Почему контроль каждого токена не удерживает весь ответ
При обучении с подкреплением модель сначала генерирует ответы, а затем обновляется по полученной награде. Примеры собирает прежняя версия модели, а градиент применяют уже к новой. Поэтому вероятности токенов в обучающей выборке не полностью соответствуют текущей модели.
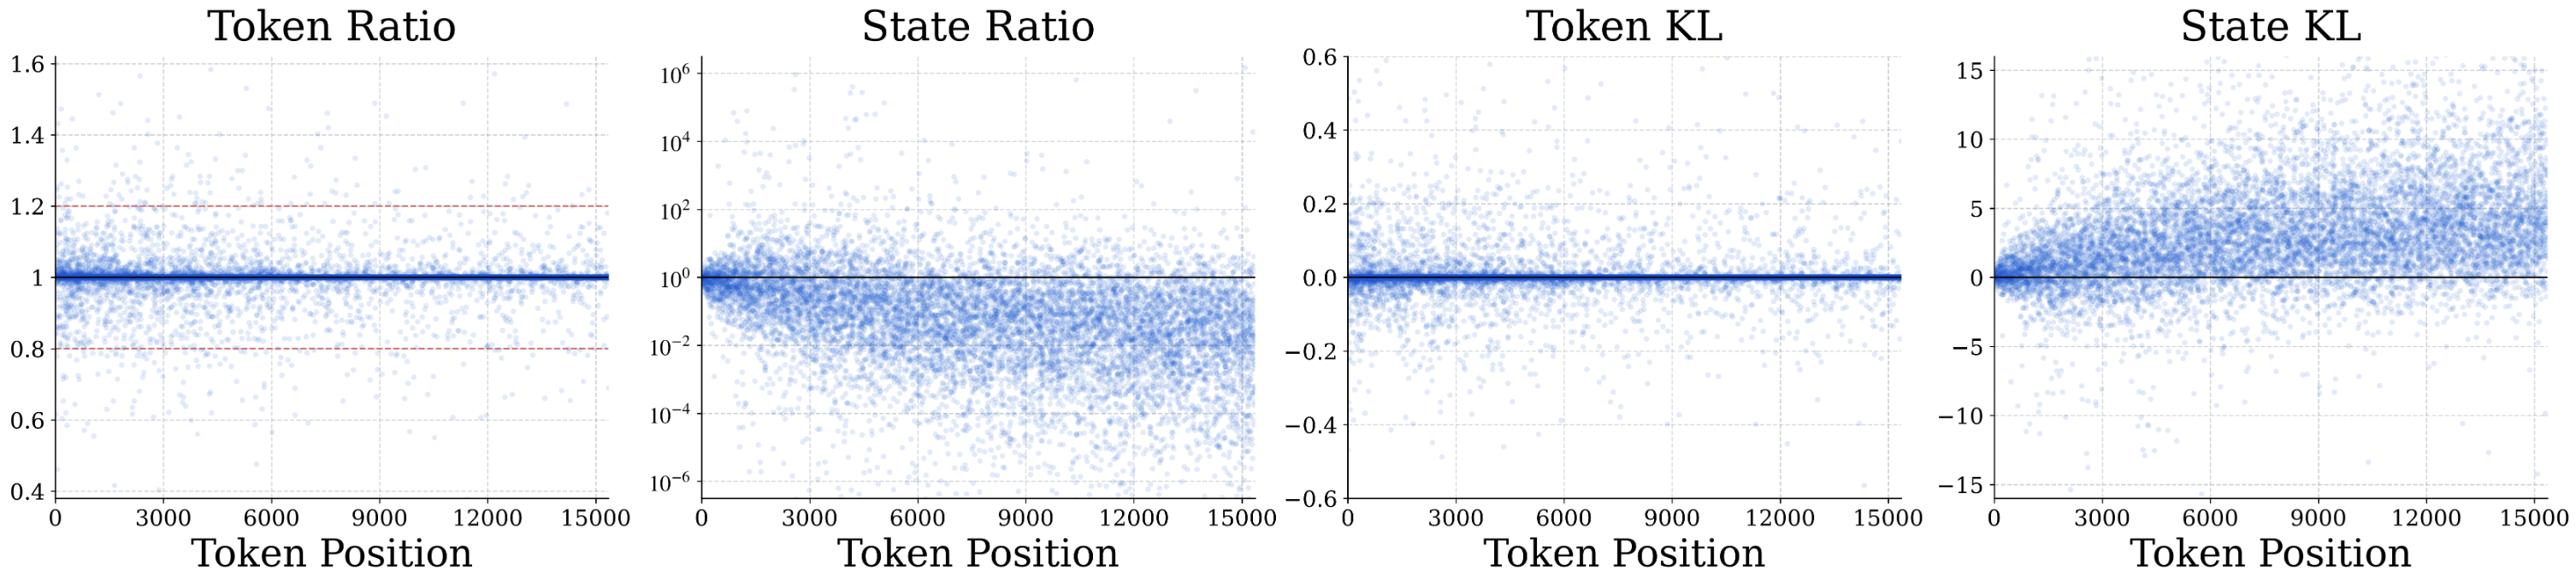
GRPO поправляет это расхождение отдельно для каждого токена. Метод сравнивает вероятность текущего токена у старой и новой моделей, но не учитывает, как предыдущие расхождения привели модель именно к этому месту ответа.
Для авторегрессионной LLM состояние задают запрос и весь уже сгенерированный префикс. Даже небольшое изменение раннего токена переводит продолжение на другую ветвь: поздние токены новая модель выбирает уже в состояниях, которые старая модель посещала с иной вероятностью. На длинном ответе такой сдвиг накапливается.
GSPO рассматривает весь ответ как единое действие и назначает ему общее отношение вероятностей. Это учитывает последовательность целиком, но одинаково ограничивает все её участки. Проблемный поздний фрагмент и устойчивый ранний фрагмент получают одну поправку, хотя путь к ним различается.
Как TAPO поправляет сдвиг и что дали замеры
TAPO вычисляет для каждого токена отдельную поправку по всему предшествующему пути. Отношения вероятностей накапливаются от начала ответа до текущей позиции, поэтому вес токена зависит не только от локального выбора, но и от того, насколько старая и новая модели разошлись раньше.
Прямое произведение отношений быстро становится нестабильным: несколько отклонений подряд дают слишком большой или слишком малый вес. TAPO вместо него берёт геометрическое среднее — перемножает отношения и извлекает корень по числу пройденных шагов. Так разброс поправки сокращается по мере удлинения траектории.
Метод также меняет допустимый диапазон обновления по ходу ответа. В начале границы шире, чтобы модель могла исследовать варианты, а ближе к концу сужаются. Разбор отдельных компонентов показал, что прямое произведение отношений и постоянные границы приводили к нестабильности или замедляли рост результата.
На Qwen3-8B средняя оценка TAPO по математическим задачам составила 41,0 против 40,5 у сильнейшего конкурента RIPO. На задачах по коду методы получили 58,6 и 57,2 соответственно. Большая прибавка относительно GRPO поэтому показывает преимущество над распространённой базовой схемой, а отрыв от лучшего из проверенных вариантов остаётся умеренным.
Когда команде стоит менять план обучения
Работу проверяли на трёх размерах Qwen3. Основные опыты охватывали восемь соревновательных наборов по математике и алгоритмическому программированию, а ответы могли достигать 20 тысяч токенов. Модель получала единицу за правильный итог и ноль за ошибочный, поэтому выводы напрямую относятся к задачам с автоматически проверяемым результатом.
TAPO заслуживает отдельного эксперимента, если обучение на GRPO или GSPO начинает срываться после увеличения длины ответа. Характерный признак — локальные отношения вероятностей выглядят приемлемо, но расхождение между старой и новой моделями растёт, а награда после первоначального подъёма падает.
Для реализации нужны вероятности токенов у модели, собравшей ответы, и у обновляемой модели. По ним система считает накопленную поправку для каждого префикса и меняет границы обновления в зависимости от позиции. Это изменение оптимизатора, а не архитектуры модели или способа выставлять итоговую награду.
Работа не даёт оснований менять устойчивый конвейер только ради средней оценки. На основной модели TAPO лишь немного обошёл RIPO, а проверка охватывает длинные решения с однозначно проверяемым ответом. Практический план — сопоставить методы при той длине, числе обновлений и типе награды, которые использует продукт, и отдельно следить за расхождением моделей по мере роста ответа.
Источники
Иллюстрация: рисунок из статьи «Trajectory-Aware Policy Optimization: Closing the State Distribution Gap in Long-Horizon LLM RL», Zhicheng Cai, Weinan Dai, Yuyan Zhou и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


