
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Знание, полученное при дообучении одной модели, удалось перенести в модель с другой архитектурой и сложить с результатом другого дообучения. В препринте TelePIX, который не рецензировался и приводит замеры самих авторов, такой перенос сохранил 74–80% прибавки от дескрипторов самой целевой модели. Это предлагает альтернативу обычной арифметике весов, где исходные и целевые модели должны иметь одинаковое устройство.
Дескриптор записывает поведение вместо изменения весов
Обычный вектор задачи — это разница между весами модели до и после дообучения. Его можно прибавить к исходной модели, вычесть или сложить с другим вектором, но операции имеют смысл только для совместимых наборов параметров. Между CLIP и моделью с другим зрительным кодировщиком общей системы координат нет.
Junghwan Park и Woojin Cho заменили разницу весов универсальным дескриптором задачи. Для набора изображений и текстовых названий классов он записывает, как после дообучения изменилась косинусная близость между их представлениями. Это число показывает, насколько близкими модель считает изображение и текстовый запрос.
Дескриптор представляет собой матрицу: строки соответствуют пробным изображениям, столбцы — запросам с названиями классов. Её размер не зависит от архитектуры и размерности внутренних представлений модели. Разные модели поэтому могут описывать эффект одной задачи в общей форме, даже если их веса нельзя сопоставить.
Для создания дескриптора нужны исходная и дообученная версии модели. Вместе с дескриптором в целевую систему передают пробные изображения и названия классов, но метки для отдельных изображений не нужны. Целевая модель должна изменить своё поведение на этих примерах так, чтобы воспроизвести заданные сдвиги близости.
Перенос сводится к правке последнего слоя или адаптеру
Первый способ ищет линейный оператор, который сдвигает представления изображений в нужную сторону. Его находят решением задачи наименьших квадратов с регуляризацией, а затем включают в последний проекционный слой целевой модели. Архитектура, число параметров и стоимость работы модели после этого не меняются.
Для каждой пары источника и задачи оператор можно вычислить заранее и сохранить в банке. Чтобы совместить несколько задач, операторы складывают со знаком плюс или минус и задают силу каждого эффекта коэффициентом. Повторно обучать модель для новой комбинации не требуется.
У этого подхода есть допущение: нужное изменение поведения можно достаточно хорошо выразить одной линейной правкой. Дескриптор также видит только ту часть изменения, которая проявляется через выбранные изображения и текстовые запросы.
Второй способ обучает низкоранговый адаптер целевого кодировщика по той же цели. Он может менять каждый слой и сразу подгоняет совместный эффект нескольких задач, поэтому описывает более сложные преобразования. Цена этой гибкости — отдельная оптимизация для каждой новой комбинации и отсутствие переиспользуемого банка операторов.
В обоих вариантах передавать веса исходной модели не требуется. Но это не извлечение абстрактного навыка из произвольной нейросети: метод опирается на парные кодировщики, которые сопоставляют изображения или звук с текстом, и в опытах менялась нетекстовая часть модели.
Метод расширяет выбор моделей, но пока не заменяет дообучение
Метод проверили на шести семействах моделей и восьми задачах классификации. При сложении двух задач целевая модель в среднем получила прибавку на 18,1 и 11,6 процентного пункта, потеряв около 2 пунктов на контрольном CIFAR-100. Вычитание дескриптора также удаляло освоенную задачу, хотя при слишком сильной правке начинало портить контрольные результаты.
Проверка охватила модели с разными проекционными слоями и головы с остаточными связями. Отдельные опыты перенесли композицию на набор спутниковых снимков, который не участвовал в подборе правки, и повторили подход для моделей, сопоставляющих звук с текстом. При этом текстовый кодировщик оставался фиксированным, а все основные задачи относились к классификации.
Работа меняет планы команд, которым нужно поддерживать несколько совместимых зрительно-языковых моделей или собирать продукт из дообучений, выполненных разными поставщиками. Вместо требования к единой архитектуре можно хранить дескрипторы, пробные наборы и готовые операторы для каждой целевой модели.
Это пока не основание заменять обычное дообучение во всём стеке. Дескриптор передаёт лишь часть эффекта собственного дообучения целевой модели, а линейная правка зависит от того, насколько задача выражается через выбранные запросы. Практический первый шаг — проверить метод на одной паре уже используемых моделей и измерить не только целевую метрику, но и потери на контрольных данных.
Источники
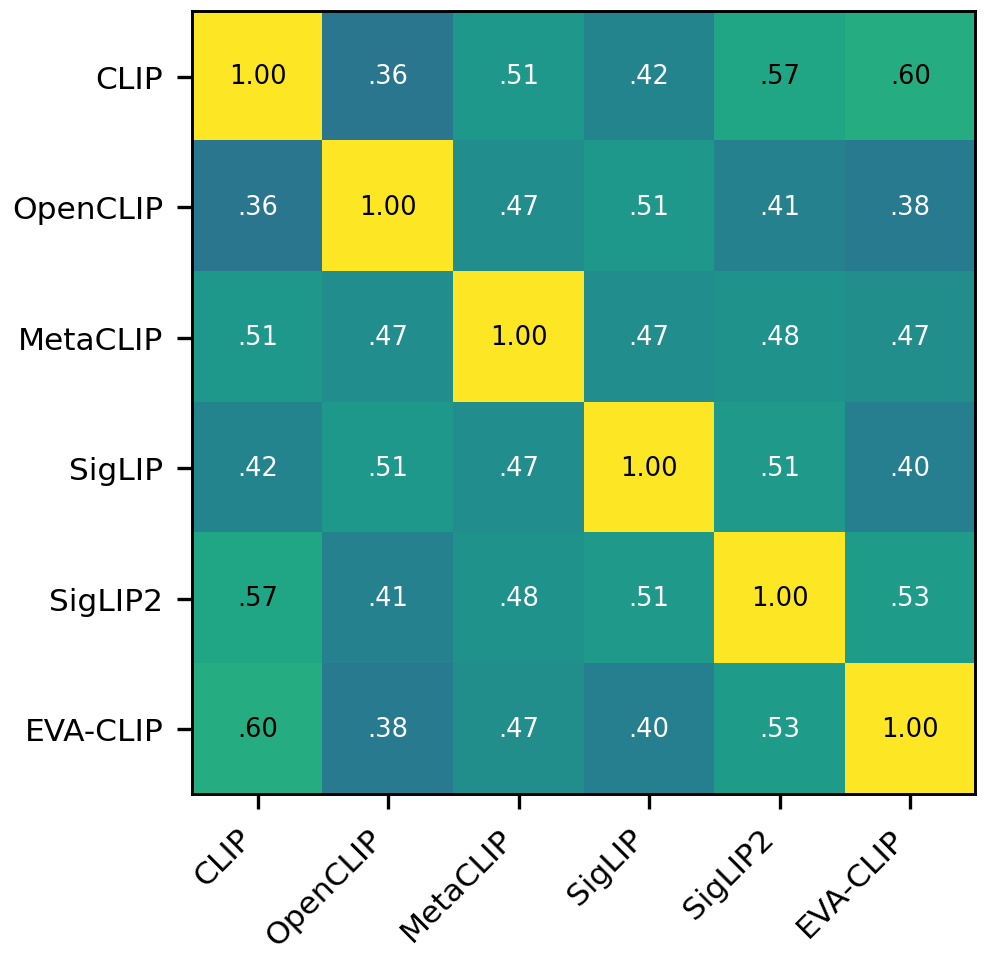
Иллюстрация: рисунок из статьи «Platonic Task Arithmetic», Junghwan Park, Woojin Cho, CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


