
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
В TasteVal модель Opus 5.5 выбирала эксперименты эффективнее профильных исследователей. Oliver Jaffe и Dane Sherburn получили множитель вычислений 2,3, хотя работа не рецензирована и числа получили сами авторы. Это означает, что при фиксированном оборудовании модель достигала экспертного результата более чем вдвое быстрее.
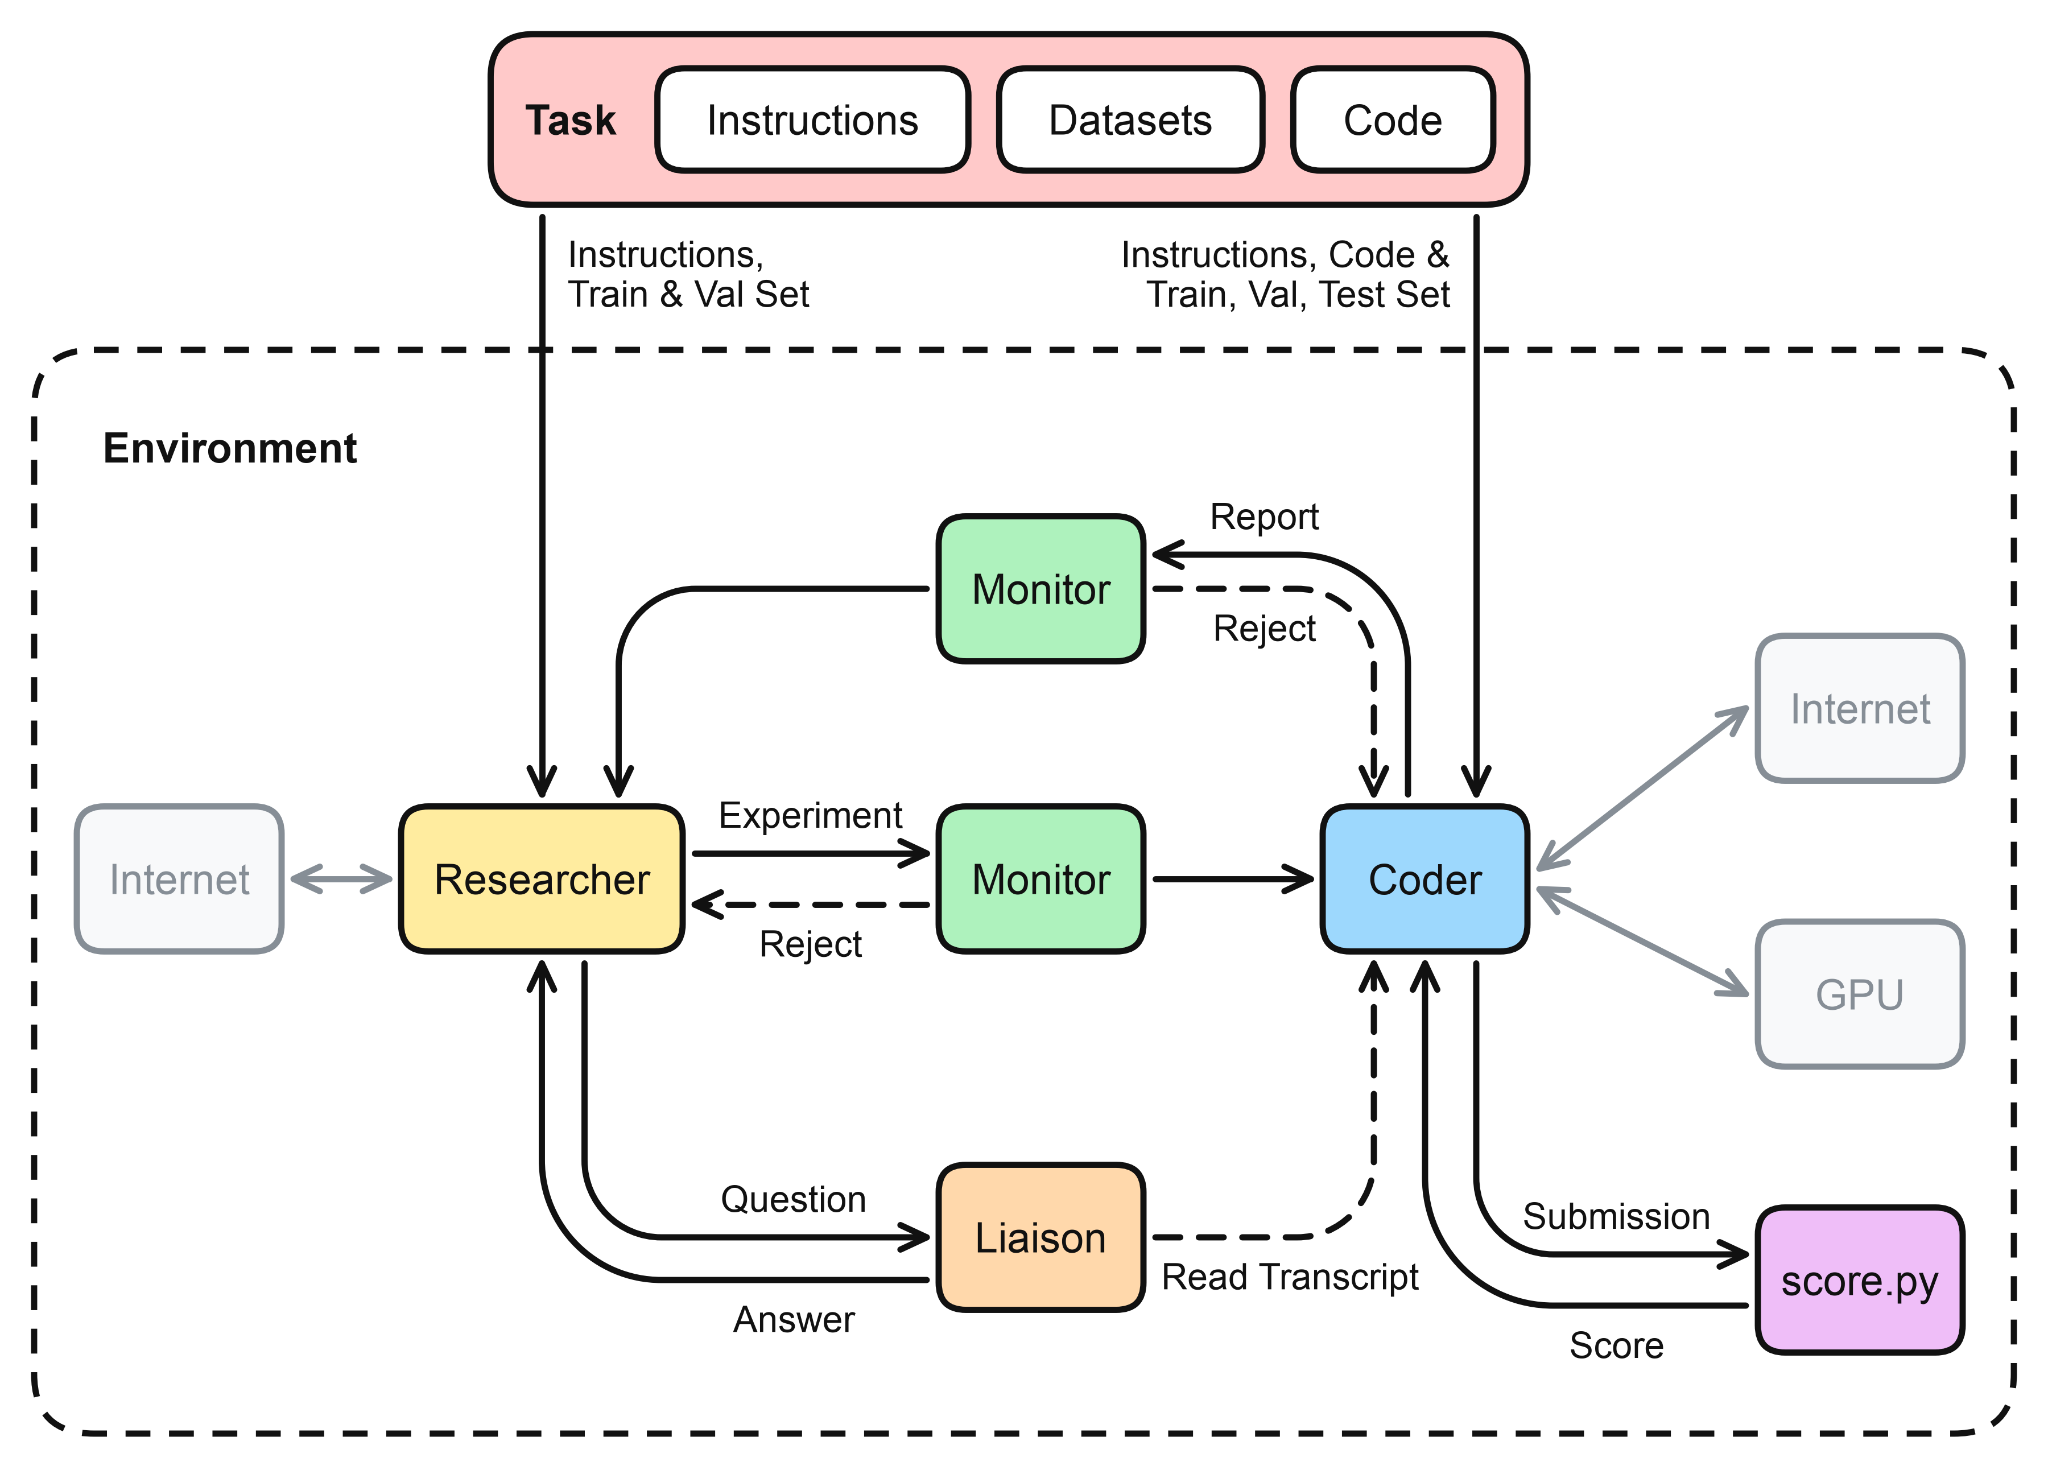
Авторы отделили исследовательские решения от программирования. Проверяемая модель ставила задачи, выбирала следующий эксперимент и разбирала результат, а один и тот же агент Opus 4.8 писал код и запускал его. Такой подход измеряет не умение реализовать идею, а способность решить, какую идею стоит проверить следующей.
Главная метрика показывает, сколько последовательного времени на GPU нужно модели относительно эксперта. Если эксперт достигает результата за весь доступный бюджет, а модель — за половину, её множитель равен двум. У передовых моделей этот показатель с декабря 2025 года удваивался примерно каждые три месяца против 14 месяцев раньше. При этом итоговое качество без учёта потраченных вычислений продолжало расти прежним темпом: ускорился именно поиск полезных экспериментов, а не конечный результат.
Проверка охватила восемь новых задач AI R&D и 20 моделей. В качестве человеческой базы выступили 24 специалиста, причём для каждой задачи брали лучший результат. Каждый участник работал с одним H100 и мог потратить на эксперименты до 40 часов работы GPU.
Задачи охватывали подготовку данных, обучение и дообучение моделей, моделирование человеческих предпочтений и защиту от враждебных запросов. Они давали быструю и однозначную обратную связь, поэтому TasteVal пока измеряет короткие циклы оптимизации, а не выбор исследовательской проблемы или поиск принципиально новой идеи. Для планирования автоматизированной AI R&D результат скорее обосновывает ускорение перебора экспериментов, чем замену исследовательской команды целиком.
Источники
Иллюстрация: рисунок из статьи «TasteVal: Measuring the Experimental Research Taste of AI Systems Against Human Experts», Oliver Jaffe, Dane Sherburn, CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


