
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Историю взаимодействий для обучения с подкреплением в контексте можно сжать без потери первых шагов оценки стратегии. В одной задаче контекст с ошибкой 10−2 занял на 88,7% меньше памяти, чем разреженная статистика TD, хотя препринт не прошёл рецензирование и числа получили сами авторы. Для таких систем память может зависеть от числа независимых направлений обновления, а не от длины траектории.
Работа Yajie Zhao, Yingjun Mo и коллег рассматривает оценку фиксированной стратегии по временным разностям, или TD. Encoder с фиксированными параметрами получает исходные переходы, собирает из них модель переходов и наград, а затем оставляет только базис направлений, по которым меняются оценки состояний. Вся процедура проходит внутри Transformer без обновления его параметров.
Минимальный размер точного контекста равен размерности пространства Крылова — числу линейно независимых направлений, которые порождают последовательные TD-обновления. Если это число равно kL, сохранить первые L шагов в контексте меньшей размерности нельзя. Для непрерывных точных представлений необходимая память растёт как Θ(nkL), где n — число состояний; предложенная конструкция укладывается в двукратную границу от оптимума.
Ниже порога точность убывает предсказуемо. Лучшая возможная ошибка имеет порядок γ^m max{1, 1/[m(1−γ)]}, где m — размер контекста, а γ задаёт, насколько сильно учитываются будущие награды. Чем ближе γ к единице, тем больше контекста нужно для той же ошибки. Низкий численный ранг позволяет отбросить почти зависимые направления, даже когда точный ранг остаётся полным.
Теорию и конструкцию проверяли на конечных марковских процессах с полным покрытием состояний, блочных циклах, обратимых процессах, Boyan’s chain и mountain car с признаками. Сравнение охватывает точное воспроизведение всех промежуточных TD-оценок, а не только итогового ответа. Результат относится к оценке фиксированной стратегии; перенос той же границы памяти на выбор действий работа не устанавливает.
Источники
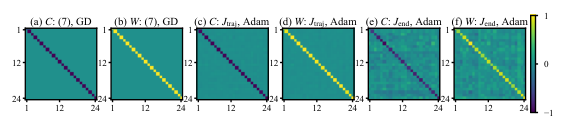
Иллюстрация: рисунок из статьи «Provable Transformer Context Compression for In-Context Reinforcement Learning», Yajie Zhao, Yingjun Mo, Zhiyong Wang и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


