
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
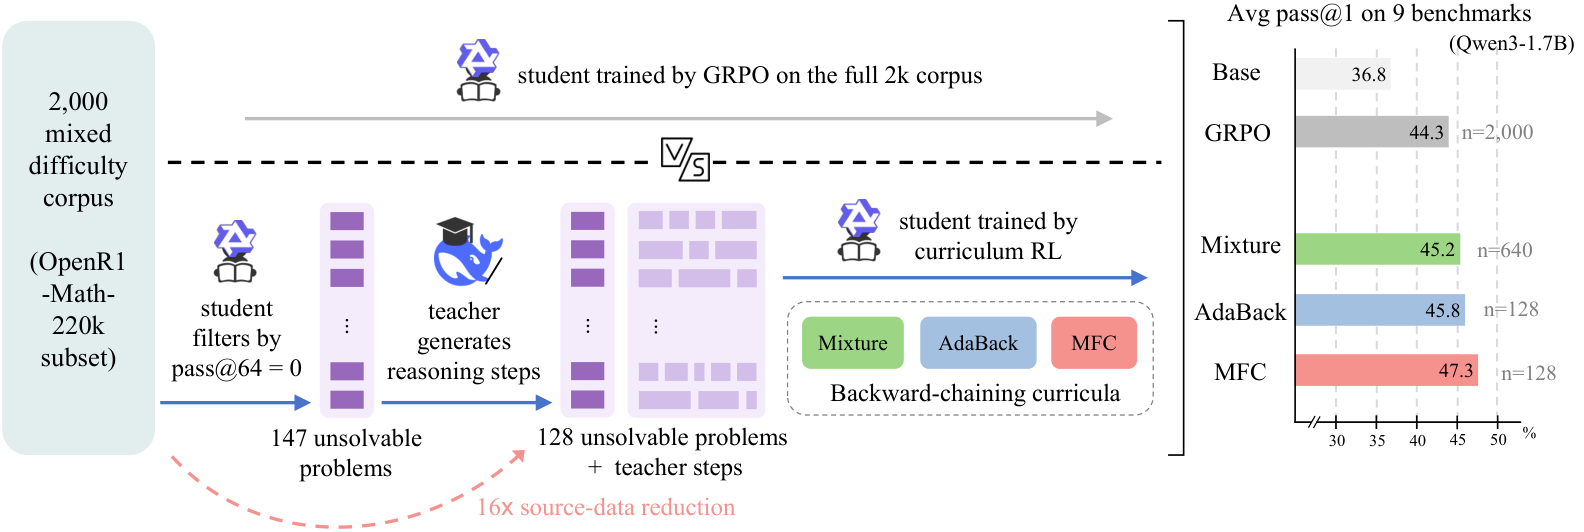
Полностью провальные для LLM задачи можно превратить из бесполезной части набора данных в материал для обучения. В работе Yukang Zhu и Zhen Han, которая не прошла рецензирование и приводит замеры самих авторов, обучение на тщательно выбранном наборе в 16 раз меньше сравнялось с обычным GRPO или превзошло его. Для этого сильная модель постепенно подводит слабую к решению, а затем подсказку убирают.
Почему сложная задача не всегда помогает учиться
Обучение с подкреплением по проверяемой награде (RLVR) удобно для математики: ответ можно проверить автоматически, не привлекая человека. Один из распространённых алгоритмов, GRPO, генерирует для каждой задачи группу решений и сравнивает их награды между собой.
Если все восемь решений ошибочны, сравнивать нечего: каждое получает одинаковую награду, относительное преимущество исчезает, а задача почти не влияет на обновление модели. Поэтому самые трудные примеры могут занимать место в наборе, но не давать обучающего сигнала.
Авторы назвали задачу неразрешимой, если базовая модель не нашла правильный ответ за 64 независимые попытки. Для Qwen3-1.7B под это определение попали 147 задач из корпуса на 2 000 конкурсных математических примеров. Это не утверждение, что модель никогда не решит задачу: речь идёт о практической границе при заданном бюджете генераций.
Обычное обучение не устранило проблему автоматически. К концу запуска больше 75% исходно неразрешимых задач всё ещё не дали ни одного успешного решения. Рост общих способностей сделал полезной только небольшую часть этой группы.
Частичная цепочка рассуждений создаёт промежуточную сложность
Для каждой трудной задачи DeepSeek-V3.2 сгенерировала структурированную цепочку рассуждений. Студент получал первые шаги этой цепочки как подсказку, но должен был заново вывести и записать полное решение.
Длина открытой части управляла сложностью. Без подсказки Qwen3-1.7B почти всегда ошибалась; после показа четверти цепочки доля задач хотя бы с одним успешным ответом среди восьми попыток выросла с 2,2% до 34%. Полная цепочка подняла её до 85,4%.
Одна исходно провальная задача так превращается в ряд состояний: от почти готового решения до исходного условия. Учебная программа идёт в обратную сторону — сначала модель работает с заметной подсказкой, затем получает всё меньше шагов и в конце решает задачу самостоятельно.
Главная сложность здесь — несовпадение обучения и использования. Подсказки присутствуют во время обучения, но на проверке их нет. Если алгоритм задерживается на удобном уровне помощи, модель учится продолжать чужое рассуждение, а не начинать своё.
Метод MFC хранит для каждой задачи верхнюю границу подсказки. Он случайно выбирает длину цепочки от нуля до этой границы и уменьшает её, когда студент успешно справляется с меньшей помощью. Ошибка не возвращает границу назад: неудача сегодня не доказывает, что тот же уровень останется недоступным после следующих обновлений.
Менять весь процесс обучения рано, но отбор данных уже можно пересмотреть
На Qwen3-1.7B средний результат MFC по девяти наборам составил 47,3% против 44,3% у GRPO на полном смешанном корпусе. Обычное обучение с учителем, SFT, на полных цепочках учителя дало 39,8%. Значит, выигрыш нельзя свести к запоминанию одного готового решения: модель должна получать проверяемую награду и доходить до режима без подсказки.
Тот же порядок результатов сохранился на меньшей Qwen3-0.6B. Все алгоритмы обучали при сопоставимых вычислительных условиях, поэтому сравнение показывает эффект отбора задач и управления подсказкой, а не большего числа шагов.
Проверка охватывает две базовые модели Qwen, конкурсную математику и перенос на математические и отдельные научные наборы. Учителем во всех опытах служила DeepSeek-V3.2. Работа не устанавливает, сохранится ли эффект в генерации кода, доказательстве теорем или агентных сценариях с инструментами.
Для команд, которые уже обучают модели на автоматически проверяемых ответах, практический вывод касается конвейера данных. Полностью провальные примеры не обязательно удалять: их можно отдельно найти большим числом пробных генераций, построить для них цепочки сильной моделью и снижать объём подсказки по мере успехов студента.
MFC пока не выглядит универсальной заменой GRPO. Он решает более узкую задачу: извлекает сигнал из небольшого пула примеров, где стандартная групповая награда вырождается. Если продукт работает в области с однозначной автоматической проверкой и доступным сильным учителем, такой контур стоит испытать до расширения обучающего корпуса.
Источники
Иллюстрация: рисунок из статьи «Unlocking the Unsolvable: Teacher-Guided Curriculum for Data-Efficient RLVR», Yukang Zhu, Zhen Han, CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


