
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
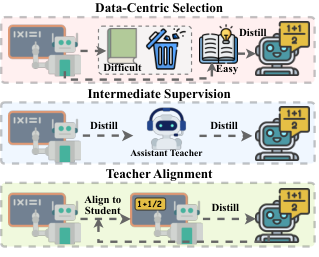
Большую модель-учителя научили подстраивать ход рассуждений под меньшую модель, не копируя ошибки ученика и не отбрасывая сложные примеры. В препринте команды из University of Virginia, Netflix, University of Washington, Florida State University и Microsoft, который не прошёл рецензирование, а все числа в нём получили сами авторы, TeacherGRPO повысил среднюю точность ученика семейства Qwen на 7,4 процентного пункта. Метод предлагает дополнительный этап перед обычной дистилляцией и рассчитан на команды, которые могут обучать учителя, а не только вызывать его через API.
Почему более сильный учитель может дать худшего ученика
При дистилляции малая модель учится воспроизводить ответы и распределения вероятностей большой. Но сложный учитель использует переходы и цепочки рассуждений, которые ученик с меньшим числом параметров не способен точно представить. Авторы называют это проклятием разрыва: дальнейшее усиление учителя перестаёт улучшать ученика и иногда вредит ему.
Один из обходных путей — удалить примеры, на которых модели расходятся сильнее всего. Другой — поставить между ними промежуточную модель. Первый подход лишает ученика сложных данных, второй снижает качество исходного сигнала.
Прямое сближение распределений тоже оказалось нестабильным. В предварительном опыте на Date Understanding точность ученика Qwen сначала дошла до 38,5%, а затем упала до 29,0%. Одновременно точность учителя снизилась с 59,2% до 43,8%: он начал перенимать ограничения и ошибки ученика.
Обычная групповая относительная оптимизация стратегии GRPO сохраняла способности учителя, но передавала знания хуже. TeacherGRPO меняет не сам конвейер дистилляции, а подготовку учителя: тот ищет правильные рассуждения, которые доступны ученику, вместо точного копирования его распределения.
Как награда отделяет важный шаг от лишнего текста
TeacherGRPO сравнивает распределения вероятностей учителя и ученика не для всех позиций сразу. Сначала он выбирает токены, на которых модели расходятся сильнее всего. Такие места часто совпадают с логическими переходами, промежуточными состояниями и точками выбора, тогда как шаблонные фразы почти не помогают обучению.
Охват расширяется по мере обучения. На ранней стадии награда учитывает самые заметные расхождения, затем добавляет менее выраженные. Тот же принцип действует внутри словаря: сначала метод сравнивает варианты продолжения с наибольшей разницей вероятностей, а не шумный хвост, где обе модели не уверены.
Вторая часть метода сдерживает многословие. Простой штраф за длину способен удалить необходимый шаг вместе с повторениями, поэтому TeacherGRPO оценивает важность каждого фрагмента по неопределённости обеих моделей. Рутинные и длинные продолжения получают больший штраф, а трудные переходы сохраняются.
К награде добавлена проверка правильности ответа. Обновления также ограничены относительно исходного учителя, чтобы адаптация не разрушила его способности. После этого выровненный учитель используется в обычных конвейерах дистилляции; менять сам способ обучения ученика не требуется.
Когда стоит менять конвейер дистилляции
На моделях семейства Gemma средняя прибавка к обычной дистилляции составила 3,6 процентного пункта. В сравнении с отбором более лёгких данных TeacherGRPO выиграл 4,3 пункта, а у схемы с промежуточным учителем — 3,4 пункта. Улучшения сохранились при дистилляции распределений, последовательностей и обучении на ответах вне текущей стратегии ученика.
Проверка охватила пары Qwen2.5-3B-Instruct и Qwen2.5-0.5B-Instruct, а также Gemma-3-1b-it и Gemma-3-270m-it. Основные задачи проверяли понимание дат, многошаговые факты, естественные науки и здравый смысл; отдельно метод испытали на MATH. Это результаты для небольших моделей и задач с проверяемым ответом, а не подтверждение масштабирования на крупные производственные пары.
Схема подходит, если команда располагает весами обеих моделей, видит их распределения вероятностей и может дополнительно обучать учителя. Для учителя, доступного только через закрытый API, реализовать такую награду нельзя без отдельного доступа к его внутренним вероятностям и параметрам.
TeacherGRPO добавляет отдельную фазу обучения перед дистилляцией. Её можно провести через LoRA и затем использовать подготовленного учителя для нескольких учеников, но в работе затраты не выражены в GPU-часах. Поэтому практический следующий шаг — пилот на собственной паре моделей с одновременным замером точности, длины ответов и полной стоимости обучения.
Источники
Иллюстрация: рисунок из статьи «TeacherGRPO: Closing the Capacity Gap in Reasoning Distillation via Teacher Alignment», Zhenyu Lei, Zihan Chen, Yaochen Zhu и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


