
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Дорогую часть обучения нейросети можно перенести в конец запуска и сохранить итоговое качество. В препринте Temperon, который не прошёл рецензирование и содержит замеры самих авторов, такой режим достиг качества постоянного SAM примерно на треть быстрее. Для команды это меняет не выбор архитектуры, а распределение вычислительного бюджета внутри уже запланированного обучения.
Почему SAM нужен модели ближе к концу обучения
Минимизация с учётом резкости (SAM) ищет параметры, рядом с которыми функция потерь меняется плавнее. Для этого алгоритм сначала делает шаг в сторону ухудшения, а затем обновляет веса, поэтому каждый затронутый им шаг требует примерно вдвое больше вычислений.
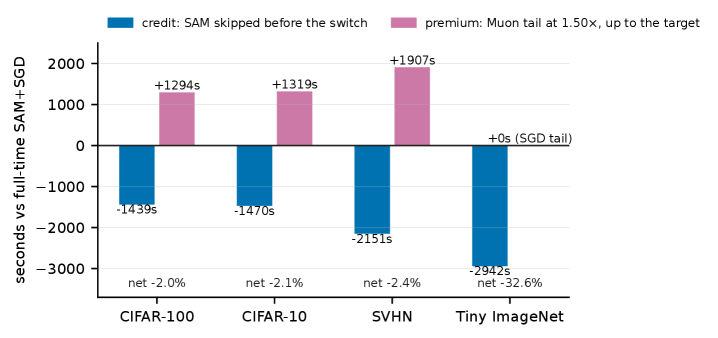
Temperon не платит эту надбавку на всём протяжении запуска. Первые 43% бюджета модель обучается с обычным Nesterov SGD, затем один раз переключается на Muon, обёрнутый в SAM. Новый оптимизатор наследует накопленный импульс, а скорость обучения и радиус возмущения растут плавно, чтобы переключение не вызвало скачок функции потерь.
Дорогой этап получает целиком финальное косинусное снижение скорости обучения. Это принципиальная часть рецепта: во время такого расписания качество сначала выходит на плато, а затем растёт ближе к концу. Правило, которое смотрит только на прошлую динамику, принимает плато за остановку прогресса и включает дорогой режим слишком рано.
Muon здесь отвечает не только за стоимость. Его эпоха обходилась в 1,5 раза дороже эпохи SAM с SGD, но именно Muon поднимал достижимое качество. Экономия на ранних шагах SAM компенсировала эту надбавку в финальной фазе.
Muon повысил потолок качества, а форма раннего этапа не помогла
На CIFAR-100, CIFAR-10 и Tiny ImageNet Temperon достиг самой трудной общей цели соответственно на 35%, 34% и 32% быстрее постоянного SAM. На SVHN преимущества по времени не получилось: полный дорогой режим пересёк выбранную цель ещё до финального снижения скорости обучения.
Авторы сравнивали варианты в одном программном конвейере и на одном GPU. Время считали не по секундомеру занятой рабочей станции, а умножали число эпох до цели на отдельно измеренную стоимость эпохи при свободном GPU. Такой подход отделяет различия оптимизаторов от фоновой нагрузки компьютера.
Контрольные эксперименты показали, откуда взялся результат. Замена Muon на SGD при неизменной схеме снизила точность на 0,85 процентного пункта. Циклическое расписание раннего этапа и перезапуски скорости обучения измеримого выигрыша не дали, поэтому их нельзя считать механизмом Temperon.
Ближайший конкурент — SAM, включённый поздно, но оставшийся на SGD, — быстрее достигал промежуточных целей на всех наборах. Однако на CIFAR-100 и CIFAR-10 он не доходил до уровня, который открывал Muon. На Tiny ImageNet Muon такого уровня не создал, и более простой конкурент выиграл и по итоговому качеству, и по времени.
Та же схема сократила время предварительного обучения GPT-2 на 29% относительно постоянного SAM при сопоставимой функции потерь. В дообучении RoBERTa на задачах GLUE дорогой режим работал лишь в финальной части и нигде не уступил постоянному SAM, хотя сам SAM в этих экспериментах не улучшил результат относительно запуска без него.
Планы стоит менять только ради качества выше потолка SGD
Temperon не ускоряет цель, которую дешёвый оптимизатор и так достигает. Если продукту достаточно промежуточного качества, разумнее оставить SGD или включить SAM только в конце без перехода на Muon. Дополнительная сложность оправдана, когда Muon выводит модель на уровень, недоступный вариантам с SGD.
Проверить это можно двумя запусками: сначала получить итог дешёвого базового варианта, затем провести короткую пробу Muon до плановой точки переключения. Ранняя динамика внутри одного запуска не предсказывает пользу финального этапа: на Tiny ImageNet Muon выглядел хорошо в начале, но проиграл после полного обучения.
Точку переключения лучше привязывать к началу последнего снижения скорости обучения, а не к остановке роста метрики. Это упрощает планирование вычислений: команда заранее знает длительность дешёвой и дорогой фаз, может оценить их стоимость и не строит отдельный контроллер для переключения оптимизаторов.
Масштаб проверки охватывает расширенную ResNet-110 на наборах изображений, GPT-2 124M на WikiText-103 с одним запуском и RoBERTa-base на GLUE. Поэтому рецепт уже подходит для контролируемой проверки в собственном конвейере, но не доказывает ту же экономию на крупных LLM или других дорогих режимах обучения.
Источники
Иллюстрация: рисунок из статьи «Temperon: Full-Time SAM Quality at a Third Less Wall-Clock», Stamatis Mastromichalakis, CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


