
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Терминального агента научили продолжать работу после первого решения: собирать свидетельства, менять стратегию по обратной связи и доводить результат до готового артефакта. В препринте, который не прошёл рецензирование и содержит замеры самих авторов, обученная модель обошла исходную Qwen3.5-27B во всех выбранных тестах. Для команд, которые обучают агентов самостоятельно, работа смещает фокус с количества команд в датасете на связи между исследованием, реализацией и проверкой.
Среда не должна выполнять задачу за агента
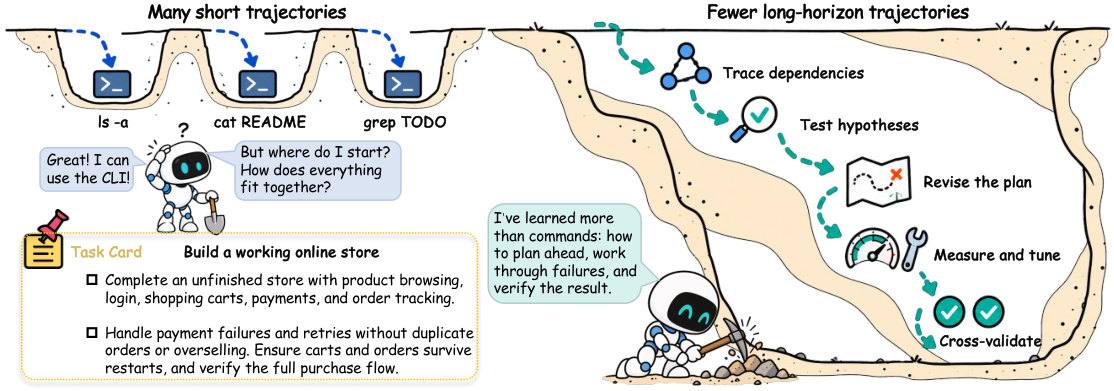
Траектория здесь — последовательность действий агента, ответов терминала и следующих решений. Короткая траектория показывает, как вызвать инструмент или исправить отдельную ошибку, но не учит пересматривать ранний вывод после поздней проверки.
Главная проблема синтетических сред возникает ещё до обучения. Конструктор может положить в исходные файлы готовый анализ, реализовать ключевую функцию или упростить связи между объектами. Формально задача остаётся сложной, но агенту достаточно найти нужное место и поменять константу.
TerminalHorizon начинает с реальной профессиональной работы. Отдельные агенты изучают документацию, репозитории, отчёты об ошибках и другие материалы, затем собирают исполняемую задачу: публичную инструкцию, начальное состояние, инструменты, эталонное решение и закрытую проверку результата.
После этого задачу получает независимый агент, который не видел материалов конструктора и эталонного решения. Его действия показывают, сохранилась ли в среде содержательная работа. Если реализация, диагностика или проверка уже сделаны заранее, конструктор меняет исходное состояние и снова запускает независимое решение.
Принятую задачу затем расширяют, не меняя конечную цель. Новые требования опираются на ранние результаты: собранные сведения влияют на дальнейший выбор, созданный артефакт приходится улучшать, а обратная связь заставляет вернуться к предыдущему решению. Так длина появляется из зависимостей, а не из повторения команд или ожидания ответа системы.
Этим способом собрали 1 535 сред и сохранили 2 852 траектории после фильтрации. Средняя траектория заняла 52,8 хода. При отборе проверяли, связаны ли действия с фактическими ответами терминала, даёт ли последовательность полезный пример решения и не использует ли агент закрытые сведения.
Длинные траектории улучшили не только терминальные тесты
На полученных примерах дообучили Qwen3.5-27B, показывая модели готовые последовательности действий и обратной связи. Получившуюся TerminalHorizon-27B сравнивали с исходной моделью на задачах программирования, автоматизации реальной работы и общего рассуждения.
В двух версиях Terminal-Bench результат вырос на 14,2% и 13,85%. На AutomationBench доля полностью решённых задач увеличилась на 11,7%, а оценка частично выполненной работы — на 23,3%. На VitaBench прирост составил 11,3%.
Проверка охватывала одну базовую модель такого размера и один набор синтетических данных. Учебные траектории создавал DeepSeek-V4-Pro-0813 в среде Terminus2, поэтому работа показывает результат конкретной схемы подготовки данных, а не универсальное преимущество любой длинной истории взаимодействия.
Авторы также дали агенту несколько задач на последовательное улучшение собственных методов. На каждую отвели 12 часов: модель продолжала эксперименты после первого рабочего решения, учитывала результаты проверок и переносила удачные изменения в итоговые материалы. Это разборы отдельных случаев, поэтому они показывают характер поведения, но не заменяют сравнительный тест надёжности.
Планы меняются у команд, которые контролируют обучение
Работа не предлагает новую архитектуру агента. Основной рычаг — данные: задача должна оставлять модели исследование, реализацию и проверку, а последующие этапы должны зависеть от того, что произошло раньше.
Команде, которая готовит собственное дообучение, стоит проверять синтетические среды независимым решателем до сбора датасета. Полезен не сам длинный журнал, а цепочка, где вывод команды меняет следующий шаг. Повторные запросы, просмотр каталогов и ожидание процесса длину увеличивают, но нужному поведению не учат.
Второе изменение касается проектирования проверок. Закрытая проверка должна оценивать требования из публичного задания, не добавляя условий, которые агент не мог обнаружить. При этом она должна принимать разные корректные реализации, а не только путь из эталонного решения.
Для продукта на готовой модели практический вывод относится прежде всего к испытаниям агента. Сценарии стоит строить так, чтобы поздняя ошибка требовала пересмотреть ранний вывод, а промежуточный артефакт использовался на следующем этапе. Одиночные задачи на вызов инструмента не показывают, сможет ли система автономно работать часами и сохранить качество результата.
Источники
Иллюстрация: рисунок из статьи «Scaling Agentic Data for Long-Horizon Terminal Intelligence», Shun Zou, Ziyu Ma, Yi Zou и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


