
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Программного агента научились лучше проверять после правок, которыми он меняет собственную обвязку. В работе Virginia Tech и NEC Laboratories America небольшой подобранный набор тестов отсёк 59,9% правок, менявших поведение, против 25,3% у штатных тестов; препринт пока не рецензировали, а все числа получили сами авторы. Такой фильтр позволяет проверять каждую самоправку без отдельного запуска агента на реальной задаче.
Почему штатные тесты дают слабый сигнал
Самоулучшающийся агент меняет код, который формирует запросы к модели, разбирает действия, запускает инструменты и записывает ход работы. Если система примет ошибочную правку, изменённое поведение перейдёт во все следующие запуски и станет основой для новых изменений.
Проверять каждую версию полным запуском агента дорого. Итог зависит не только от правки, но и от ответа модели, внешней среды и конкретной задачи, поэтому один запуск даёт шумный сигнал.
Штатные тесты запускаются предсказуемо, но обычно проверяют исходные требования к модулю. Они не создавались для будущих правок агента и могут пропустить изменение разделителя, значения по умолчанию, типа исключения или порядка обработки данных. Код продолжает выполнять основную функцию, хотя наблюдаемое поведение уже изменилось.
Сгенерированный набор тестов должен решить две противоположные задачи. Он должен фиксировать больше деталей поведения, но оставаться коротким: проверка выполняется после каждой правки, а сообщения об ошибках занимают контекст модели. Поэтому просто наращивать число тестов нельзя.
Как TeSearch ищет маленький, но строгий набор
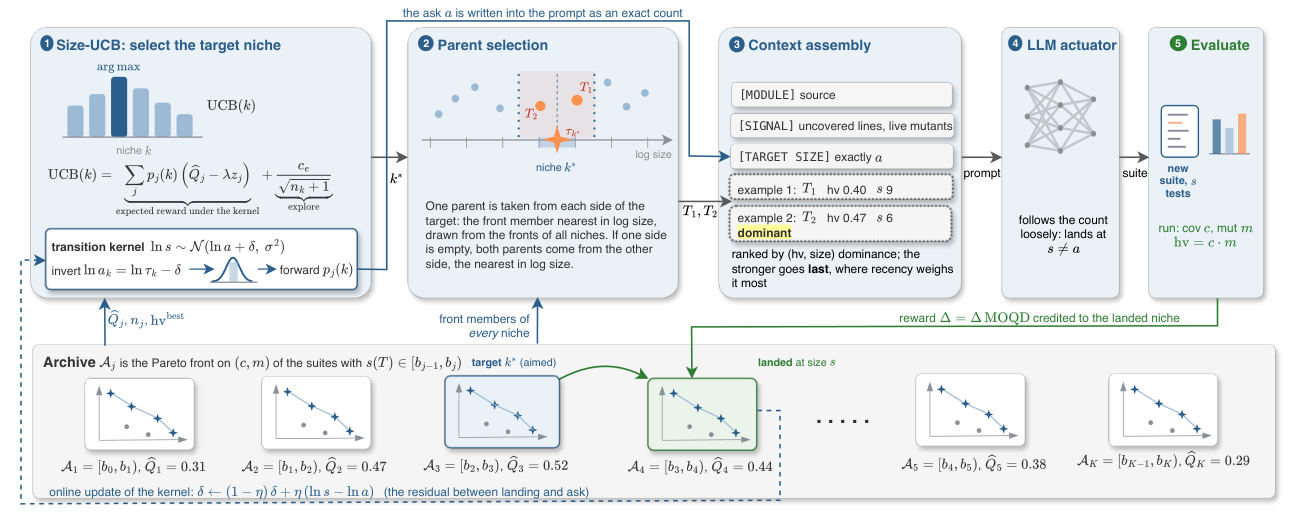
TeSearch оценивает набор по покрытию строк и мутационной оценке. Для второй метрики в программу вносят небольшие искусственные дефекты и проверяют, какую их долю замечают тесты. Сводная оценка растёт только тогда, когда набор одновременно выполняет код и ловит изменения его логики.
Размер набора становится не штрафом, который вычитают из качества, а отдельным признаком поиска. TeSearch делит варианты на диапазоны по числу тестов и хранит лучшие решения внутри каждого диапазона. Большой набор поэтому не вытесняет короткий только за счёт естественного преимущества в покрытии.
На очередном шаге система выбирает лучшие наборы немного меньше и немного больше целевого размера. LLM получает их вместе с модулем, непокрытыми строками и уцелевшими искусственными дефектами, а затем пишет новый вариант.
Модель не всегда соблюдает запрошенное число тестов. TeSearch в ходе поиска запоминает, насколько фактический размер отклоняется от целевого, прогнозирует диапазон, куда попадёт следующий вариант, и учитывает этот прогноз при выборе шага. Распределитель сначала закрепляет качество, а затем постепенно отдаёт предпочтение меньшим наборам.
Метод проверяли на 129 модулях Python из TestGenEval и на трёх LLM. Каждому способу давали одинаковый бюджет в 50 вызовов, а итоговые наборы оценивали на искусственных дефектах, которые не участвовали в поиске. Среди соперников были OpenEvolve, GEPA, Claude Code, Cursor, Pynguin и несколько стратегий многократной генерации.
Когда результат меняет планы разработки
TeSearch получил лучшую сводную оценку на каждой базовой модели и опередил сильнейший альтернативный способ на 7,0–8,5 пункта. При этом он выдавал самые короткие наборы среди методов на основе LLM. Эксперименты с отключёнными частями метода показали, что без постепенного давления на размер наборы разрастаются, а без учёта ошибки LLM система чаще промахивается мимо нужного диапазона.
В роли фильтра метод проверили на восьми модулях обвязки mini-swe-agent. Для каждого модуля подготовили как сохраняющие поведение правки, так и похожие по форме изменения с намеренно другим результатом. Сгенерированные тесты чаще замечали расхождения в разборе ответов модели, форматировании наблюдений, работе с конфигурацией и обработке исключений.
Более строгая проверка иногда блокировала допустимые изменения: доля таких ложных срабатываний составила 4,0%. Одно решение занимало в среднем 3,5 секунды и не требовало вызова модели. Вызовы LLM нужны заранее, когда TeSearch строит набор для модуля, а не при каждой последующей правке.
Работа меняет планы прежде всего у команд, которые разрешают агенту автоматически переписывать собственные запросы, обработчики инструментов или управляющий код. Для такого цикла стоит отделить дорогой поиск тестов от дешёвой проверки: один раз построить компактный набор, а затем запускать его как обязательный фильтр перед сохранением каждой версии.
Переносить вывод на весь продукт пока рано: генерацию наборов проверяли на модулях Python, а фильтрацию самоправок — на обвязке одного открытого агента. Результат показывает рабочий способ контролировать изменения управляющего кода, но не доказывает, что прошедшая тесты версия лучше решает пользовательские задачи.
Источники
Иллюстрация: рисунок из статьи «Small but Mighty: Test Suites as Improvement Signals for Self-Evolving Agents», Yutong Cheng, Wei Cheng, Wenchao Yu и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


