
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
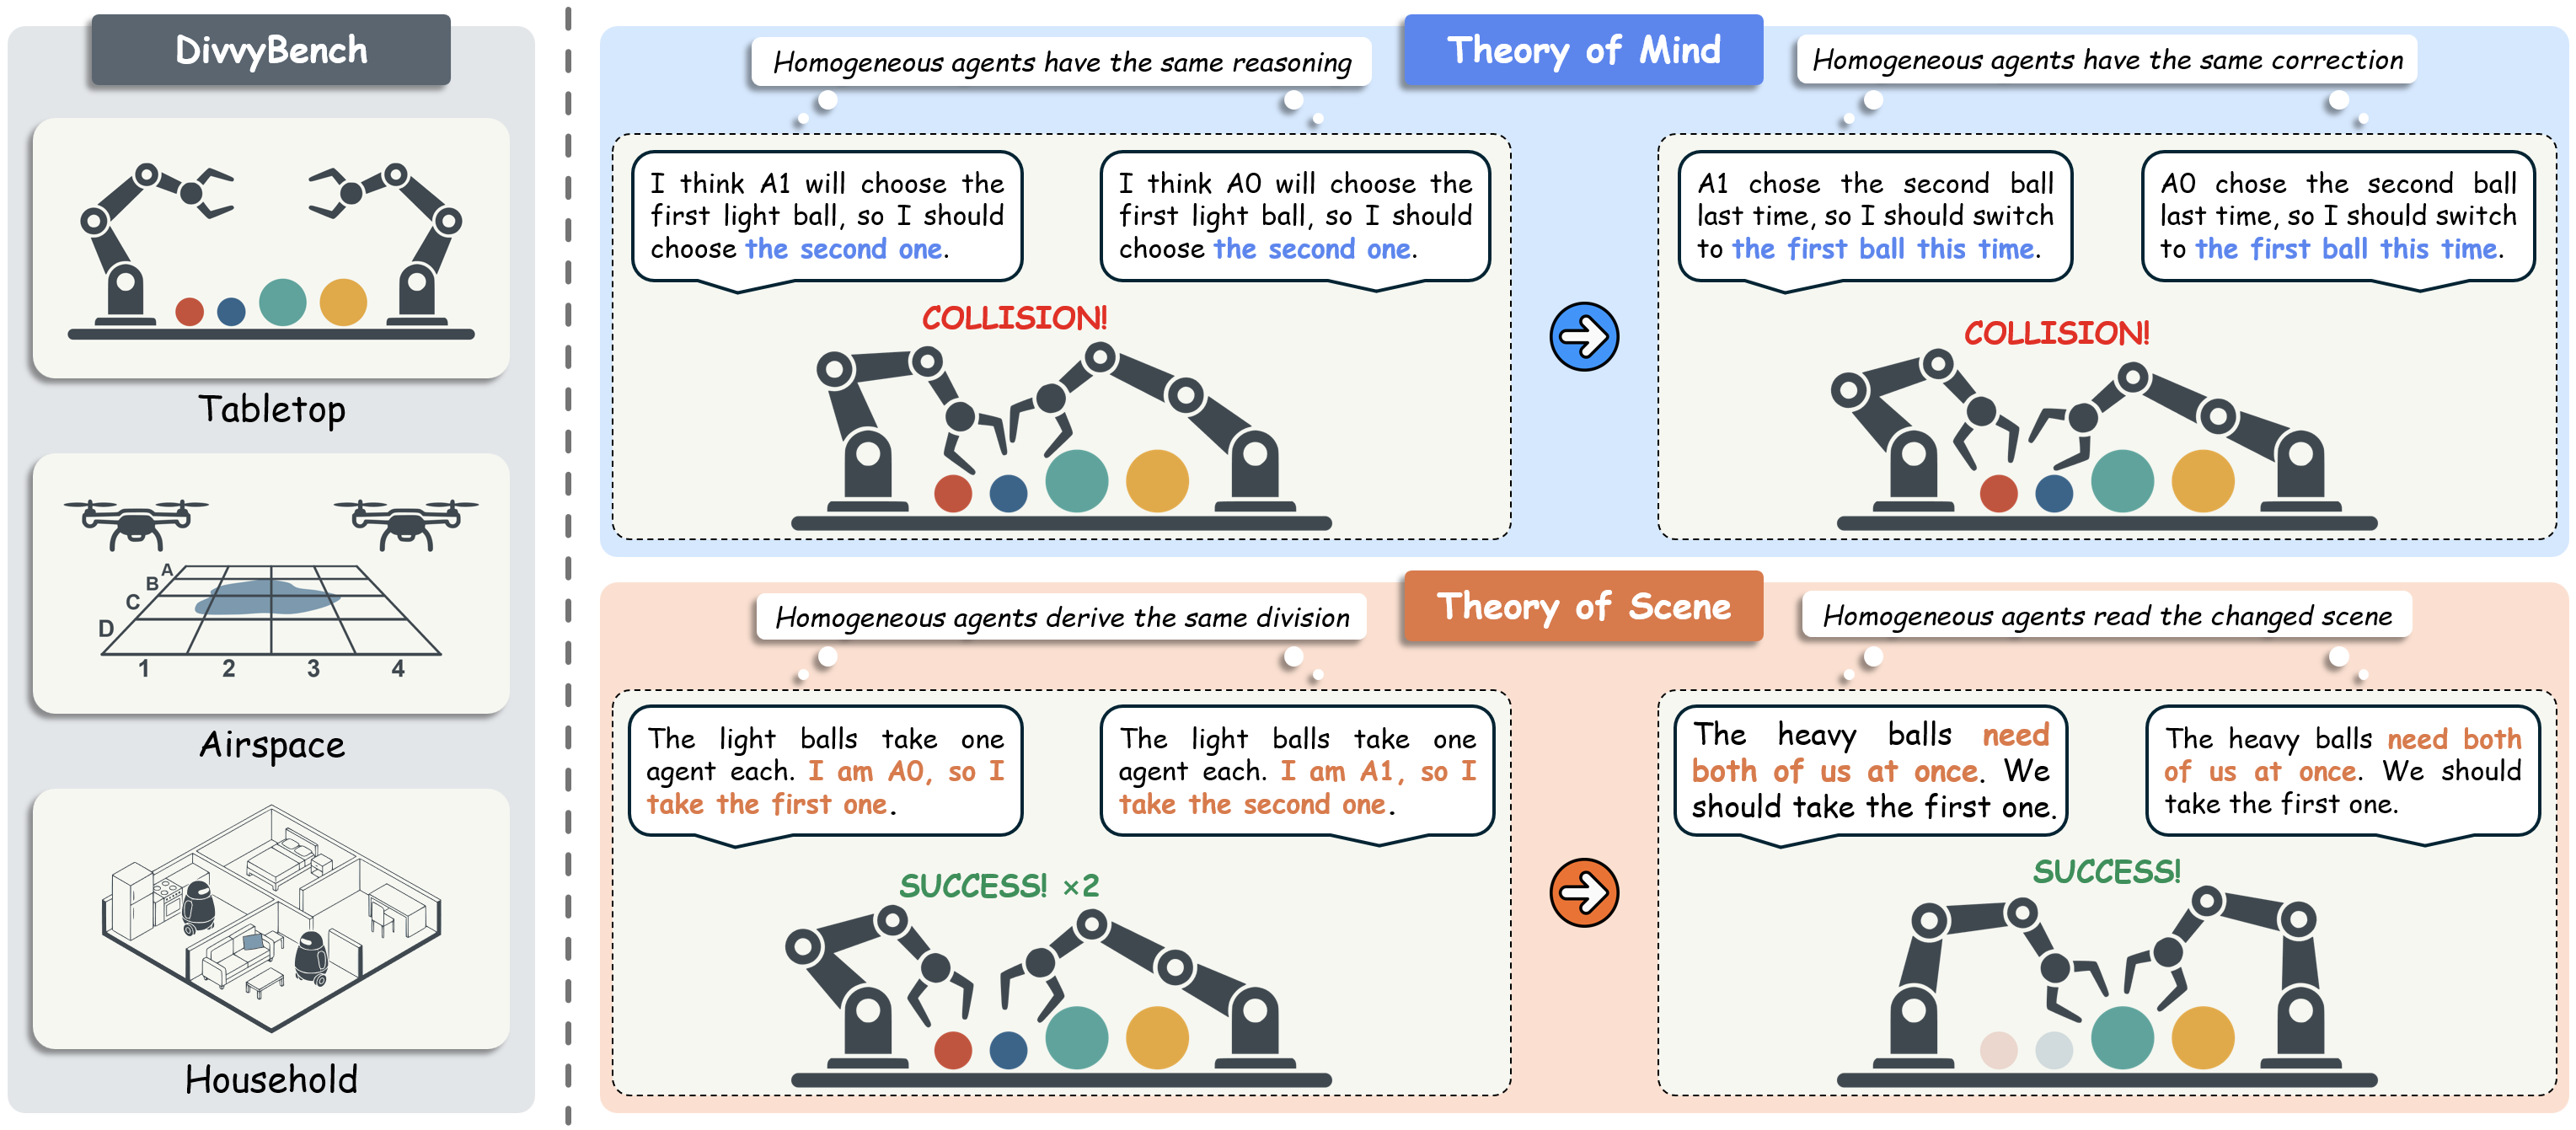
Одинаковые LLM-агенты научились делить цели и сходиться на общих задачах без сообщений и отдельного обучения. Схема Theory of Scene подняла долю успешных эпизодов DivvyBench с 71,1% у Theory of Mind до 99,6%; препринт не рецензирован, а числа получили сами авторы. Для систем с параллельными агентами это предлагает заменить взаимные прогнозы явным чтением общей сцены и публичной роли.
Одинаковое рассуждение мешает и разделению, и сотрудничеству
Однородные агенты получают одинаковое описание среды, используют одну модель и действуют одновременно. Если цель должен взять только один участник, агенты выбирают один и тот же заметный вариант и сталкиваются. Если цель требует совместного действия, случайное разведение агентов отправляет их в разные стороны.
Авторы называют это ловушкой симметрии. Она возникает не из-за слабого планирования отдельного агента, а из-за того, что вся команда одинаково отвечает на одну ситуацию. Повышенная температура генерации иногда разводит действия, но не создаёт общего правила разделения.
Theory of Mind тоже не решает обе части задачи. Каждый агент прогнозирует намерение другого и выбирает лучший ответ. Но одинаковая модель фактически прогнозирует копию себя: на спорных целях агенты могут разойтись, а на общей цели — построить разные частные прогнозы и не встретиться.
Публичные роли сами по себе также не задают работу. Метки Leader и Follower или индексы A0 и A1 различают агентов, но не объясняют, кому принадлежит конкретная цель. Нужен общий способ превратить это минимальное различие в одинаковый план для всей команды.
Как Theory of Scene выводит план из общей среды
Theory of Scene не пытается угадать скрытое намерение партнёра. Каждый агент читает наблюдаемую сцену, свою публичную роль и условия задачи, а затем самостоятельно выводит одно и то же разделение труда. Схема работает через обычный вызов модели и не требует дообучения.
Первый шаг определяет владение работой. Если среда уже закрепила станции, зоны или этапы за ролями, агент продолжает свою часть. Если все цели общие и роли ничего не распределяют, агент использует роль как устойчивый индекс для нового разделения.
Второй шаг определяет связь между действиями участников:
- Совместная цель. Несколько агентов должны выбрать её одновременно, поэтому команда сходится на одном варианте.
- Исключительная цель. Достаточно одного агента, поэтому цели сортируются по общему признаку и делятся между ролями.
- Последовательная цель. Следующий этап зависит от предыдущего, поэтому роли выполняют свои части по очереди.
Ключевая деталь — все агенты должны вывести одинаковый порядок целей. Для него подходят свойства, которые уже видны в сцене: положение, имя, расстояние, сложность или приоритет. После этого роль выбирает долю конкретного агента, а не подменяет собой правило координации.
В смешанном эпизоде правило меняется вместе с целью. Агенты могут сначала вместе забрать объект, требующий общего действия, а затем без переговоров разделить оставшиеся объекты. Предварительно назначенные роли вроде планировщика и исполнителя такой переход не описывают, потому что фиксируют обязанности до появления сцены.
Где схема выиграла и когда её стоит закладывать в архитектуру
Проверка охватила DivvyBench, GovSim и Overcooked, а соперниками выступили шесть базовых схем. В DivvyBench успех засчитывали, только если команда забрала все цели за доступные шаги: ToS прибавила 28,5 процентного пункта к результату ToM. В GovSim суммарная выгода от общего ресурса выросла с 207 до 400, а в Overcooked сопоставимый между уровнями темп работы оказался выше на 18%.
DivvyBench моделирует выбор целей в настольной сцене, воздушной разведке и бытовой помощи. Работа также проверяет разные базовые модели, неодинаковые порядки наблюдений и смешанные команды; размер команды в отдельных опытах доходил до пяти агентов, а в GovSim — до ста. Основной предмет проверки остаётся узким: параллельные агенты видят общее состояние, не обмениваются сообщениями и отличаются публичной ролью.
Работа меняет планы прежде всего для систем, где связь запрещена, дорога или ненадёжна: групп роботов, автономных устройств и изолированных программных агентов. В такой архитектуре стоит передавать каждому участнику одинаковое состояние задачи, устойчивый индекс роли и явные правила для совместных, исключительных и последовательных целей.
Если центральный координатор уже распределяет задания или агенты могут согласовать план через API, ToS не даёт очевидной причины убирать этот механизм. Это схема рассуждения, а не полноценный протокол: она не передаёт подтверждения, не разрешает сетевые сбои и не заменяет контроль выполнения.
Практический вывод касается структуры подсказки. Вместо просьбы «предскажи действие остальных» агенту полезнее отдельно определить, разделена ли работа средой, какой тип координации требует текущая цель и какую часть задаёт его роль. Такое разделение можно внедрить без обучения модели, но проверять его нужно на собственных сценах, где порядок объектов и доступные наблюдения могут расходиться.
Источники
Иллюстрация: рисунок из статьи «Theory of Scene: Breaking the Symmetry Trap in Multi-Agent LLM Coordination», Liangqi Yuan, Wenzhi Fang, Shiqiang Wang и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


