Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
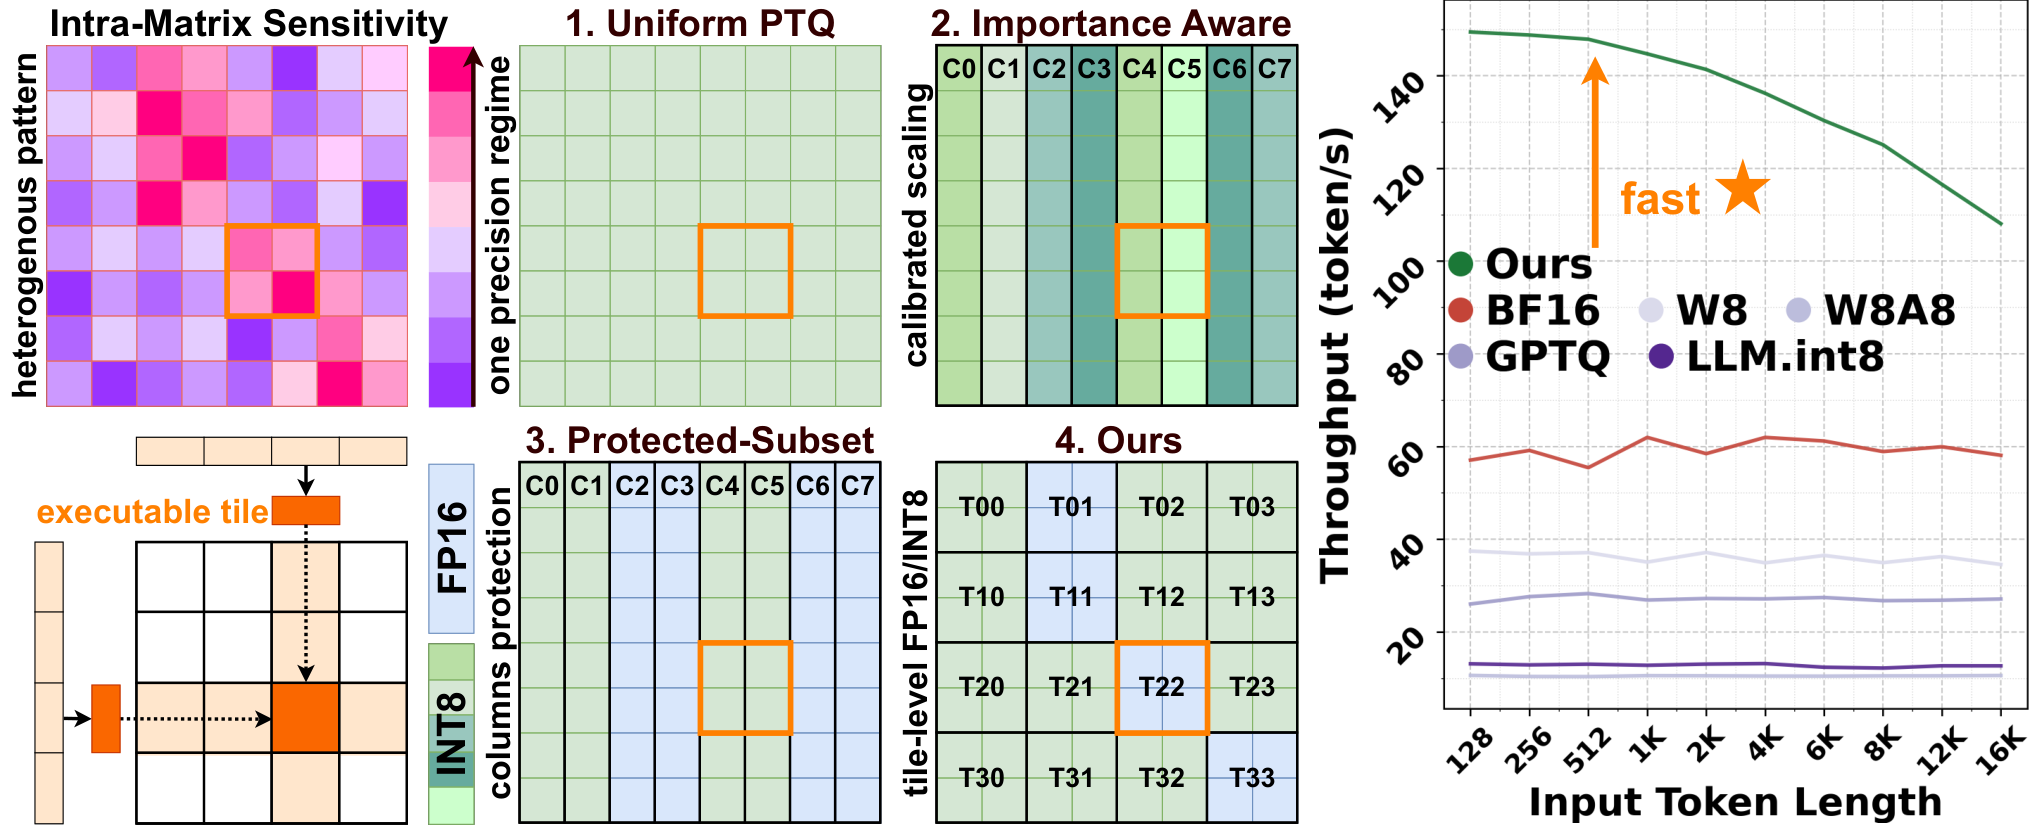
Точность весов LLM можно снижать локально после обучения, сохраняя качество на проверенных задачах. В препринте University of North Texas и Saint Louis University, который не прошёл рецензирование, авторы в собственных замерах подняли пропускную способность генерации Llama-3.2-3B до 2,66 раза относительно исходной модели. Подход подходит для готовых моделей, но требует изменить хранение весов и ядро вычислений.
Точность назначают не столбцу, а локальному блоку весов
Посттренировочная квантизация уменьшает точность уже обученной модели: веса занимают меньше памяти, а GPU быстрее выполняет операции с ними. Равномерные методы используют один формат для всей матрицы. Другие подходы сохраняют отдельные столбцы с высокой точностью, хотя чувствительные веса могут занимать только часть столбца.
TileQuant делит матрицу весов на двумерные блоки (тайлы), размеры которых соответствуют регулярным операциям GPU. Каждый блок получает собственную оценку важности. Самые важные остаются в 16-битном формате, остальные переходят в 8-битный.
Работа предлагает два способа оценить важность. Первый сопоставляет величину весов с активациями на калибровочных примерах. Он требует только прямого прохода модели и подходит, когда калибровку нужно провести с меньшими затратами.
Второй способ учитывает градиент функции потерь: он измеряет, насколько изменение конкретного веса влияет на предсказание следующего токена. Такой расчёт требует прямого и обратного проходов, зато точнее выделяет участки, чувствительные к снижению точности.
Для каждой линейной проекции команда заранее задаёт долю весов, которую можно оставить с высокой точностью. TileQuant ранжирует блоки внутри этой проекции и строит карту форматов. Одну рассчитанную карту оценок можно использовать с разными бюджетами высокой точности, не повторяя калибровку.
Карта точности превращается в исполняемый слой
Само распределение форматов не ускоряет модель, если GPU приходится искать нужные блоки во время генерации. TileQuant выполняет этот выбор заранее. При загрузке контрольной точки система раскладывает блоки двух форматов по отдельным непрерывным буферам и сохраняет их индексы.
Во время вывода 8-битные блоки обрабатывает целочисленный путь, а сохранённые блоки высокой точности получают исходные активации. Результаты сходятся в общем аккумуляторе. Ядро держит промежуточные суммы в регистрах и записывает готовый выходной блок один раз, поэтому смешанная точность не создаёт отдельную запись в память после каждого умножения.
Одни и те же упакованные веса работают и при обработке исходного запроса, и при последовательной генерации токенов. Ядро меняет схему параллельного выполнения в зависимости от числа строк активаций: на длинном запросе переиспользует загруженные веса, а при генерации распределяет работу по частям матрицы.
Это отличает TileQuant от карты чувствительных весов как исследовательского результата. В работе есть полный путь от калибровки до специализированного ядра на Triton, а расположение блоков учитывает форму операций GPU.
Что меняется в планах команд
Метод проверили на Llama-3.2-3B, Qwen2.5-7B и Qwen2.5-14B. В сравнение вошли исходные модели, равномерная квантизация весов, W8A8, GPTQ, SmoothQuant и LLM.int8. Набор задач охватывает языковое моделирование, рассуждения, поиск в длинном контексте и ответы на вопросы; LV-Eval использует контексты от 16K до 256K токенов.
На Llama-3.2-3B вариант с градиентной оценкой и сохранением 20% блоков обошёл исходную модель в 26 из 27 сочетаний набора данных и длины контекста в LV-Eval. Рост на отдельных тестах не означает, что квантизация улучшает базовую модель: он показывает, что ошибка от снижения точности не стала главным фактором на этих проверках.
TileQuant меняет план внедрения, если команда контролирует собственный контур вывода и упирается в пропускную способность или память GPU. Вместо выбора между полностью однородным форматом и сохранением целых каналов можно добавить третью ветку испытаний: локальную смешанную точность с заранее заданным бюджетом.
Для быстрого прототипа подходит оценка по активациям. Градиентный вариант имеет смысл, когда важнее сохранить качество и команда готова потратить больше ресурсов на однократную калибровку. В обоих случаях переобучать модель не требуется.
Подменить формат весов в существующем сервере недостаточно. Практический выигрыш зависит от загрузчика, расположения буферов и специализированного ядра, поэтому метод стоит оценивать как изменение слоя исполнения. Проверка в работе охватывает три семейства размеров и несколько типов задач, но решение о внедрении всё равно требует замеров на целевой модели, GPU и реальном распределении запросов.
Источники
Иллюстрация: рисунок из статьи «TileQuant: Tile as the Precision-Allocation Unit for LLM Mixed-Precision Post-Training Quantization», Hanzhi Zhang, Qiao Zhang, Qinglei Cao и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.