
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
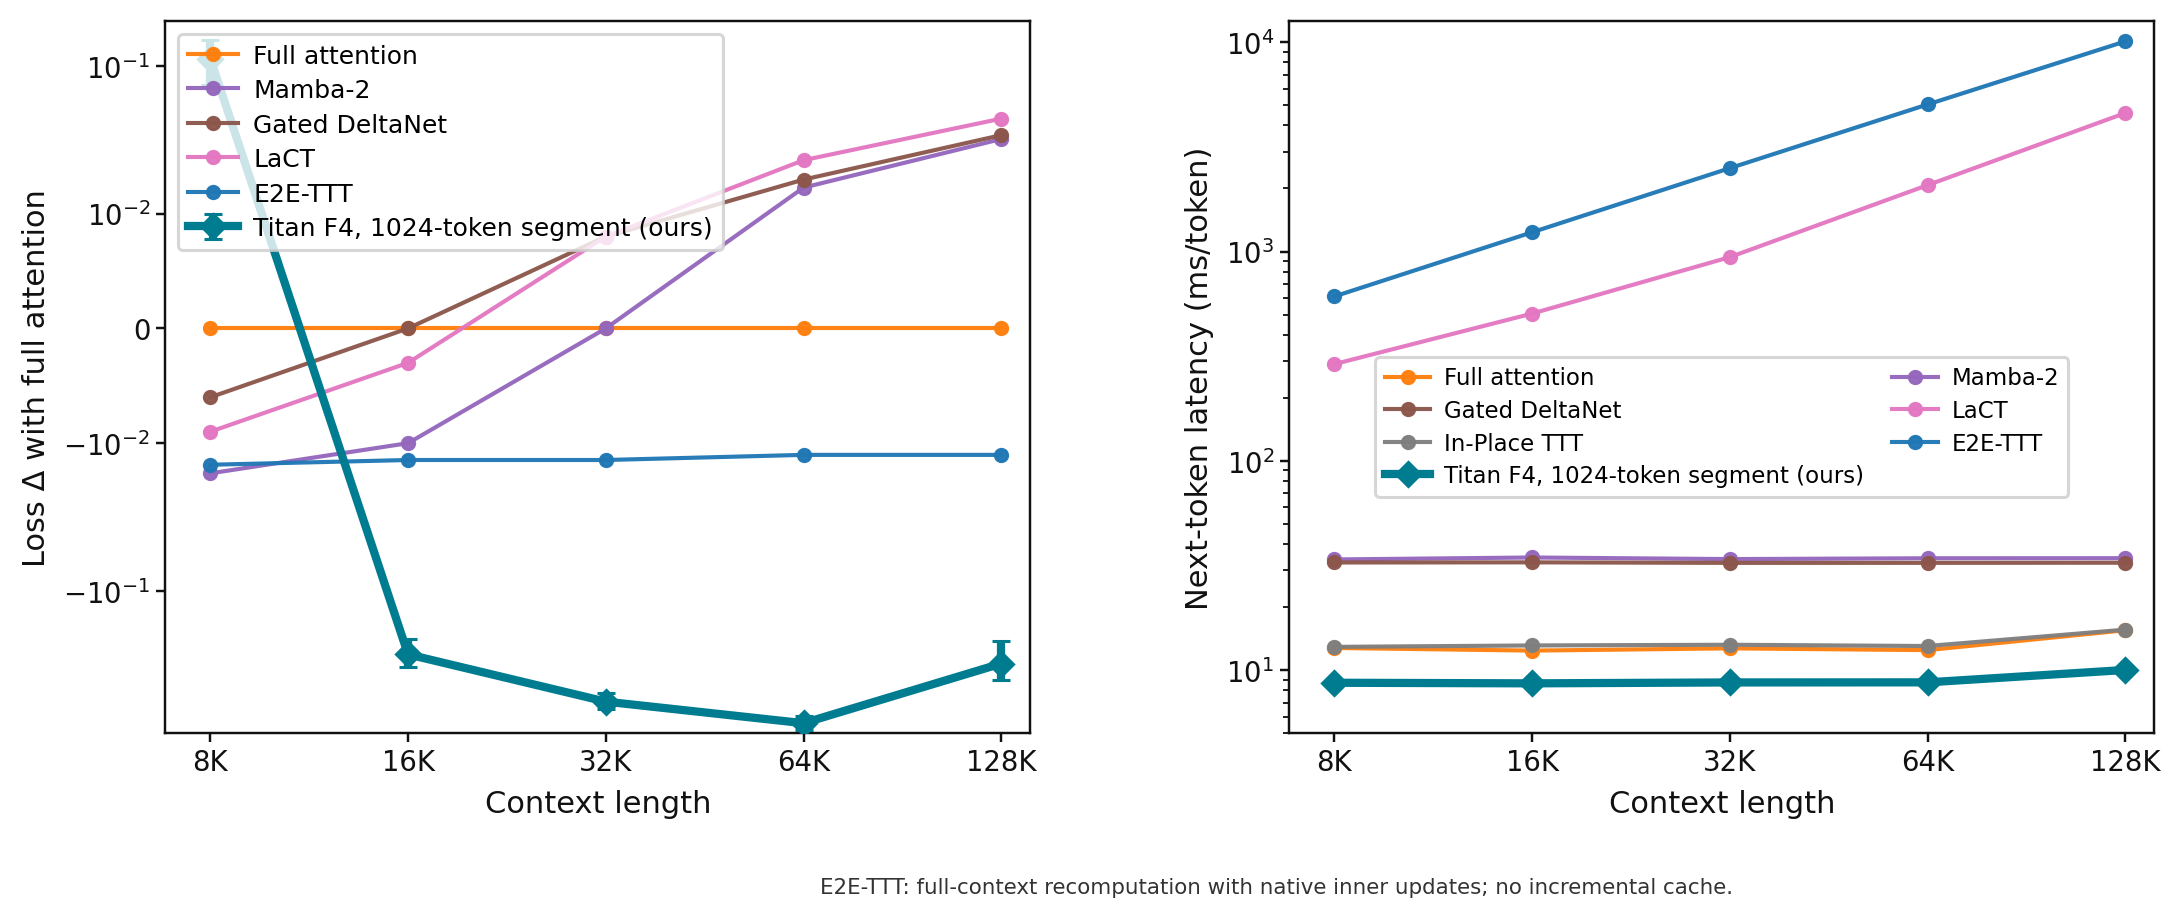
Готовую Llama научились дольше удерживать сведения из контекста, не сохраняя всю историю в растущем кеше. В работе Sarah Pan из MIT и Ali Behrouz из Cornell генерация токенов ускорилась на 37%; препринт не рецензирован, и эти числа получили сами авторы. Метод позволяет переделать существующую модель после основного обучения, а не обучать новую архитектуру с нуля.
Недавние токены остаются точными, старые переходят в память
Обычный трансформер хранит для предыдущих токенов кеш ключей и значений. Чем длиннее запрос и сгенерированный ответ, тем больше памяти занимает кеш и тем дороже модели обращаться ко всей истории.
Titan-Llama делит контекст на недавнюю и историческую части. Внутри текущего блока работает обычное внимание: модель видит последние токены без сжатия. Более ранние блоки переходят во внешний нейронный модуль фиксированного размера.
Этот модуль представляет собой небольшую многослойную сеть. При обработке каждого заполненного блока она учится восстанавливать соответствия между ключами и значениями внимания. Для обновления не нужны разметка или правильный ответ: обучающий сигнал уже содержится в промежуточных данных самой LLM.
Когда модель обрабатывает новый токен, она получает два результата. Первый приходит от точного внимания к текущему блоку, второй — из сжатой памяти о предыдущих блоках. Отдельный затвор для каждого канала определяет, в какой пропорции их смешать.
Базовые веса Llama при дополнительном обучении не меняются. Команда обучает внешнюю память и компоненты смешивания, которые занимают около 1% от общего объёма параметров. Это и отличает подход от перехода на рекуррентную модель: готовая LLM остаётся основой системы.
Память возвращает часть качества, потерянного из-за коротких окон
На QuALITY точность выросла с 23,87% до 40,51% относительно модели, которая видела только отдельные сегменты. На LongHealth результат поднялся с 14,50% до 40,75%. Эти тесты требуют находить и связывать сведения в длинных документах, поэтому разница показывает, что внешний модуль действительно переносит полезную информацию между блоками.
Проверки на RULER уточняют, какую историю память сохраняет лучше. Titan-Llama хорошо извлекает один ключ, связывает несколько ключей и считает частые слова. Когда нужно вернуть несколько разных значений из одного контекста, разрыв с полным вниманием растёт.
Увеличение блока тоже не даёт универсального выигрыша. Длинный блок оставляет модели больше точного локального контекста и помогает в QuALITY и LongHealth, но повышает время обработки входного текста. В задачах на поиск отдельных фрагментов результат зависит от длины контекста и вида запроса.
При генерации Titan-Llama занимала на 24% меньше памяти, чем Llama с полным кешем. Пиковый расход во время первичной обработки запроса, однако, у частично переделанных вариантов мог быть выше: обновление нейронной памяти тоже требует промежуточных данных.
Метод меняет архитектурный план, но пока не заменяет кеш целиком
Основную конфигурацию проверяли на Llama-3.2-1B-Instruct: внешнюю память добавили к первым четырём слоям, а последующие слои сохранили полное внимание. Производительность измеряли на одном NVIDIA A100, качество — на задачах длинного вопросно-ответного поиска, языкового моделирования и RULER.
Такая схема важна для интерпретации результата. Эксперимент показывает не полную замену кеша, а гибрид: ранние слои сжимают историю, тогда как поздние всё ещё могут обращаться к ней напрямую. Когда поздние слои тоже ограничили локальными окнами, память не вернула качество основной конфигурации.
Для команды с уже обученной моделью работа добавляет промежуточный вариант между двумя дорогими решениями: постоянно наращивать кеш или обучать другую архитектуру. Базовую LLM можно заморозить, встроить внешние модули и провести дополнительное обучение на длинных последовательностях.
Это не подключаемая оптимизация уровня сервера. Нужно менять слои внимания, обучать новые компоненты и обновлять память во время обработки каждого запроса. Размер блока становится продуктовым параметром: он одновременно влияет на точность локальных деталей, качество дальней памяти и задержку.
Практический вывод узкий: подход стоит проверять там, где запросы регулярно содержат длинные документы, но задачи не требуют дословно восстановить множество разрозненных значений. Для коротких запросов или сценариев с точным извлечением всей истории работа пока не даёт оснований менять архитектуру.
Источники
Иллюстрация: рисунок из статьи «Titan-Llama: Retrofitting Pre-trained LLMs with External Neural Memory Modules», Sarah Pan, Ali Behrouz, CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


