
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Компактных агентов научили перенимать у большой модели только те действия с инструментами, которые повлияли на успех или провал длинной задачи. В препринте Northeastern University и Honor Device, который не прошёл рецензирование и в котором все числа получили сами авторы, ToolOPD повысил среднюю успешность по сравнению с равномерным обучением от учителя. Метод может изменить подготовку агентов с длинными цепочками вызовов API, но потребует дополнительных вычислений во время обучения.
Как связали отдельное действие с итогом задачи
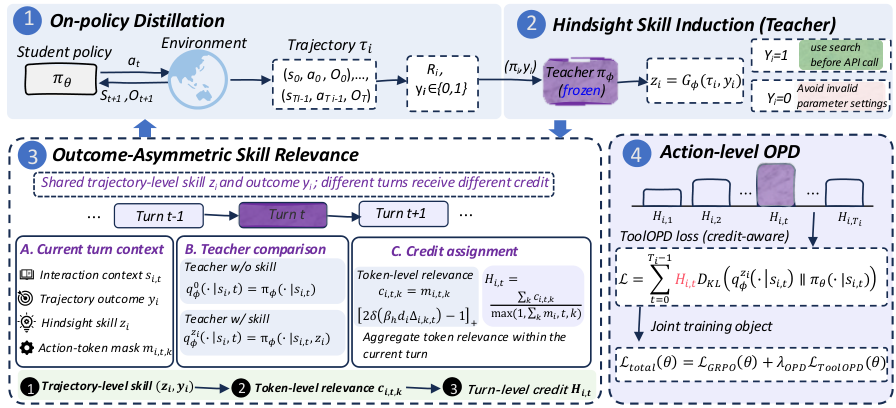
При дистилляции на траекториях самого ученика, или OPD, компактная модель выполняет задачу, а модель-учитель оценивает выбранные ею действия. Такое обучение даёт сигнал для каждого токена, даже если среда сообщает только итоговый успех или провал.
Обычная OPD применяет учительский сигнал примерно с одинаковой силой на всей траектории. Для короткой задачи это приемлемое упрощение. В длинной цепочке большинство шагов лишь получает состояние среды, переносит данные или продолжает уже выбранный сценарий, тогда как исход определяют несколько вызовов инструмента и их параметры.
Диагностика на ALFWorld показала, что верхние 20% ходов сосредоточили 74,2% совокупного веса. При равномерной дистилляции 53,5% учительских сигналов противоречили итоговому результату. В отдельной проверке последовательность состояний и действий оставляли неизменной, но меняли метку успеха на провал: веса нескольких ходов заметно сдвигались, хотя сама траектория не менялась.
ToolOPD сначала передаёт учителю полную траекторию вместе с исходом. Учитель сворачивает её в одно короткое правило: для успешного прохода описывает полезный приём, для неудачного — причину ошибки и способ её избежать.
Затем метод дважды оценивает фактически выбранное учеником действие: с этим правилом в контексте и без него. Если правило повышает вероятность действия в успешной траектории, действие получает больший вес. В провальной траектории учитывается обратный случай — правило должно снижать вероятность ошибочного действия. Остальные сигналы отбрасываются как не связанные с исходом или противоречащие ему.
Полученный вес применяется только к токенам исполняемого действия, а не к тексту рассуждения. Эту функцию потерь объединяют с GRPO — обучением с подкреплением, которое сравнивает награды нескольких попыток одной задачи. Поэтому учитель направляет отдельные решения, а награда среды сохраняет возможность искать новые стратегии.
Отбор важных ходов дал больше, чем дополнительная подсказка
В разборе компонентов полная версия ToolOPD достигла средней успешности 59,38% и обошла обычную OPD на 5,47 процентного пункта. Вариант, который добавлял итоговое правило, но не распределял вес между действиями, также уступил полной схеме. Значит, результат связан не только с дополнительным контекстом от учителя, но и с выбором конкретных мест для обучения.
Среди действий с самым высоким весом доля сигналов, согласованных с исходом, достигла 71,3% против примерно 50,0% при случайном выборе. Низкий вес, таким образом, означает не просто менее важный ход: там чаще встречается обучение, которое способно подтолкнуть модель в неверную сторону.
На ALFWorld, SearchQA и WebShop метод сравнивали с обучением только по награде, обычной OPD и несколькими вариантами дистилляции с навыками или динамическими весами. Отдельный набор экспериментов охватывал FTRL, BFCL и ToolHop, включая перенос на наборы, которые не использовали для обучения. Метрики различались между средами, поэтому отдельные результаты нельзя складывать в единую оценку качества агента.
Когда ToolOPD меняет план обучения агента
Работа относится к компактным моделям, которые выполняют многошаговые задачи через дискретные действия. Учениками служили Qwen3-0.6B и Qwen3-1.7B, учителем — Qwen3-4B после обучения с подкреплением. Это границы практического вывода: метод проверяли на сравнительно небольших моделях и средах с формализованным успехом или провалом.
Для команды, которая уже собирает траектории агента и обучает его по итоговой награде, ToolOPD предлагает конкретную замену равномерной дистилляции. Не нужно размечать каждый промежуточный шаг вручную: вес выводится из того, как итоговое правило меняет оценку реального действия ученика.
Цена появляется в учебном контуре. Для каждой траектории учитель должен прочитать полный диалог, сформулировать правило и оценить действия с правилом и без него. Это добавляет генерацию и повторные проходы учителя, поэтому при планировании инфраструктуры нужно учитывать не только обучение ученика, но и обработку длинного контекста более крупной моделью.
На запуске агента схема не требует учителя и не генерирует итоговое правило. Веса нужны только во время обучения, а развёртывается обычная модель-ученик. Поэтому метод лучше всего подходит продуктам, где можно один раз потратить больше вычислений на подготовку модели, но нельзя увеличивать задержку и стоимость каждого рабочего запроса.
Менять архитектуру ради ToolOPD рано, если агент делает один-два независимых вызова или среда не возвращает надёжный итог задачи. Для длинных процессов с редкой наградой работа даёт более предметный план: записывать полные траектории, хранить исход, отделять исполняемые действия от рассуждения и направлять дистилляцию только туда, где сигнал учителя согласуется с результатом.
Источники
Иллюстрация: рисунок из статьи «ToolOPD: Credit-Aware On-Policy Distillation for Tool-Use Agents», Chu Zhao, Lei Tang, Yanming Wang и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


