
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Длинную историю проб и ошибок агента можно превратить в короткую процедуру, которую он проверяет по состоянию среды и продолжает с промежуточного шага. В опытах Kaijie Chen и коллег Trace обошёл сильнейшие базовые методы в среднем на 30% по качеству на всей серии попыток и на 40,5% по результату в конце серии. Хотя работу ещё не рецензировали и все числа получили сами авторы, она предлагает командам конкретную замену полным журналам действий и текстовым резюме.
Как Trace отделяет необходимый шаг от случайного
Успешная траектория сама по себе не равна инструкции. Агент мог несколько раз вернуться в прежнюю комнату, проверить ненужный предмет и выполнить ошибочное действие, прежде чем открыть дверь. Если сохранить всю последовательность, он повторит лишние шаги; если попросить LLM кратко пересказать опыт, резюме может потерять условия, без которых дверь не откроется.
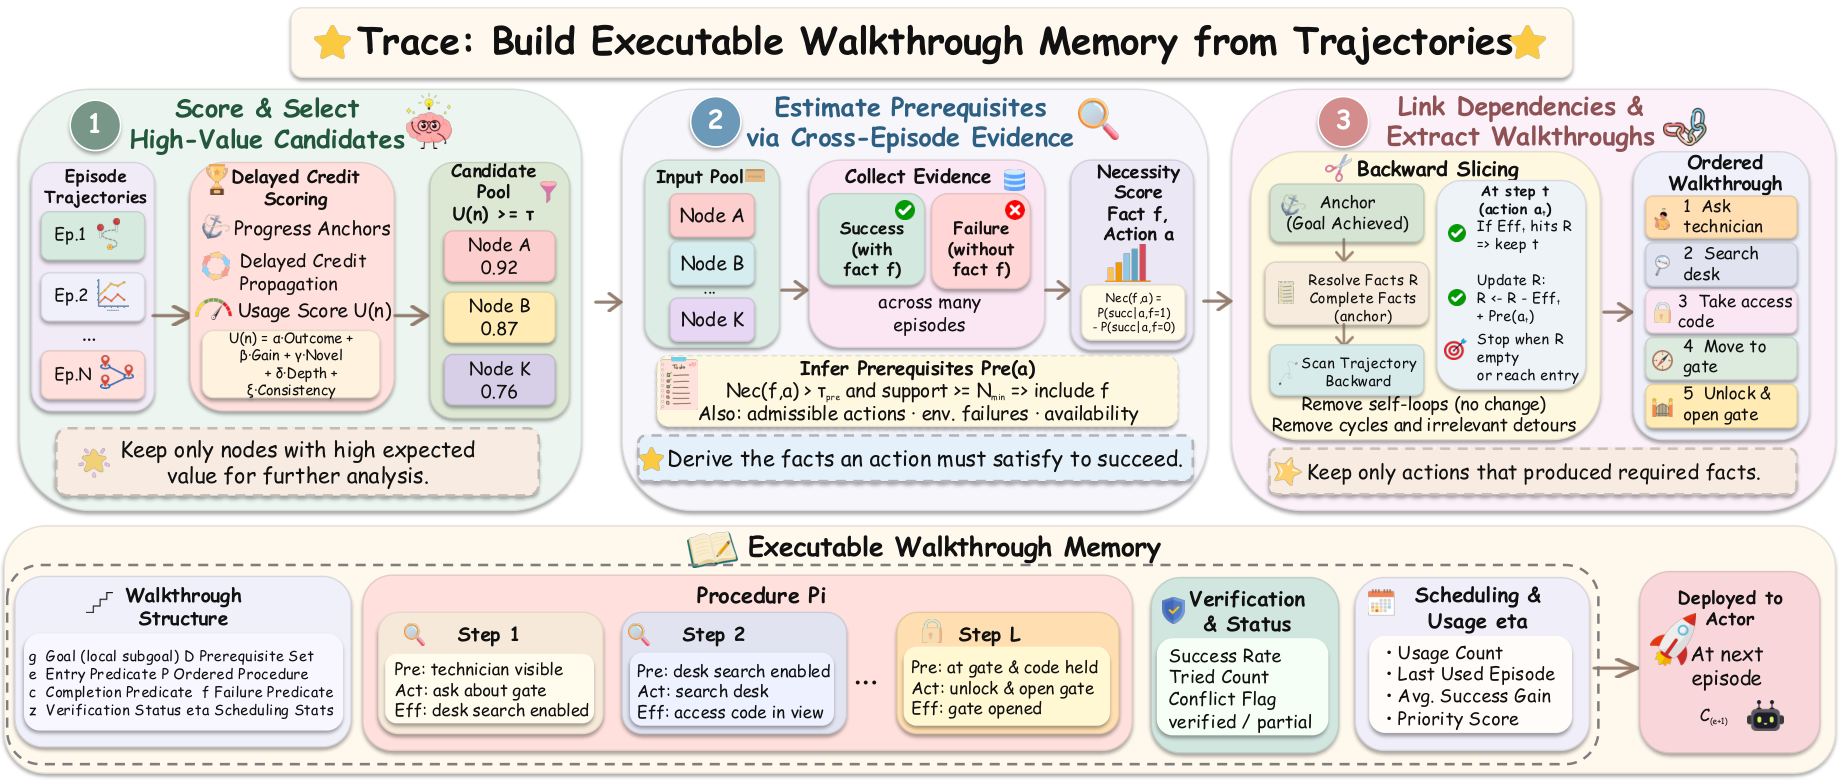
Trace сначала приводит наблюдения к структурированному состоянию. Оно включает местоположение, инвентарь, видимые объекты, их свойства, доступные переходы и допустимые действия. Затем система отмечает точки прогресса: изменение награды, появление предмета в инвентаре, открытие прохода, устойчивое изменение объекта или завершение задачи.
Ценность такой точки переносится назад по предшествующим действиям. Это возвращает в рассмотрение подготовительные шаги без собственной награды: например, разговор с персонажем или поиск кода. Но высокая ценность означает лишь связь с последующим успехом, а не необходимость действия.
Чтобы найти необходимость, Trace сопоставляет успешные и неуспешные попытки одного действия в разных эпизодах. Если действие чаще срабатывает при наличии определённого факта, система записывает этот факт как возможную предпосылку. Такая связь остаётся наблюдаемой зависимостью, а не доказанной причиной; при малом числе попыток предпосылка остаётся неопределённой.
После этого система идёт назад от целевого факта. Она сохраняет действие, которое создало этот факт, добавляет его предпосылки в список нерешённых и ищет действия, создавшие уже их. Петли, возвраты и переходы, не связанные с этой цепочкой, отбрасываются.
Результат хранится не как свободный текст, а как процедура с условиями входа, последовательностью «предпосылка — действие — ожидаемый эффект», критериями успеха и признаками ошибки. Агент может проверить применимость процедуры, начать не с первого шага, подтвердить эффект каждого действия и вовремя остановиться.
Где проверяли процедуры и что дали отдельные части
Trace проверяли на J-TTL, WebShop и ScienceWorld с Qwen3-32B, Mistral-Small-3.2-24B и GPT-OSS-20B. В каждой задаче агент проходил десять эпизодов с пределом в 150 действий; сравнение охватывало хранение траекторий, поиск по памяти, резюме, рефлексию и методы автоматического улучшения подсказок.
Качество оценивали двумя основными способами. AUC показывает средний нормализованный результат на всей серии эпизодов, поэтому отражает скорость накопления полезного опыта. Final-3 усредняет последние попытки и показывает, к чему агент пришёл после обновления памяти.
Самый большой разрыв возник на J-TTL, где задачи особенно зависят от цепочек предпосылок: прирост составил 65,4% по AUC и 135,6% по Final-3. При этом Trace тратил до 37,8% меньше токенов, чем лучший по AUC конкурент в соответствующем сравнении.
Разбор компонентов связывает результат не только с отбором удачных траекторий. Перенос ценности назад возвращает подготовительные действия, оценка предпосылок восстанавливает зависимости, а обратное выделение цепочки убирает из неё лишнее. Когда к памяти добавили исполнимое представление, в J-TTL среднее число действий на успешное выполнение сократилось с 42,7 до 21,9.
Когда подход меняет архитектуру агента
Работа меняет планы для систем, которые многократно решают сходные длинные задачи и получают редкую обратную связь. Вместо очередного слоя поиска по журналам можно заложить отдельную процедурную память: она обновляется между эпизодами, тогда как сама LLM и логика агента остаются неизменными.
Для внедрения потребуется представить среду через устойчивые факты и фиксировать эффекты действий. Практический контур включает разбор наблюдений, журнал успешных и неуспешных попыток, построитель зависимостей, исполнитель процедуры и проверку ожидаемого состояния после каждого шага. Именно структурированное состояние позволяет возобновлять выполнение с середины, а не воспроизводить старую траекторию целиком.
Подход слабее переносится на среды, где наблюдение трудно разложить на местоположение, объекты, свойства и допустимые действия. Он также накапливает полезные предпосылки только после повторных успехов и ошибок. Поэтому Trace скорее задаёт архитектуру памяти для управляемых сред и инструментальных агентов, чем готовую замену памяти в любом браузерном или компьютерном агенте.
Главный инженерный вывод состоит в выборе единицы памяти. Если агенту нужно повторять многошаговые операции, хранить следует не рассказ о прошлом и не всю запись сеанса, а проверяемую цепочку изменений состояния с явными условиями запуска и остановки.
Источники
Иллюстрация: рисунок из статьи «Success Leaves Detours: Learning Executable Walkthroughs for Long-Horizon Agents», Kaijie Chen, Chenyu Fang, Liang Yan и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


