
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
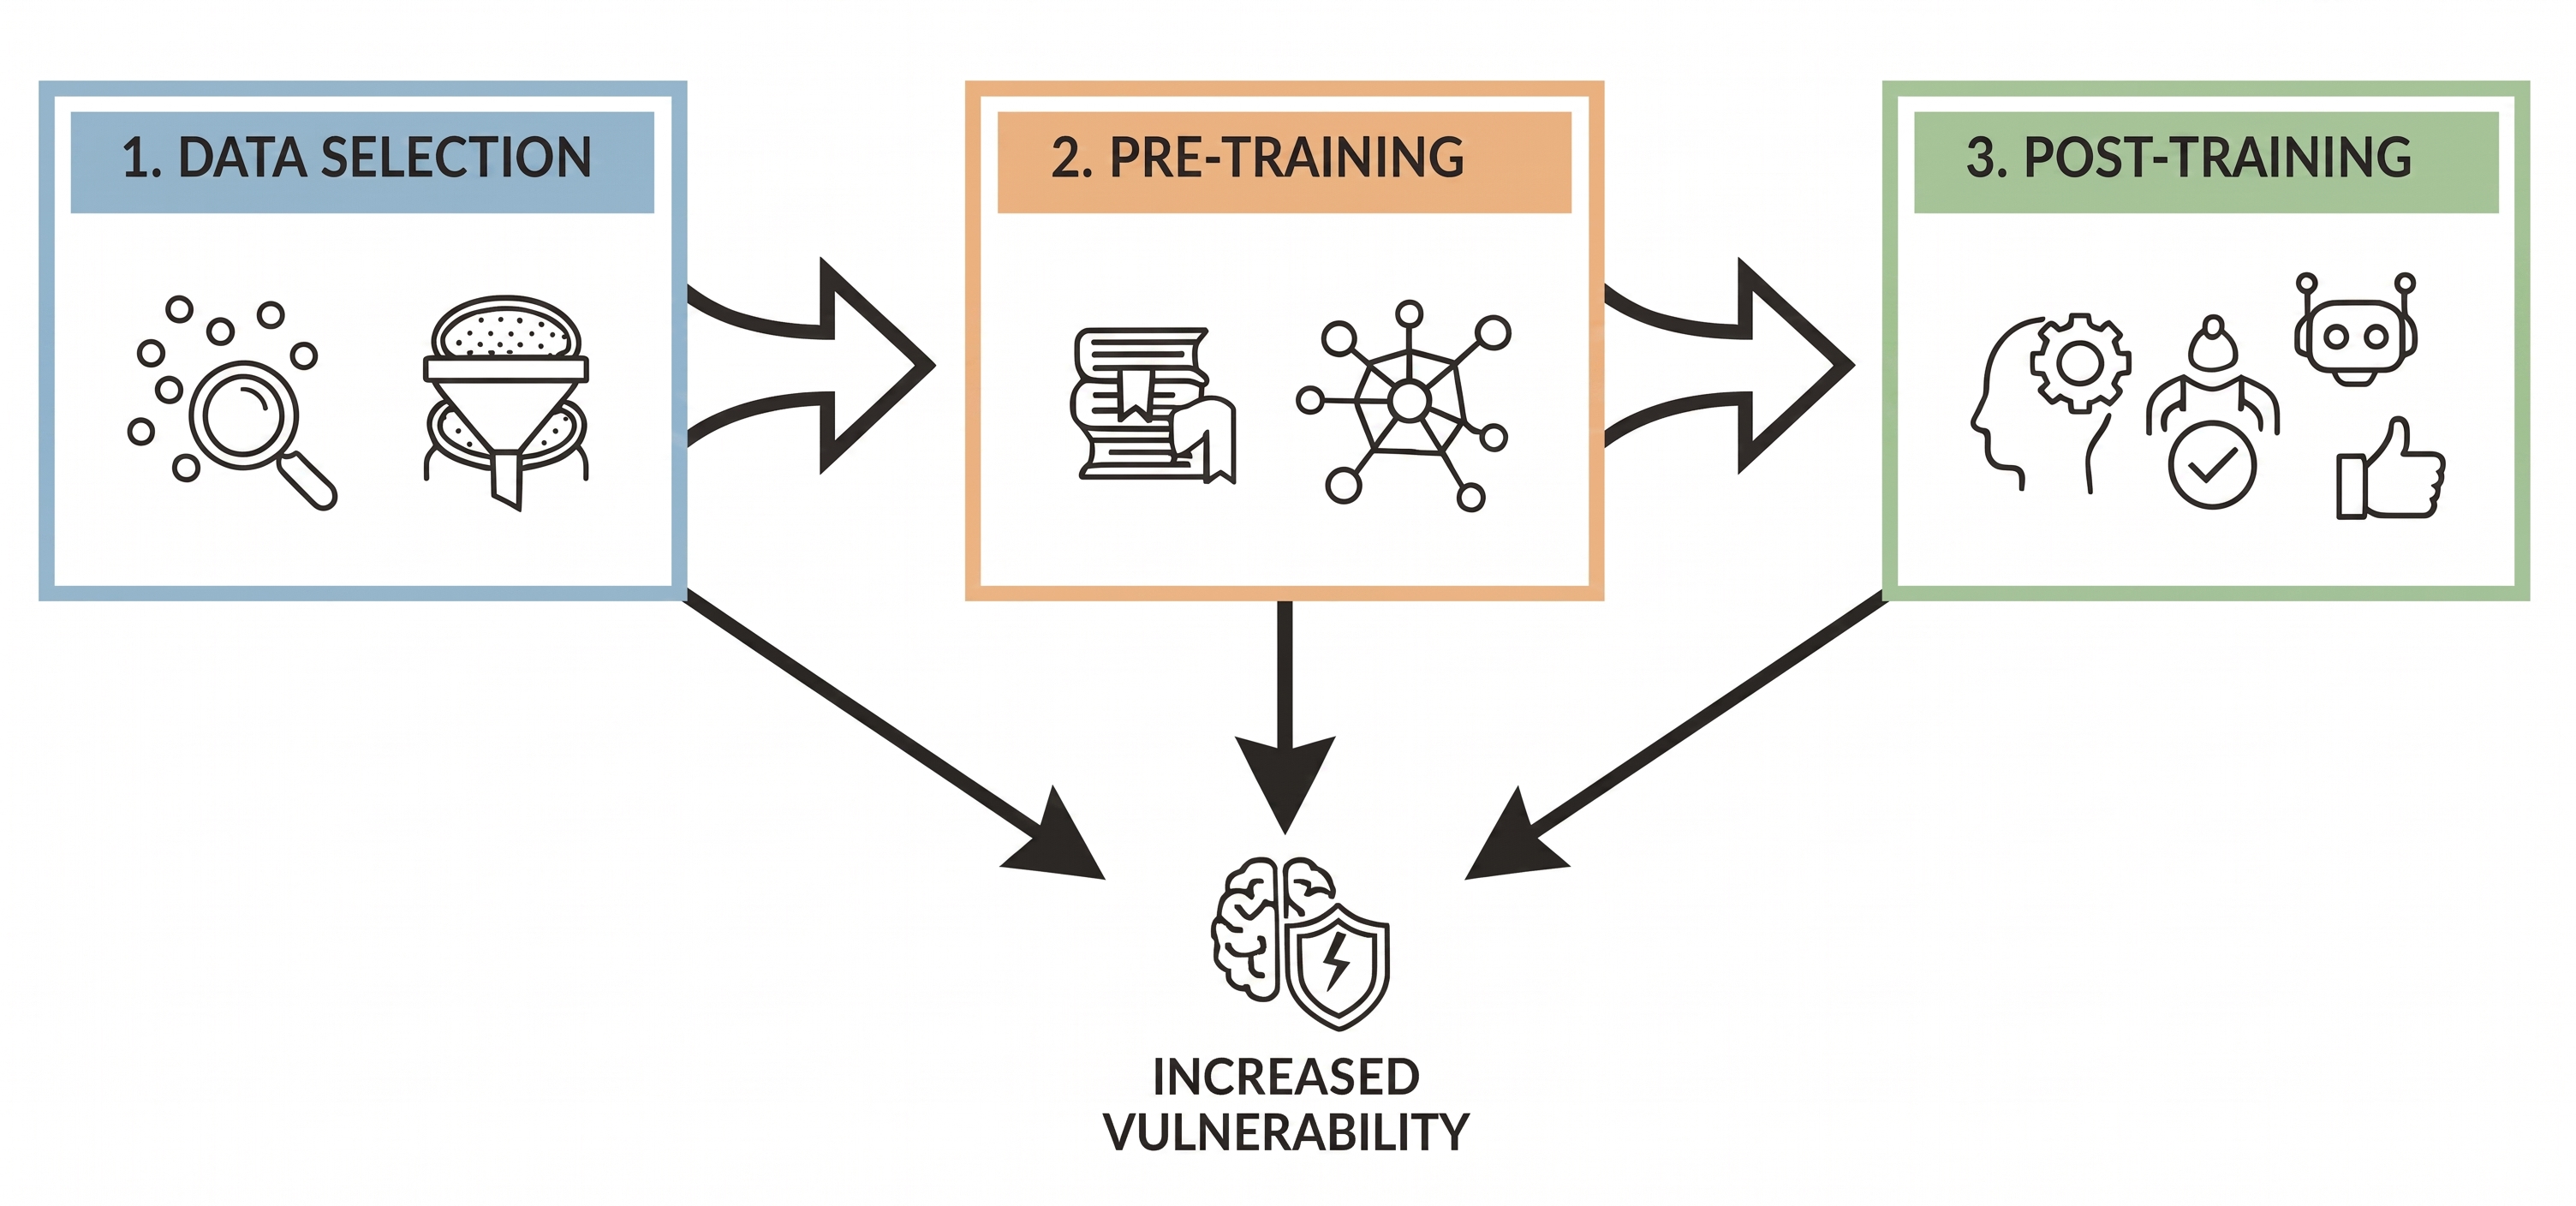
Сокращение данных и вычислений при обучении сохранило качество моделей, но сделало проверенные варианты уязвимее. В препринте CISPA и Institute of Science Tokyo, который не прошёл рецензирование и где числа получили сами авторы, самый заметный провал показала PRIME: после дообучения на IMDB её средний результат в математических задачах упал с 53,7 до 20,8. При выборе способа удешевить обучение теперь нужно отдельно проверять безопасность и устойчивость, а не только итоговую точность.
Команда сопоставила модели с близким качеством, но разными затратами на подготовку. Для компьютерного зрения она сравнила обучение на небольшой выборке важных примеров с более крупной выборкой, а дообучение готовой модели — с обучением с нуля. Затем модели атаковали: пытались определить, входил ли конкретный пример в обучающую выборку, изменить ответ небольшим искажением входных данных и воспроизвести модель по её ответам.
Во всех проверенных сравнениях отбор важных примеров повышал утечку данных и снижал стойкость к искажениям. Дообученные предобученные модели также чаще раскрывали состав выборки и хуже выдерживали атаку, чем модели, обученные с нуля при сопоставимой точности. Их функция потерь сильнее реагировала на небольшие изменения параметров, а уверенность хуже соответствовала реальной точности.
Для языковых моделей сравнили обычную Qwen2.5-Math-Instruct с SimpleRL и PRIME, где обучение с подкреплением начиналось без предварительного обучения на примерах и без явного ограничения отклонения от исходной модели. Упрощённые варианты сохраняли результат на чистых математических задачах, но хуже переносили изменённые формулировки, легче поддавались обходу ограничений и сильнее забывали математику после адаптации к отзывам IMDB.
Проверка охватила ResNet-18 и Swin на CIFAR-10, TinyImageNet и PubFig83, а также математические модели Qwen размером 7B и дополнительное сравнение на 32B. Работа сопоставляет готовые конвейеры целиком, поэтому результат показывает риск конкретных способов экономии, но не отделяет влияние каждого пропущенного этапа.
Источники
Иллюстрация: рисунок из статьи «No Free Efficiency: Revisiting the Trade-off Between Training Efficiency and Model Vulnerability», Yiyong Liu, Jun Sakuma, Michael Backes и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


