
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Память длинного контекста языковой модели научились сокращать в десятки раз, сохраняя все токены в кеше. Transformer-FSQ точнее других проверенных методов при экстремальном сжатии, хотя работа не прошла рецензирование и числа получили сами авторы. Для локального запуска это переносит узкое место с объёма памяти на переобучение проекций и поддержку специального вычислительного ядра.
Как целый KV-cache заменили одним кодом
При генерации модель хранит для каждого предыдущего токена кеш ключей и значений (KV-cache). Он нужен механизму внимания на каждом следующем шаге и растёт вместе с контекстом: у одной из моделей Qwen3 кеш на 200 тыс. записей занимает 21 ГиБ.
Обычные методы уменьшают эту память несколькими способами. Одни удаляют часть токенов, другие снижают точность чисел или проецируют ключи и значения в пространство меньшей размерности. Удаление необратимо теряет контекст, а отдельное сжатие ключей и значений сохраняет несколько представлений одного исходного состояния.
Transformer-FSQ ставит узкое место раньше. На каждом слое он преобразует состояние токена в короткий вектор, округляет его координаты до фиксированных уровней и упаковывает результат как целочисленный код. Кеш хранит только этот код — без таблицы кодов, масштаба и других метаданных для каждого токена.
Один код затем служит источником для всех ключей и значений слоя. Ключи приходится восстанавливать перед вычислением внимания, поскольку к ним привязана позиция токена. Значения можно восстановить позже: сначала ядро складывает коды с весами внимания, а затем применяет к результату линейную проекцию.
Метод встраивают в готовую модель. Исходные параметры замораживают, а обучают только новый кодировщик и проекции, которые восстанавливают ключи и значения. На дообучение использовали 0,25 токена на каждый исходный параметр модели.
Проверка охватила базовые модели Qwen3 размером от 0,6 до 8 млрд параметров. Transformer-FSQ сравнивали с удалением токенов, скалярным и векторным квантованием, а также с непрерывными проекциями меньшей размерности; качество проверяли на RULER и отдельных задачах LongBench.
Глубокое сжатие сохранило поиск по контексту
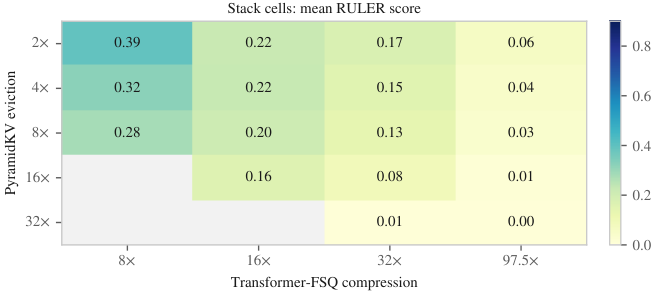
На RULER с контекстом 8192 токена Transformer-FSQ показал лучший результат среди проверенных методов в диапазоне сжатия от 12× до 97,5×. При умеренном сжатии преимущество оставалось у более простых методов: их не нужно подстраивать под столь узкий дискретный канал.
Сжатый кеш не замедлил декодирование пропорционально дополнительным вычислениям. При 32× объединённое ядро на Triton совпало по пропускной способности со стандартным вниманием в пределах погрешности. На верхней границе проверенного диапазона оно обрабатывало токены в 1,54 раза быстрее, поскольку читало из памяти значительно меньше данных.
Лучший результат среди конкурентов не означает качество несжатой модели. Чем уже код, тем меньше исходной информации он сохраняет, и оценка RULER постепенно падает. Transformer-FSQ выигрывает именно в области, где альтернативы теряют качество быстрее.
LongBench дал менее однозначную картину. В задаче NarrativeQA удаление токенов оказалось лучше на младших моделях, а на старшей Transformer-FSQ обошёл одну из непрерывных проекций. Поэтому результат сильнее всего подтверждает поиск и извлечение сведений из длинного контекста, но не одинаковое преимущество на любых прикладных запросах.
Экстремальное сжатие потребует отдельной сборки модели
Работа меняет планы продуктов, которым нужно удерживать длинную историю на локальном GPU: персональных помощников, автономных агентов и систем с несколькими параллельными диалогами. Здесь объём KV-cache напрямую ограничивает число сохранённых токенов, а Transformer-FSQ позволяет обменять дополнительные вычисления на меньший поток данных из памяти.
Это не подключаемый квантователь поверх готового API. Команде придётся конвертировать контрольную точку модели, дообучить новые проекции и поддерживать специальное ядро Triton. Если целевая среда не запускает такое ядро, преимущество по скорости нужно измерить заново, а не переносить из статьи.
При умеренном дефиците памяти менять архитектуру рано: альтернативы требуют меньше подготовки и сохраняют качество лучше. Transformer-FSQ становится кандидатом, когда нужен именно экстремальный режим и обычное снижение точности чисел уже не даёт нужной вместимости.
Показанная в статье максимальная ёмкость — расчёт по объёму памяти, а не проверка качества на всей заявленной длине контекста. Перед выбором метода стоит воспроизвести собственные сценарии: поиск по истории, работу с документами и параллельные последовательности, поскольку именно они определяют допустимую потерю качества.
Источники
Иллюстрация: рисунок из статьи «Transformer-FSQ: Discrete Latents for Extreme KV-Cache Compression», Andras Szecsenyi, Thomas L. Lee, Vaisakh Shaj и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


