
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
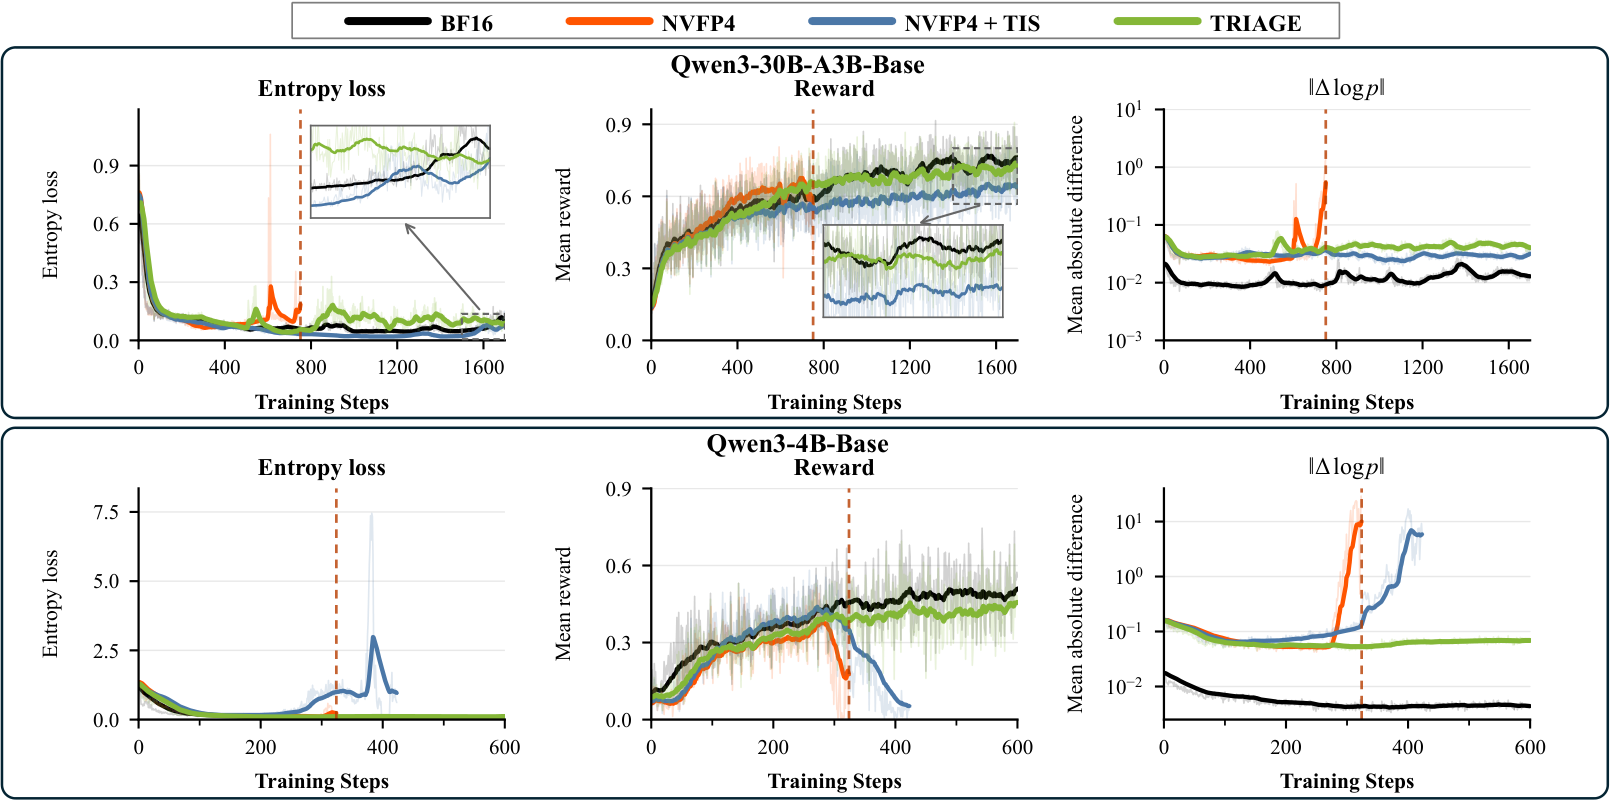
Низкоточное обучение с подкреплением научились стабилизировать без возврата к вычислениям BF16. В препринте, который не прошёл рецензирование, все числа получили сами авторы: TRIAGE сохранил качество уровня BF16 и ускорил генерацию обучающих ответов до 2,3 раза. Подход меняет диагностику таких сбоев: важна не только величина расхождения, но и то, куда его направляет следующий шаг обучения.
Почему среднее расхождение не предупреждает о сбое
В обучении с подкреплением (RL) одна версия модели генерирует ответы, а другая пересчитывает вероятности токенов и градиенты. Даже при синхронных весах пути вычислений различаются. Квантизация весов и активаций в NVFP4 усиливает эту разницу.
Авторы измеряют разрыв как разность логарифмов вероятности одного токена у обучаемой модели и генератора. Обычные методы коррекции, включая усечённую выборку по значимости, смотрят прежде всего на величину разрыва. TRIAGE дополнительно учитывает знак преимущества — показывает ли награда, что вероятность токенов ответа следует повысить или понизить.
Если ответ получил отрицательное преимущество, обучение снижает вероятности его токенов. Когда обучаемая модель уже оценивает токен ниже генератора, такой шаг увеличивает разрыв. Аналогично работает сочетание положительного преимущества с уже завышенной вероятностью. Два остальных сочетания, наоборот, сокращают расхождение.
Этот признак предупреждает о проблеме раньше общей статистики. В одном из прогонов доля токенов с небольшим разрывом оставалась не ниже 83%, но отношение двух типов усиливающих обновлений выросло с 1,02 до 2,32. По средней величине запуск ещё выглядел устойчивым, хотя градиенты уже систематически толкали модели в разные стороны.
Ошибка также собиралась локально. Ответы делили на отрезки по 64 токена; верхние 5% отрезков по концентрации проблемных токенов содержали примерно четверть всей такой массы. Среднее по полному ответу скрывало короткие участки, с которых позже начиналось общее расхождение.
Как TRIAGE меняет обновление модели
TRIAGE работает с функцией обучения, поэтому генератор и обучаемая модель продолжают выполнять прямой проход с четырёхбитными весами и активациями. Это отличает метод от обучения с имитацией квантизации, где часть вычислений сохраняют в более высокой точности.
Сначала система вычисляет для каждого отрезка средний разрыв вероятностей и долю токенов в отрицательном хвосте распределения. Эти признаки показывают, что ошибка не случайна, а удерживается внутри небольшой части ответа.
Затем TRIAGE ослабляет только обновления с отрицательным преимуществом и отрицательным разрывом. Остальные токены того же отрезка не блокируются: если их градиент сокращает расхождение, обучение использует его как прежде. После нормализации весов метод перераспределяет градиент внутри ответа, а не целиком отбрасывает подозрительный пример.
Одного ослабления недостаточно, поскольку оно может лишь приблизить вредный градиент к нулю. Поэтому для ответов с положительным преимуществом TRIAGE добавляет ограниченную поправку, которая поднимает слишком низкие вероятности обучаемой модели. Штраф растёт плавно и не позволяет исправлению безгранично вытеснять сигнал награды.
Практическая последовательность диагностики получается такой: записывать вероятности токенов на обоих вычислительных путях, связывать знак разрыва со знаком преимущества, агрегировать риск на коротких отрезках и только после этого менять веса градиентов. Маскирование всех токенов с большим разрывом может удалить обновления, которые уже исправляют ошибку.
Когда результат меняет планы обучения
Метод проверили на Qwen3-4B-Base и разреженной Qwen3-30B-A3B-Base, используя GPU B300 и пять задач на математические рассуждения. TRIAGE удерживал обучение устойчивым на всём рассмотренном промежутке и достигал среднего качества, сопоставимого с BF16. Полный цикл ускорился до 1,3 раза: выигрыш оказался меньше, чем при одной генерации, поскольку синхронизация параметров, расчёт масштабов квантизации и преобразования данных не ускорились вместе с матричными операциями.
Для команд, у которых генерация длинных ответов занимает основную часть цикла, работа даёт основание рассматривать нативный NVFP4 не только как режим вывода, но и как часть обучающего контура. В план эксперимента при этом нужно включать направленные метрики расхождения и замер полного цикла: одной средней ошибки вероятностей и пропускной способности генератора недостаточно.
Проверка охватывает синхронное обучение двух моделей и математические задачи. Более крупные модели, существенно длинные запуски и асинхронный контур, где к ошибке квантизации добавляется устаревание весов, в эксперименты не вошли. Поэтому TRIAGE пока служит конкретной схемой для Blackwell и похожих конфигураций, а не доказательством устойчивости любого четырёхбитного RL-обучения.
Источники
Иллюстрация: рисунок из статьи «TRIAGE: Direction-Aware Mismatch Stabilization of Native NVFP4 Reinforcement Learning», Zhen Li, Shuai Zhang, Yanggan Gu и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


