Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Механизм внимания для длинных запросов можно ускорить, если не считать все связи с одинаковой точностью. В препринте, который не прошёл рецензирование и содержит замеры самих авторов, Hanzhi Zhang и соавторы представили TriAttention: метод ускорил генерацию до 2,65 раза относительно базового варианта BF16, сохранив качество исходных моделей. Для команд с собственной инфраструктурой это открывает ещё один путь к длинному контексту без замены модели, но требует специального ядра и калибровки.
Какие связи можно не считать, а какие нельзя удалять
Разреженный механизм внимания обычно пропускает часть связей между токенами. Квантование сохраняет связи, но вычисляет их с меньшей точностью. Оба подхода экономят ресурсы, однако по отдельности принимают слишком грубое решение: либо удалить связь, либо обработать все оставшиеся одинаково.
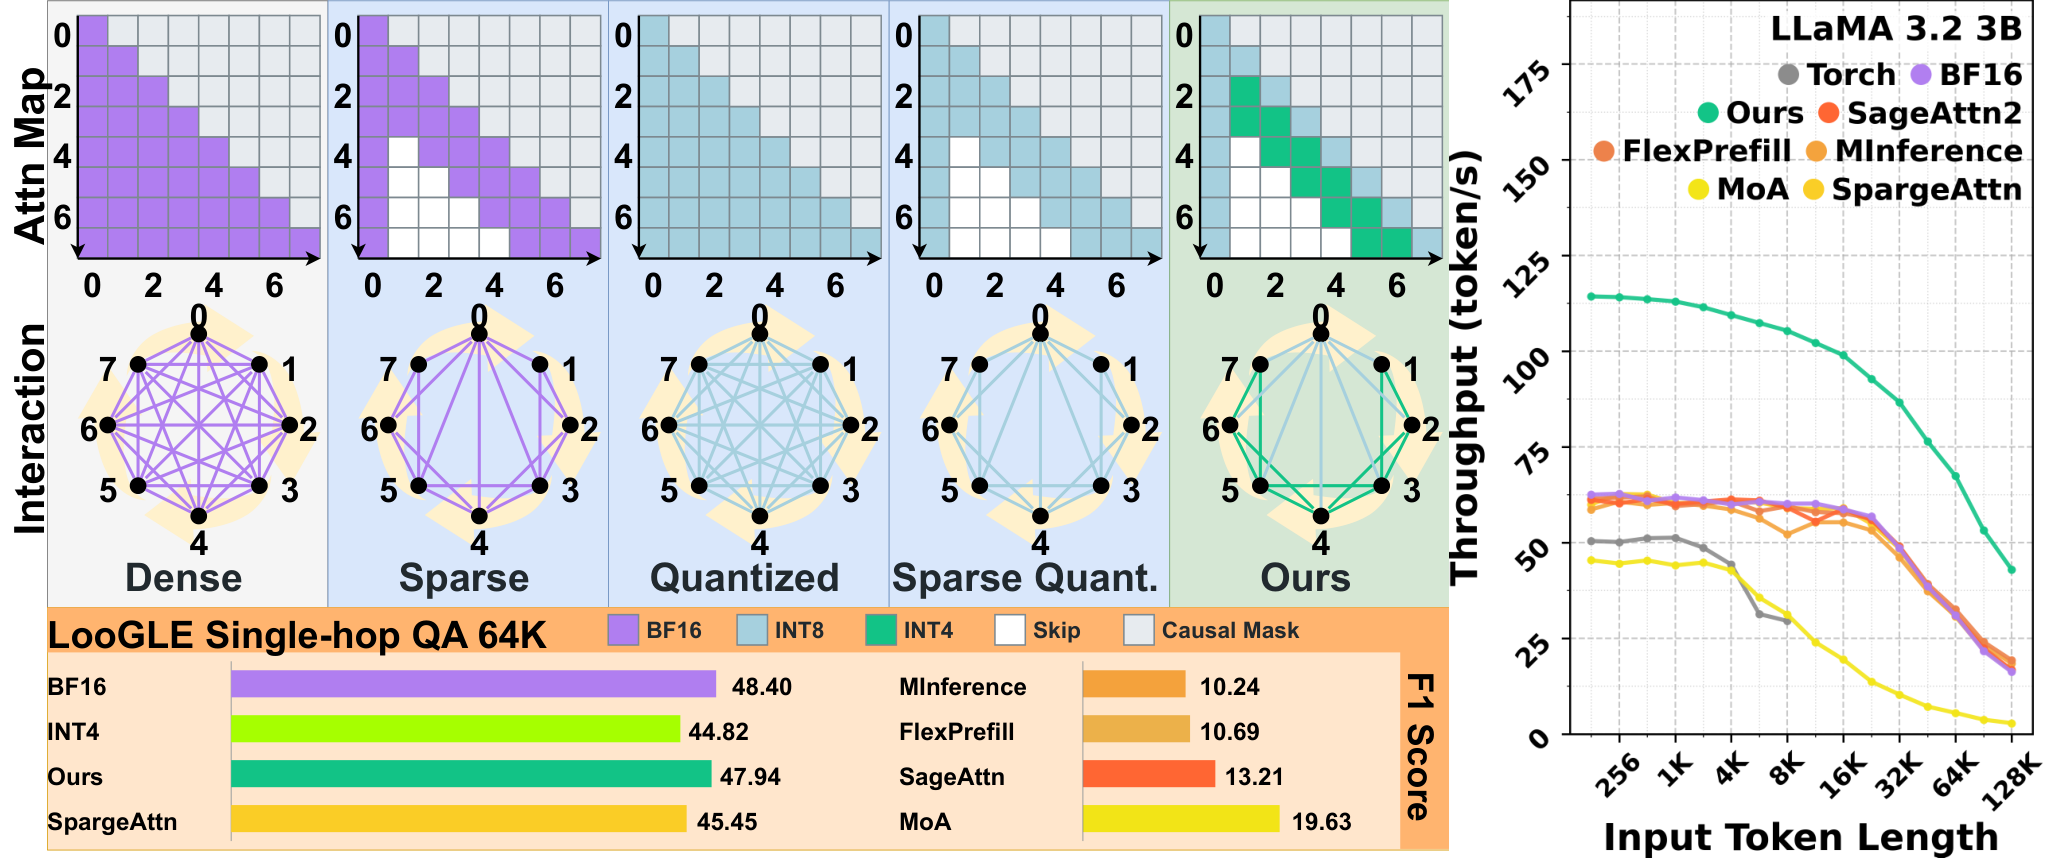
TriAttention назначает каждому блоку связей одно из трёх действий: пропустить, вычислить с точностью 4 бита или с точностью 8 бит. Средний вариант нужен для связей, которые нельзя удалить без потери смысла, но необязательно считать с повышенной точностью.
Выбор зависит от расстояния до диагонали матрицы внимания. Ближайшие блоки обычно получают повышенную точность, следующие — пониженную, дальние — пропускаются. Первый блок ключей и блок на самой диагонали защищены: их метод всегда сохраняет и обрабатывает с повышенной точностью.
Для каждой головы внимания политика хранит пару границ. Одна отделяет область повышенной точности от пониженной, другая — сохранённые блоки от пропущенных. Размер такого описания не растёт вместе с контекстом, тогда как явная карта действий увеличивалась бы квадратично.
Как калибровка распределяет вычисления между головами
Одинаковая граница для всей модели дала бы слабый результат: разные слои и головы по-разному реагируют на удаление и снижение точности. TriAttention заранее проверяет набор пар границ отдельно для каждой головы.
Метод измеряет не локальную разницу внутри головы, а ошибку после выходной проекции — там, где результат головы уже влияет на представление, которое получает следующий слой. Ошибку нормализуют относительно энергии выхода слоя, поэтому чувствительность разных участков модели можно сравнивать напрямую.
Каждому варианту также назначают вычислительную стоимость. Она учитывает целый обработанный блок, включая умножение запросов и ключей, нормализацию весов и агрегацию значений. Затем общий распределитель оставляет больше контекста или повышает точность там, где дополнительная работа сильнее уменьшает ошибку.
Выбранные границы используются на обеих стадиях вывода. При обработке исходного запроса объединённое GPU-ядро группирует сохранённые блоки по точности и сводит их в один нормализованный результат. Подготовленные ключи и значения затем попадают в сжатый кэш ключей и значений (KV-кэш), чтобы при пошаговой генерации модель реже читала полный объём данных запроса.
Когда TriAttention меняет планы инфраструктуры
Максимальное ускорение относительно штатного механизма внимания Torch составило 7,88 раза, а относительно 16-битного варианта BF16 — 2,65 раза. На общих задачах и вопросах по длинному контексту качество осталось на уровне исходных моделей.
Метод проверяли на семействах Llama, Qwen и Ministral, на GPU A100, H100 и RTX 4090. Эксперименты охватывали разные размеры пакета, длины ответа и запросы до 65 536 токенов. Сравнения относятся к собственным ядрам TriAttention, поэтому цифры нельзя переносить на другой стек только по названию модели.
Для сервиса с длинными документами, локальным развёртыванием и заметными расходами на GPU работа может изменить технический план. Вместо перехода на меньшую модель или жёсткого окна контекста можно сохранить дальние связи с пониженной точностью, а удалить только менее полезные блоки.
Цена этого решения — собственный путь исполнения. Нужно откалибровать границы для модели, встроить объединённые ядра обработки запроса и генерации, а также поддержать особую раскладку KV-кэша. Простая замена одной настройки в стандартном сервере вывода такого эффекта не даст.
Политика TriAttention задаётся заранее через расстояние между блоками и не ищет важные фрагменты заново для каждого запроса. Это делает исполнение предсказуемым и уменьшает служебные расходы, но связывает выигрыш со структурой внимания, которую калибровка увидела на выбранных данных.
Источники
Иллюстрация: рисунок из статьи «TriAttention: Unified Sparse Mixed-Precision Attention for Long-Context LLM Inference», Hanzhi Zhang, Qiao Zhang, Qinglei Cao и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.