
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Решение для LLM-агента научились собирать из шагов, найденных в разных попытках, даже если модель ни разу не выполнила всю цепочку целиком. Алгоритм TROPIC обошёл лучшие базовые методы на величину до 16,2 процентного пункта, хотя препринт не рецензирован и все числа получили сами авторы. Для практических систем это предлагает другой способ учиться на частично удачных действиях, но требует хранить и воспроизводить состояние среды.
Почему сумма вероятностей теряет полезные шаги
Обычное обучение с подкреплением максимизирует ожидаемую награду. Для задачи с автоматической проверкой оно складывает вероятности всех успешных траекторий и тем самым отвечает на вопрос, как часто текущая модель выдаёт верный результат.
Такая цель не показывает, какое именно решение сработало. Она также награждает только траекторию, которую модель выполнила от начала до конца. Верный префикс из одной попытки и верное продолжение из другой остаются двумя отдельными наблюдениями, даже если вместе дают решение.
Нормировка вероятностей создаёт ещё одну проблему. Когда обучение усиливает один успешный вариант, вероятность другого может снизиться, хотя проверяющий механизм его не опровергал. Полезный, но редко встречающийся шаг постепенно исчезает из новых пакетов попыток.
Tropical Reinforcement Learning заменяет сложение вероятностей альтернативных путей на выбор максимума. Значением состояния становится логарифм вероятности самого доступного проверенного продолжения. Это значение соответствует конкретному пути: его можно восстановить, повторно выполнить и использовать при построении других решений.
Авторы доказывают, что максимум следует из двух требований. Значение должно указывать на существующий проверенный путь и не должно снижаться, когда система находит ещё один путь. Сложение не выполняет первое требование, а выбор минимума — второе.
Как TROPIC соединяет попытки через общее состояние
TROPIC сохраняет переходы, которые агент обнаружил в успешных и неуспешных запусках, и строит из них граф. Если лучший префикс заканчивается в том же состоянии, с которого начинается лучший проверенный суффикс, алгоритм соединяет их. Полную последовательность после этого заново выполняют и оценивают, поэтому склейка сама по себе не считается доказательством успеха.
Такой подход работает, только если состояние полностью определяет доступное продолжение. Среда должна быть детерминированной, допускать возврат в сохранённую точку и иметь автоматическую проверку результата. В состояние также включают номер шага, чтобы граф не содержал циклов.
После поиска алгоритм обучает модель на лучшем собранном пути. В отличие от цели с ожидаемой наградой, повторное обнаружение того же вычисления ничего не добавляет, а найденный ранее путь остаётся в архиве. Фрагменты не обязаны происходить из успешных запусков: достаточно, чтобы их переходы вошли в решение, которое затем прошло проверку.
Метод проверяли с Qwen-2.5-3B-Instruct и Gemma 4 E4B-it на Sokoban, Countdown, FrozenLake и WebShop. Для сравнения использовали PPO, GRPO, DAPO и SNR-Aware при одинаковом бюджете попыток, представлении наблюдений и вычислительных условиях; качество измеряли на отложенных заданиях.
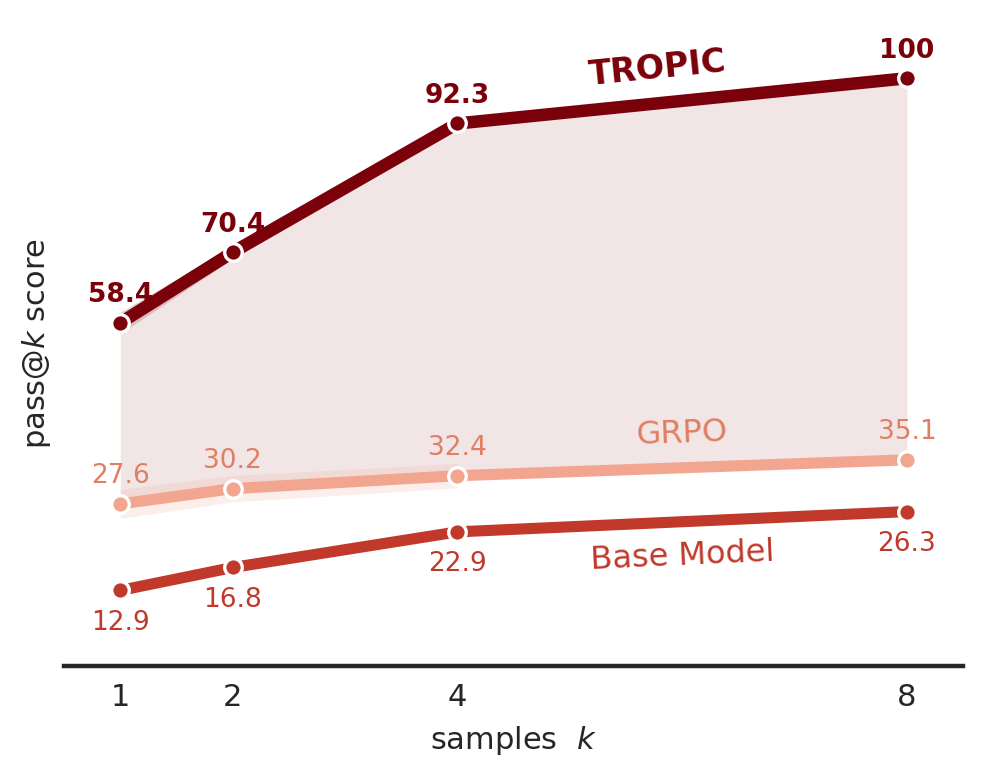
Самый крупный выигрыш получился в Sokoban с Qwen. В отдельном разборе компонентов полный TROPIC достиг успешности 58,4%, а отключение соединения фрагментов снизило её до 40,8%. Для 31,6% решённых примеров первое проверенное решение удалось собрать раньше, чем модель самостоятельно выдала успешную траекторию целиком.
Когда метод меняет план разработки агента
Работа даёт основание проверить TROPIC там, где агент действует в воспроизводимой среде, получает точный итоговый вердикт и часто находит полезные промежуточные шаги. Это задачи с кодом и тестами, головоломки, вычисления, планирование и управляемые интерфейсы, если их состояние можно надёжно сериализовать.
Замена функции обучения сама по себе не даст описанного эффекта. Команде понадобятся архив переходов, каноническое представление состояния, запуск с промежуточной точки и повторная проверка собранного пути. Если внешний сервис меняется между вызовами или результат зависит от скрытой истории, два визуально одинаковых состояния нельзя безопасно соединять.
Теоретическая гарантия также уже практической реализации. Она строго работает для модели с независимыми параметрами в каждом состоянии. У LLM параметры общие: обучение на одном пути может изменить поведение в других состояниях, поэтому сохранение найденных возможностей обеспечивает прежде всего внешний архив, а не только веса модели.
Результаты охватывают две модели и четыре детерминированные среды с автоматической проверкой. Они поддерживают экспериментальную ветку для агентов с редкими полными успехами, но пока не обосновывают замену обычного обучения с подкреплением в открытых, необратимых или субъективно оцениваемых процессах.
Источники
Иллюстрация: рисунок из статьи «Tropical Reinforcement Learning», Arip Asadulaev, Aladin Djuhera, Karim Salta и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


