
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
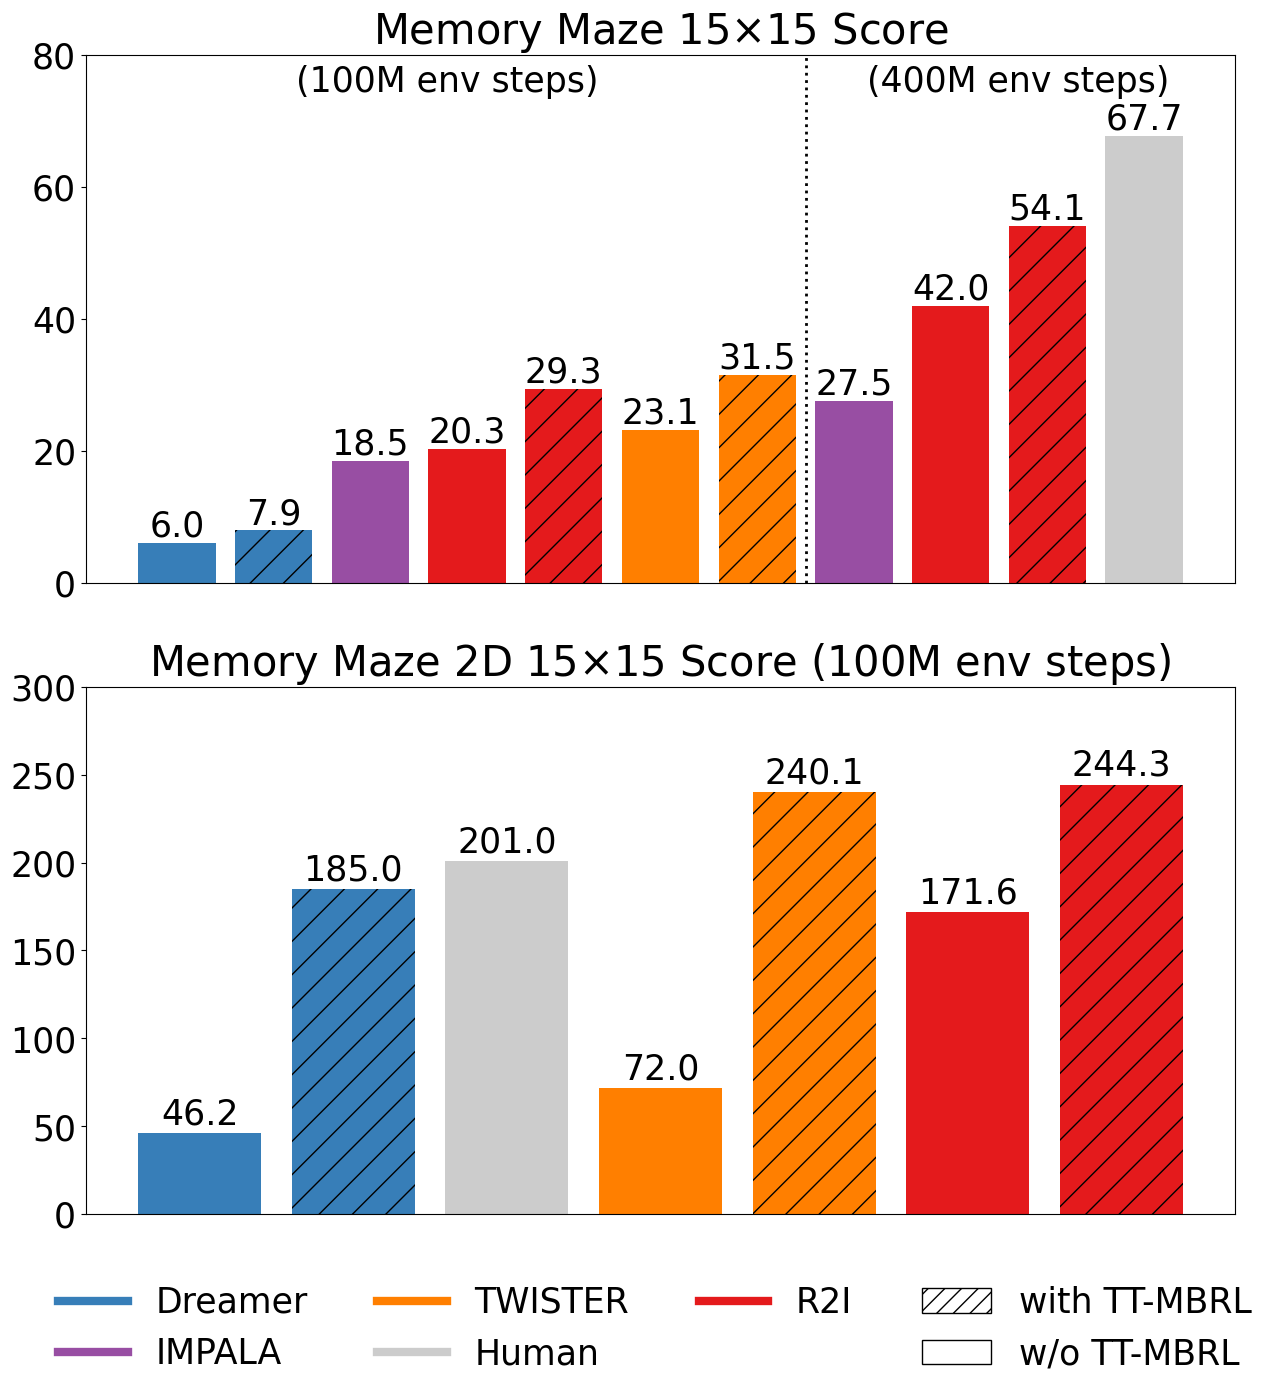
Агента с моделью мира научили сохранять сведения о текущем эпизоде не только в контексте, но и в параметрах нейросети. В препринте, который не проходил рецензирование и содержит замеры самих авторов, R2I с новой схемой получал на 53,7% больше награды за каждый шаг после 4000 действий в Memory Maze 15×15. Для команд это открывает альтернативу наращиванию контекста: агент может подстраивать память во время работы, если допустимы дополнительные вычисления.
Каждый эпизод получает свою модель мира
Модель мира учится предсказывать, как среда изменится после действия агента. Политика использует эти предсказания, чтобы мысленно проверить будущие траектории и выбрать действие без перебора вариантов в реальной среде.
Обычно параметры такой модели остаются общими для всех эпизодов. Сведения о конкретной сессии живут во внутреннем состоянии сети или в доступном ей контексте. В частично наблюдаемой среде этого недостаточно: агент видит только ближайший участок, а ошибка в сохранённой истории постепенно искажает прогноз.
TT-MBRL меняет параметры модели прямо во время проверочного эпизода. В его начале агент копирует обученные параметры, создаёт отдельный буфер опыта и складывает туда новые наблюдения, действия и награды. После очередного взаимодействия градиентный спуск подстраивает модель мира, политику и оценщик ценности под текущую среду.
Обновления используют смесь старого и нового опыта: одну половину траекторий берут из обучающего буфера, другую — из текущего эпизода. Старые примеры не дают модели слишком быстро подогнаться под несколько первых наблюдений. Для каждого следующего эпизода изменения сбрасывают, поэтому память не переносится между независимыми средами.
Кодировщик и декодировщик изображений при этом замораживают. Они продолжают переводить кадры в скрытые представления и обратно, а сведения о расположении объектов записываются в последовательную часть модели и в блок, который предсказывает динамику. Такой выбор сокращает вычисления и не заставляет сеть заново учиться распознавать одни и те же визуальные элементы.
Параметрическая память помогла на длинных маршрутах
На упрощённом Memory Maze 2D агент видит небольшой участок лабиринта сверху и должен помнить расположение целей за пределами текущего обзора. В самом крупном варианте результат R2I вырос со 171,6 до 244,3 балла. TT-MBRL также улучшил DreamerV3 и TWISTER, то есть эффект не зависел от одного типа последовательной архитектуры.
Прирост усиливался по мере накопления наблюдений внутри эпизода. Это соответствует устройству метода: в начале у отдельной модели ещё мало локального опыта, а затем параметры всё точнее описывают конкретный лабиринт. TT-MBRL не заменяет исходное обучение — он использует его результат как стартовую точку для временной специализации.
Проверка охватывает трёх представителей семейства Dreamer, двумерный и трёхмерный Memory Maze, а также DeepMind Control и Atari 100k. Первые среды специально требуют долгой памяти и планирования, последние в основном наблюдаемы целиком и показывают, как обновления ведут себя там, где хранить историю менее полезно. Поэтому работа подтверждает подход для игровых сред с повторяющимися действиями, но сама по себе не показывает его эффект в роботах или производственных агентных системах.
Архитектуру можно не менять, но вычисления переходят в рабочий контур
Работа не требует заменять рекуррентную сеть на Transformer или модель пространства состояний. TT-MBRL накладывается поверх существующего агента семейства Dreamer и использует ту же функцию потерь, с которой модель мира обучалась заранее. Это позволяет сначала проверить адаптацию на текущей архитектуре и только затем решать, нужен ли более длинный контекст.
Подход подходит для эпизодов, где среда долго сохраняет собственную структуру: лабиринт, симуляция, отдельная игровая сессия или продолжительная задача автономного агента. Если окружение меняется быстрее, чем модель успевает собрать опыт, временная специализация не успеет окупить вычисления.
Главный инженерный компромисс — градиентный спуск становится частью исполнения. В трёхмерном Memory Maze один эпизод R2I с замороженными кодировщиком и декодировщиком занимал 0,65 часа. В таблице нет сопоставимого времени обычного запуска без TT-MBRL, поэтому по работе нельзя рассчитать полный коэффициент удорожания относительно неизменяемой модели.
Менять планы стоит не на уровне базовой архитектуры, а на уровне контура исполнения. Если агент работает в длинных изолированных сессиях, полезно заложить отдельный буфер опыта, копию параметров на сессию, периодические обновления и сброс после завершения эпизода. Для систем с жёсткой задержкой или большим числом параллельных сессий сначала потребуется измерить стоимость такого обучения на целевом оборудовании.
Источники
Иллюстрация: рисунок из статьи «Encoding Memory in World Models with Test-Time Model-Based Reinforcement Learning», Maxime Burchi, Fayaz Ali Dharejo, Radu Timofte, CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


