
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
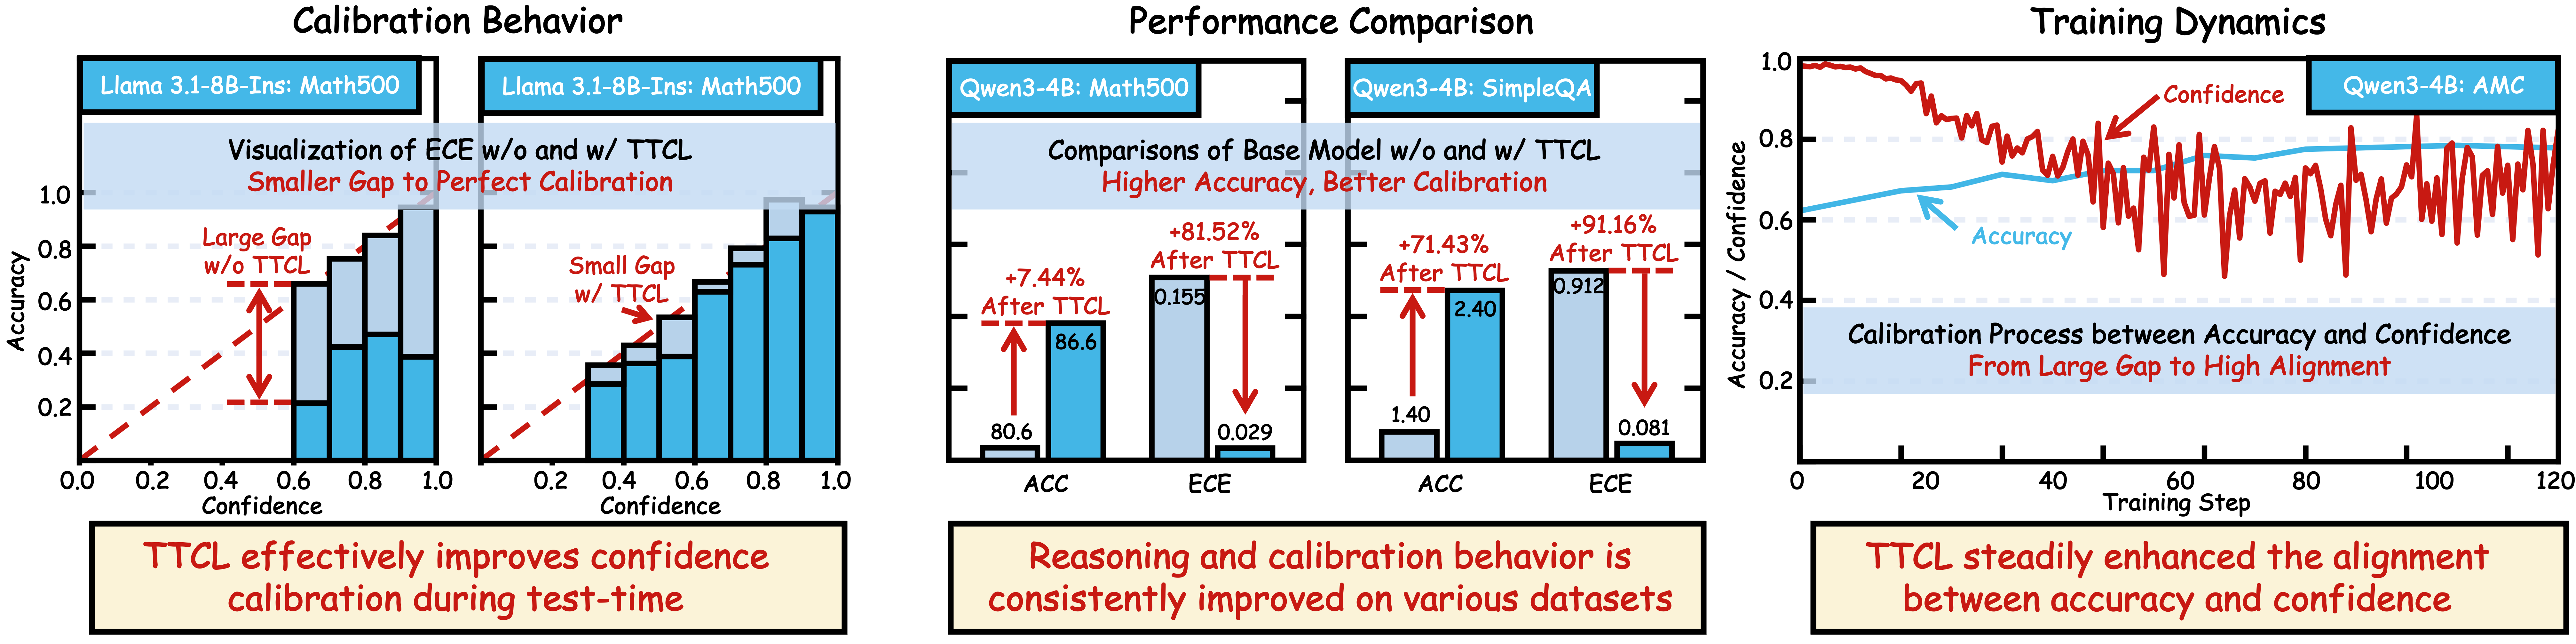
LLM можно подстроить под новую задачу так, чтобы она точнее отвечала и честнее оценивала собственную уверенность, даже без размеченных ответов. В нерецензированном препринте, где все числа получили сами авторы, Zizhuo Zhang и коллеги повысили среднюю относительную точность базовых моделей на 40,1% и снизили ошибку калибровки на 70,8%. Метод превращает работу модели в дополнительный этап обучения, поэтому подходит не каждому контуру применения.
Частота ответа заменяет правильную разметку
Калиброванная модель не просто выдаёт число рядом с ответом. Её заявленная уверенность должна совпадать с долей правильных ответов среди прогнозов такого уровня. Если модель почти всегда уверена, но часто ошибается, использовать её оценку для автоматического одобрения или передачи человеку нельзя.
TTCL строит обучающий сигнал из нескольких ответов модели на один вопрос. Самый частый итоговый ответ становится псевдометкой правильности: рассуждения, которые привели к нему, получают положительное вознаграждение. Настоящий ответ при этом системе не нужен.
Для уверенности авторы используют более подробный сигнал. Целевым значением становится доля генераций, которые завершились тем же ответом. Единогласие требует высокой уверенности, а несколько конкурирующих вариантов должны заставить модель снизить её.
Это отличает TTCL от варианта, где ответ большинства служит одновременно меткой правильности и уверенности. Такая двоичная метка теряет распределение сомнений: победивший вариант может лишь немного опережать остальные, но всё равно получает тот же сигнал, что и ответ с полным согласием.
Вознаграждения применяются раздельно. Сигнал правильности обновляет токены рассуждения и ответа, а сигнал калибровки — только токены, которыми модель сообщает уверенность. Иначе неудачная оценка уверенности могла бы штрафовать полезную цепочку рассуждений.
Кэш не даёт ошибочному большинству сразу усилить себя
Самообучение создаёт петлю обратной связи. Если несколько генераций случайно сошлись на неверном ответе, модель начинает чаще его повторять. Поддержка ответа растёт, вместе с ней повышается целевая уверенность, и ошибка закрепляется.
TTCL разрывает эту петлю с помощью кэша целей. Для каждого вопроса он хранит распределение ответов из предыдущих этапов обучения. Текущие генерации не задают награду немедленно, а постепенно обновляют кэш через экспоненциальное скользящее среднее.
Кэш задерживает сигнал, но не проверяет его по внешнему источнику. Если ответы модели систематически неверны и при этом согласованы, TTCL не получает способа обнаружить ошибку. Теоретическая гарантия тоже зависит от того, насколько частота ответа соответствует реальной вероятности его правильности: чем хуже эта замена, тем дальше обучающая цель от идеальной калибровки.
Когда TTCL меняет план внедрения
Метод проверили на Qwen3-4B, Qwen3-8B и Llama-3.1-8B-Instruct. В набор тестов вошли математические MATH500, AMC, AIME24 и AIME25, а также фактические SimpleQA, NQ, HotpotQA и TriviaQA. Сравнивали исходные модели, модели после TTCL и модели, которые ранее калибровали методом RLCR на другой предметной области.
При переносе калибровки с математики на вопросы о фактах TTCL дал относительный прирост точности на 20,35% и снизил ошибку калибровки на 53,83%. На NQ значение ECE, то есть среднего расхождения между уверенностью и фактической точностью, уменьшилось с 0,730 до 0,290.
Относительные улучшения не означают, что слабая модель стала пригодна для автономной работы. На SimpleQA лучший показанный результат после TTCL составил лишь 5,8% точности. Калибровка помогает распознать ненадёжный ответ, но не заменяет знания, которых у модели нет.
Работа меняет планы команд, которым нужна оценка уверенности на новых потоках данных, а разметку для каждого домена получить трудно. TTCL позволяет адаптировать модель прямо на целевых вопросах и может поддержать пороги автоматического принятия ответа или передачи задачи оператору.
За это приходится платить более сложным контуром: система многократно генерирует ответы, хранит распределения по вопросам и обновляет параметры модели. Это не внешний оценщик, который можно добавить к одному вызову API. При жёстких требованиях к задержке и запрете на дообучение TTCL придётся выносить в отдельный периодический процесс.
Практический вывод пока узкий: метод даёт способ калибровать небольшие reasoning-модели на неразмеченной математике и фактических вопросах. Перед переносом в продукт нужно отдельно проверить, не принимает ли модель устойчивую общую ошибку за надёжный консенсус.
Источники
Иллюстрация: рисунок из статьи «Test-time Calibration Learning for Large Language Model Reasoning», Zizhuo Zhang, Xiong Peng, Jingwei Sun и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


