Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
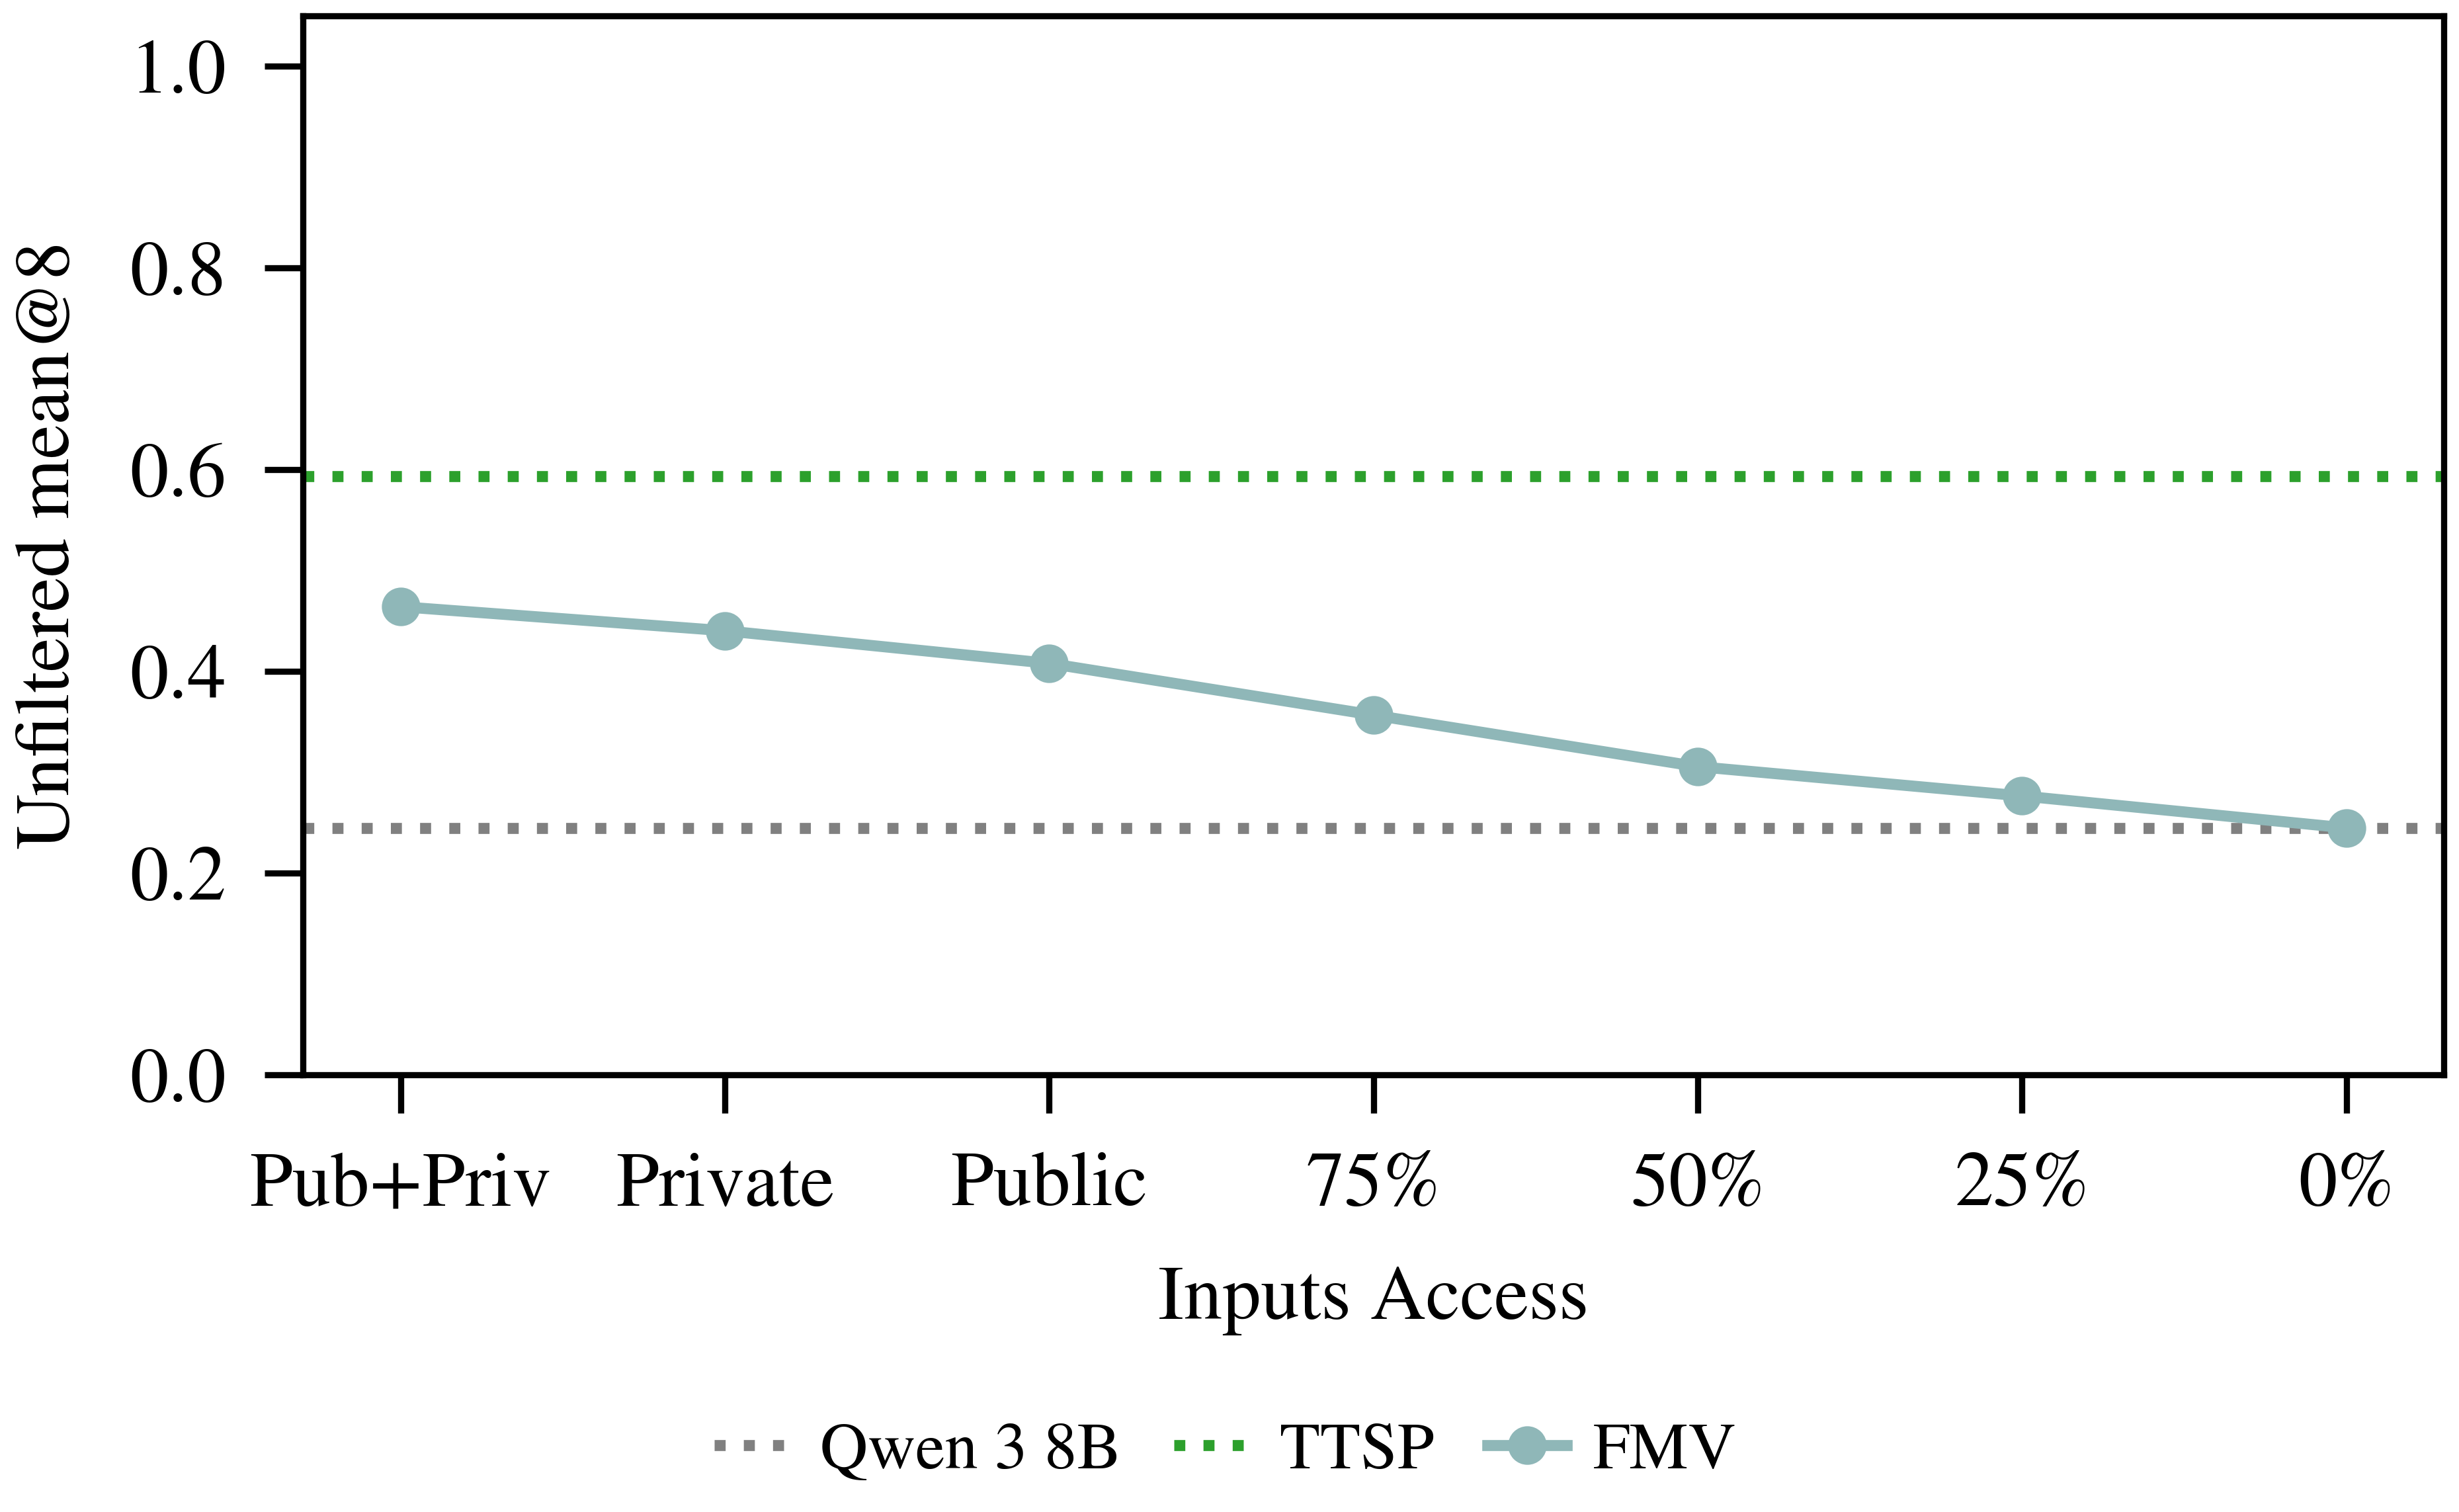
LLM научили улучшать ответ на одну сложную задачу за счёт дополнительных вычислений, не проверяя решения самой целевой задачи. В работе ETH Zurich и Tufa Labs метод TTSP без такой проверки повысил mean@8 на 35 процентных пунктов относительно сильнейшей альтернативы; препринт не рецензирован, а числа получили сами авторы. Схема подходит для случаев, где можно выполнять синтетические примеры, но нельзя надёжно оценить итоговый ответ.
TTSP строит вокруг целевой задачи отдельную учебную программу. Модель-постановщик создаёт связанные с ней задачи по программированию, эталонные программы и тесты, а модель-решатель пишет ответы. Интерпретатор запускает код и выдаёт двоичную оценку: решение прошло все тесты или нет. Проверка исходной целевой задачи в обучение не входит.
Постановщик получает большее вознаграждение за примеры на границе возможностей решателя: уже освоенные или почти нерешаемые задачи дают слабый обучающий сигнал. Обе роли работают как отдельные адаптеры LoRA поверх общей замороженной Qwen3-8B и обновляются через GRPO. После такого обучения решатель снова берётся за исходную задачу.
Метод проверяли на 28 задачах по соревновательному программированию из LiveCodeBench v6 и сравнивали с исходной Qwen3-8B, выбором решений по проверке, голосованием и методами настройки контекста. mean@8 здесь означает долю верных решений среди восьми кандидатов. TTSP выигрывал при всех исследованных уровнях проверки, а разрыв рос по мере её ослабления.
Схема работает, когда базовая модель хотя бы изредка находит правильное направление. На задачах, где её mean@512 не превышал 0,1, преимущество TTSP почти исчезало: синтетическая программа не помогала открыть решение, которого практически нет в исходном распределении ответов. Кроме того, модель адаптируется отдельно под каждую цель, поэтому вычисления нельзя автоматически распределить между множеством задач.
Источники
Иллюстрация: рисунок из статьи «Test-Time Self-Play: Scaling without a Verifier», Akira Yoshiyama, Akmal Ashirmatov, Jonas H\"ubotter и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.