
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Компьютерные агенты почти не выигрывают от попыток предсказать состояние интерфейса, если получают подходящий пошаговый туториал. В препринте, который не прошёл рецензирование и содержит замеры самих авторов, агент без прогноза будущего сравнялся с вариантами, которым показывали текстовый прогноз или реальный следующий снимок экрана. Для продуктовой команды это меняет приоритет: сначала стоит улучшить инструкции и выбор следующего действия, а не обучать отдельную модель мира.
Как разделили вклад туториала, оценщика и модели мира
Обычный компьютерный агент получает команду, смотрит на экран и выбирает действие: нажать кнопку, ввести текст или перетащить объект. Системы с планированием добавляют модель мира (world model): она предсказывает, что произойдёт после каждого возможного действия, а модель-оценщик выбирает лучший вариант по этим прогнозам.
Проблема прежних сравнений в том, что они одновременно добавляли туториал, оценщика и прогноз будущего. Поэтому рост доли выполненных задач нельзя было уверенно приписать модели мира.
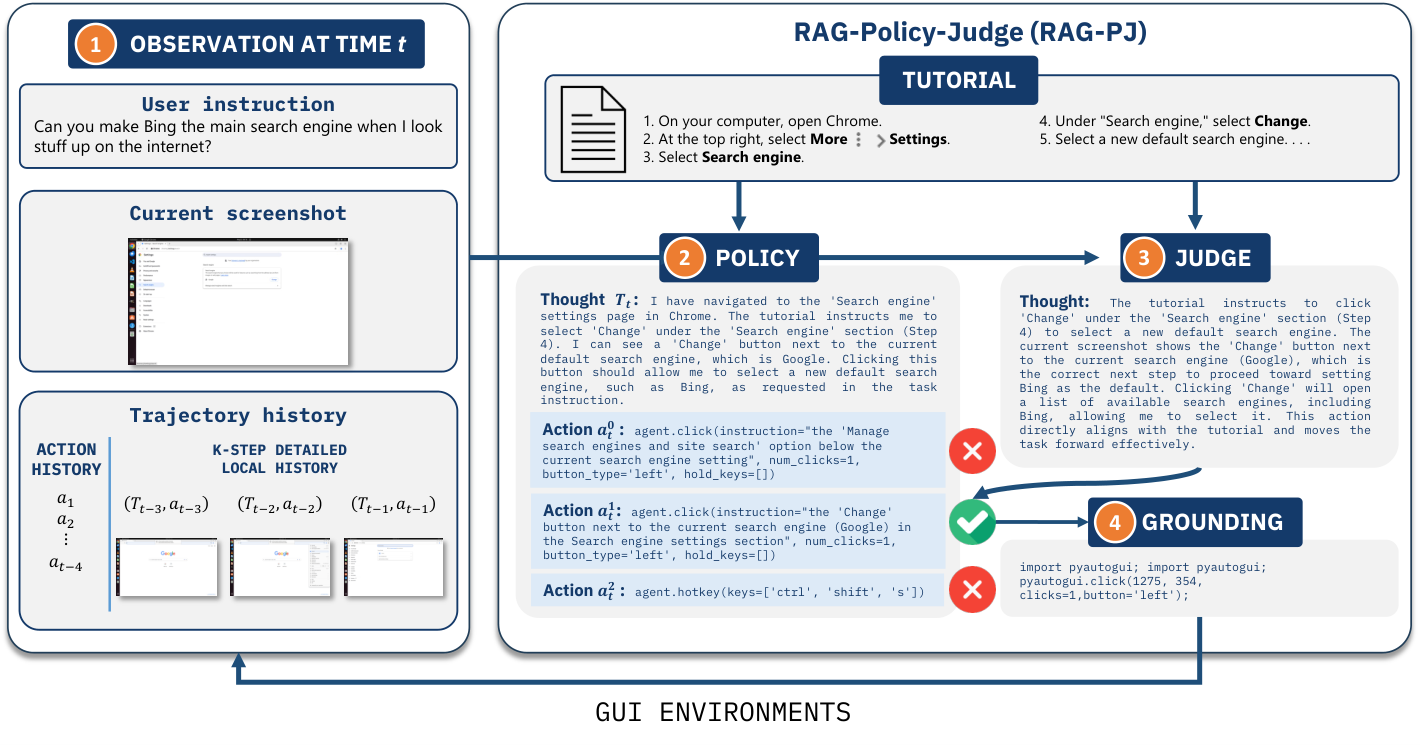
Авторы собрали RAG-PJ, где политика действий предлагает несколько вариантов, а оценщик ранжирует их. Оба модуля видят инструкцию пользователя, текущий экран, недавнюю историю и туториал по конкретной задаче. Выбранную команду отдельная модель UI-Venus-1.5 переводит в координаты мыши и нажатия клавиш.
Такую схему сравнили с двумя видами планирования. В первом модель описывала следующий экран текстом. Во втором агент получал реальный снимок будущего состояния из копии виртуальной машины. Этот вариант служил верхней границей качества предсказания: обучаемая визуальная модель не может показать будущее точнее, чем само окружение.
Точный будущий экран не помог выбрать действие
Без туториала прогнозы повышали долю выполненных задач до 4,2 процентного пункта относительно оценщика без модели мира. Когда тот же оценщик получал пошаговую инструкцию, преимущество почти исчезало. RAG-PJ без прогнозов показывал сопоставимый результат и с текстовой моделью мира, и с реальными будущими снимками.
Причина оказалась не только в качестве прогнозов. Даже видя точное будущее, оценщик неверно определял прогресс и момент завершения задачи. В одном примере он понимал, что прокрутка не приблизила агента к цели, но всё равно выбирал продолжение прокрутки. В другом после восстановления вкладки снова предлагал ту же команду, хотя нужное состояние уже наступило.
Туториал помогает двум частям системы сразу. Политика реже предлагает случайные действия, поскольку видит ожидаемую последовательность шагов. Оценщик получает ориентир, с которым может сопоставить кандидатов, поэтому прогноз следующего экрана добавляет меньше новой информации.
Проверка охватывала повседневные задачи OSWorld и работу с научными программами ScienceBoard. Для них подготовили 529 мультимодальных туториалов: часть нашли в интернете и проверили вручную, остальные сгенерировали через Gemini с доступом к поиску, исходному экрану и описанию задачи. В роли политики, оценщика и текстовой модели мира использовали модели семейства Qwen.
Командам стоит сначала усилить оценщика
Если продукт автоматизирует устойчивый процесс и для него можно получить актуальную инструкцию, отдельная модель мира теперь выглядит не первым вложением. Она увеличивает число вызовов моделей на каждом шаге: нужно разыграть несколько веток, оценить их и выполнить только выбранное действие. Работа показывает, что эти вычисления могут не окупиться, если туториал уже описывает путь к цели.
Практичный порядок разработки следует из самой схемы эксперимента. Сначала агенту дают инструкции по конкретным операциям. Затем политика предлагает несколько допустимых действий, а оценщик выбирает одно по текущему экрану, истории и туториалу. После этого стоит отдельно проверять, умеет ли оценщик замечать прогресс, ошибочные циклы и завершение задачи. Только если такая система упирается в неизвестные последствия действий, имеет смысл добавлять прогноз будущих состояний.
Вывод пока относится к задачам в виртуальных средах OSWorld и ScienceBoard, к семейству Qwen и к туториалам, привязанным к конкретной задаче. Эксперимент с реальными будущими снимками также проверяет предел точности прогноза, но не доказывает, что любая архитектура планирования бесполезна: оценщик мог не уметь извлечь пользу из показанного будущего.
Главный инженерный вывод поэтому уже, чем отказ от моделей мира. Для агента с хорошей инструкцией узким местом становится не предсказание интерфейса, а рассуждение о том, какое действие действительно продвигает процесс и когда работу пора остановить.
Источники
Иллюстрация: рисунок из статьи «Computer-Use Agents Gain Little Benefit from a World Model When Conditioned on Tutorials», Anh Nguyen, Tianyi Xu, Phat Tran и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


