
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Частые фрагменты текста научились сворачивать в одно представление прямо во время работы языковой модели. В работе University of Chicago и партнёров, которая не прошла рецензирование и содержит замеры самих авторов, UMIM сокращает эффективную длину последовательности до 40% с небольшим снижением точности. Для собственных систем инференса это способ уменьшить KV-кэш и объём вычислений без переобучения основной модели.
Как несколько токенов превращаются в один шаг
Transformer обрабатывает текст последовательно: каждый новый токен добавляет состояние в KV-кэш, а последующие токены обращаются к растущему контексту. При длинных запросах и ответах это увеличивает расход памяти и время вычислений.
UMIM ищет частые непрерывные сочетания длиной от двух до четырёх токенов. Если сочетания пересекаются, алгоритм выбирает самое длинное. Правила строят заранее по корпусу текстов и привязывают к токенизатору конкретной модели.
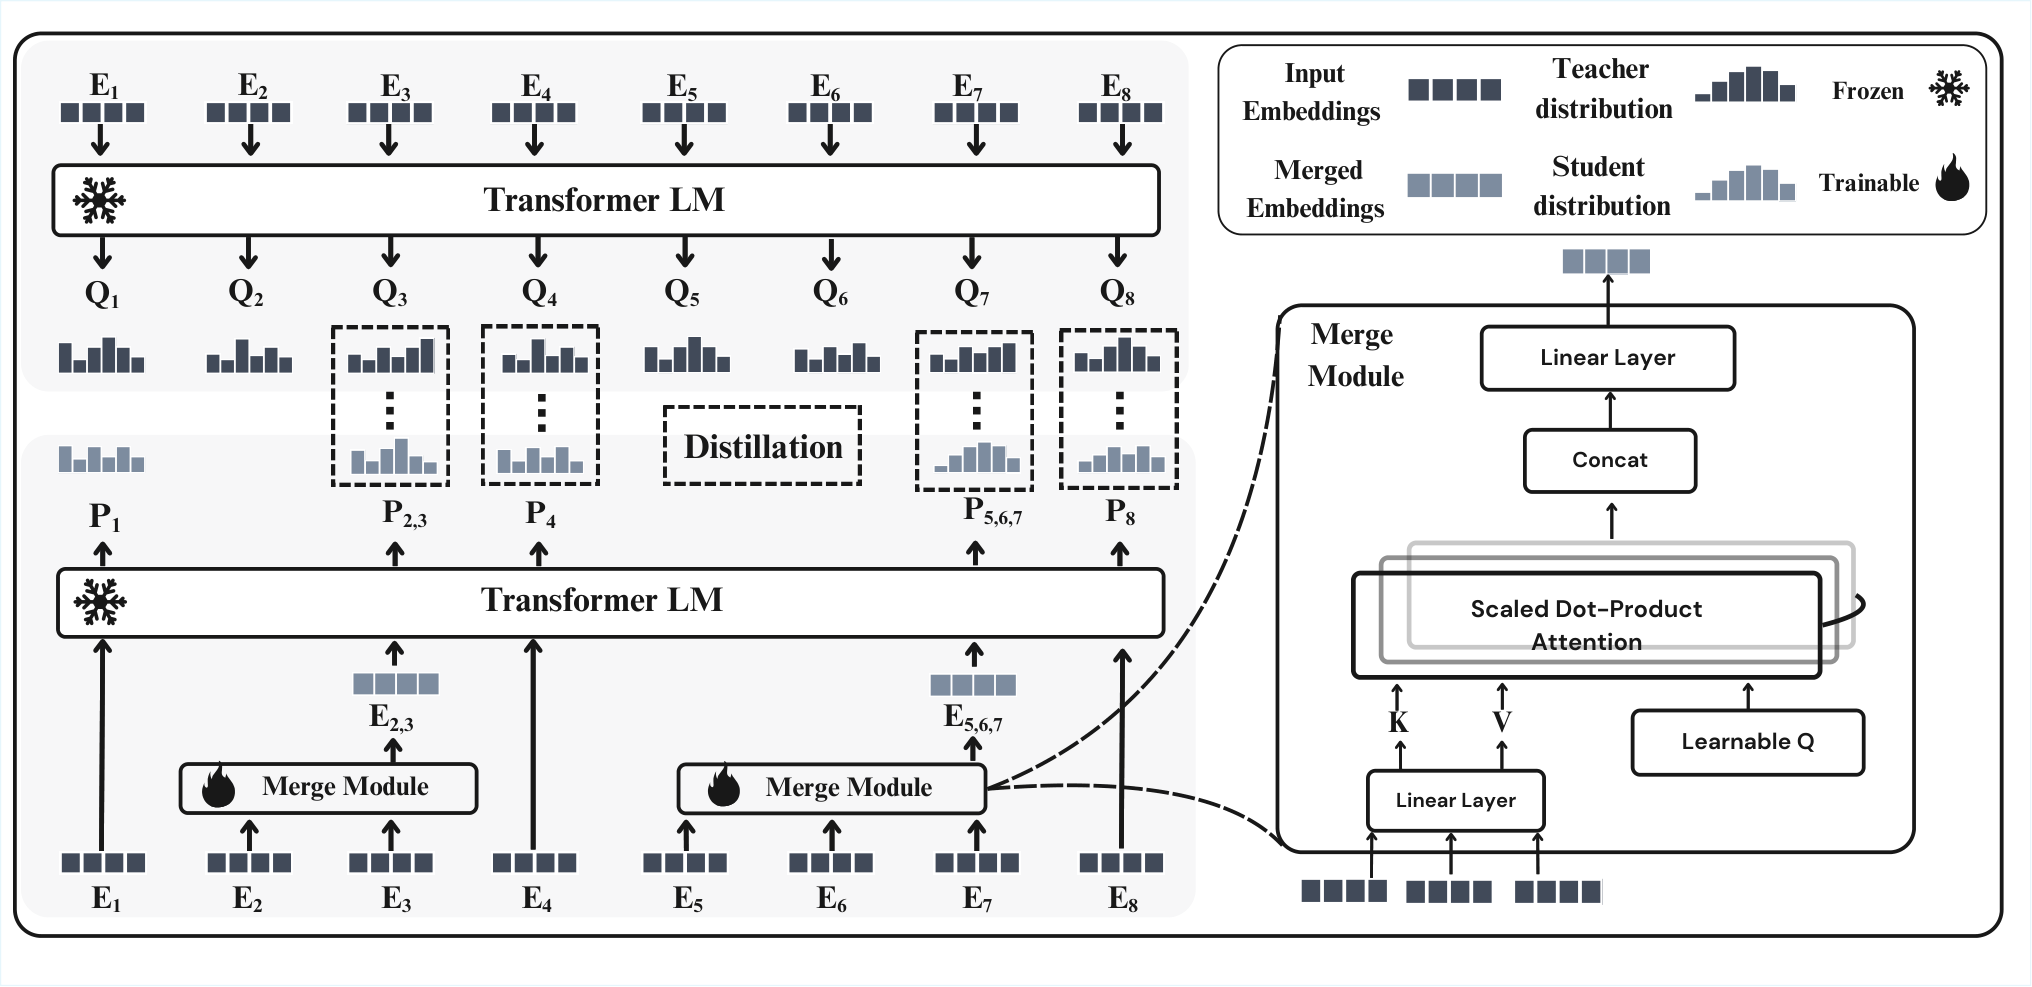
Небольшой модуль объединения получает статические представления токенов и создаёт один суррогатный вектор. Основная модель затем обрабатывает его вместо нескольких отдельных позиций. Модуль состоит из одного слоя внимания, а параметры исходной LLM при обучении остаются замороженными.
Модуль учат воспроизводить распределение вероятностей следующего токена, которое выдаёт несжатая модель. Он не обязан сохранять точный смысл каждого промежуточного состояния: достаточно, чтобы после замены модель продолжала предсказывать текст почти так же.
Для исходного запроса подход работает до первого прохода Transformer: найденные сочетания сразу заменяются суррогатами. При генерации модель по-прежнему выпускает каждый токен. Когда последние токены образуют известное сочетание, UMIM откатывает соответствующие записи KV-кэша и записывает вместо них одно объединённое состояние.
Это существенное отличие от удаления частей запроса. Текст не переписывают и не фильтруют по важности, а модель не пропускает токены ответа. Сокращается представление уже обработанного контекста, поэтому выигрыш должен накапливаться по мере роста последовательности.
Сжатие сохраняет поведение не на всех данных одинаково
Метод проверили на Llama 3.1 8B, Llama 3.2 1.5B, GPT2-XL и DeepScaleR-1.5B. Модули обучали на WikiText-103, а затем оценивали на моделировании языка, вопросах и ответах, суммаризации, здравом смысле, математических рассуждениях, программировании и длинном контексте.
В проверке распределений предсказаний эффективная длина последовательности сократилась на 35,7–54,0%. Первый по вероятности токен совпадал с результатом исходной модели в 69,6–79,2% позиций. Этот замер показывает, что суррогат приближает поведение нескольких шагов, но не воспроизводит его полностью.
Перенос между корпусами оказался слабее, чем работа на знакомых текстах. На BookCorpus и OpenWebText модуль без повторного обучения сократил последовательности на 12–15%. Частотные сочетания из WikiText-103 встречались там реже, поэтому один универсальный набор правил не даёт одинакового покрытия доменов.
Адаптация под задачу может одновременно вернуть точность и увеличить долю замен. На HellaSwag адаптированный модуль достиг точности 84,86% против 78,34% у несжатой основной модели. На ARC-Easy и ARC-Challenge точность также превысила исходный уровень, но для этого авторы заново собрали правила и дополнительно обучили модуль объединения.
Границы проверки проходят по четырём открытым моделям и выбранным наборам задач. Размер основной модели доходил до Llama 3.1 8B, а правила строились из частых сочетаний конкретного токенизатора. Результаты нельзя напрямую переносить на более крупные модели, другой язык или специализированный производственный трафик.
Когда UMIM меняет архитектурный план
Работа не отменяет переобучение полностью. Не нужно менять веса основной LLM, но для каждой совместимой модели требуется обученный модуль объединения. При переходе на другой токенизатор придётся заново построить правила, а для узкого домена может потребоваться адаптация на его текстах.
Метод подходит командам, которые сами управляют инференсом и могут вмешаться в подготовку входных представлений и KV-кэш. Для закрытого API клиент не контролирует эти части конвейера, поэтому встроить UMIM снаружи не получится.
Основной кандидат — сервис с длинными запросами или ответами, где память под KV-кэш ограничивает размер пакета и число одновременных сессий. Здесь можно добавить модуль рядом с моделью, не менять архитектуру Transformer и проверить компромисс между качеством, задержкой и памятью на собственном трафике.
Планировать экономию только по сокращению последовательности нельзя. Модуль сам выполняет вычисления, проверяет совпадения и изменяет кэш, а реальный выигрыш зависит от длины контекста, оборудования и реализации. Перед внедрением нужен сквозной тест всего сервера, а не только сравнение точности на бенчмарке.
Практический вывод уже можно использовать при проектировании: слой сжатия контекста необязательно встраивать в обучение основной модели. Его можно сделать отдельным компонентом инференса, сохранить возможность обновлять LLM и независимо настраивать правила под домен. Но пока это направление для прототипа, а не готовая замена обычному KV-кэшу.
Источники
Иллюстрация: рисунок из статьи «Distilling Sequential Computation in Transformer Language Models», Zixuan Lan, Jessica Yang, Yanhong Li и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


