
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Продолжения одного шага в дереве рассуждений часто повторяют друг друга, поэтому часть ветвей можно не раскрывать. Команда Nanyang Technological University предложила UAA: в нерецензированном препринте, где все числа получили сами авторы, метод сократил расход токенов до 90%, а задержку ответа — до девяти раз при сопоставимой точности. Команды, которые уже масштабируют рассуждение через дерево поиска, могут перераспределять вычисления без обучения дополнительной модели.
Сходство соседних ветвей предсказывает лишний поиск
Древовидный поиск не заставляет LLM сразу выбрать единственную цепочку рассуждений. На каждом шаге модель предлагает несколько продолжений, алгоритм оценивает их и раскрывает наиболее перспективные ветви. Beam Search поддерживает набор лучших вариантов, а MCTS многократно обходит дерево, сочетая проверенные и новые направления.
Обычно каждому сохранённому узлу выделяют одинаковое число продолжений. Простой шаг получает столько же вычислений, сколько неоднозначный: модель снова генерирует близкие формулировки, которые приводят к одним и тем же ответам. В исходном опыте на GSM8K косинусное сходство большинства продолжений из общего состояния превышало 0,95.
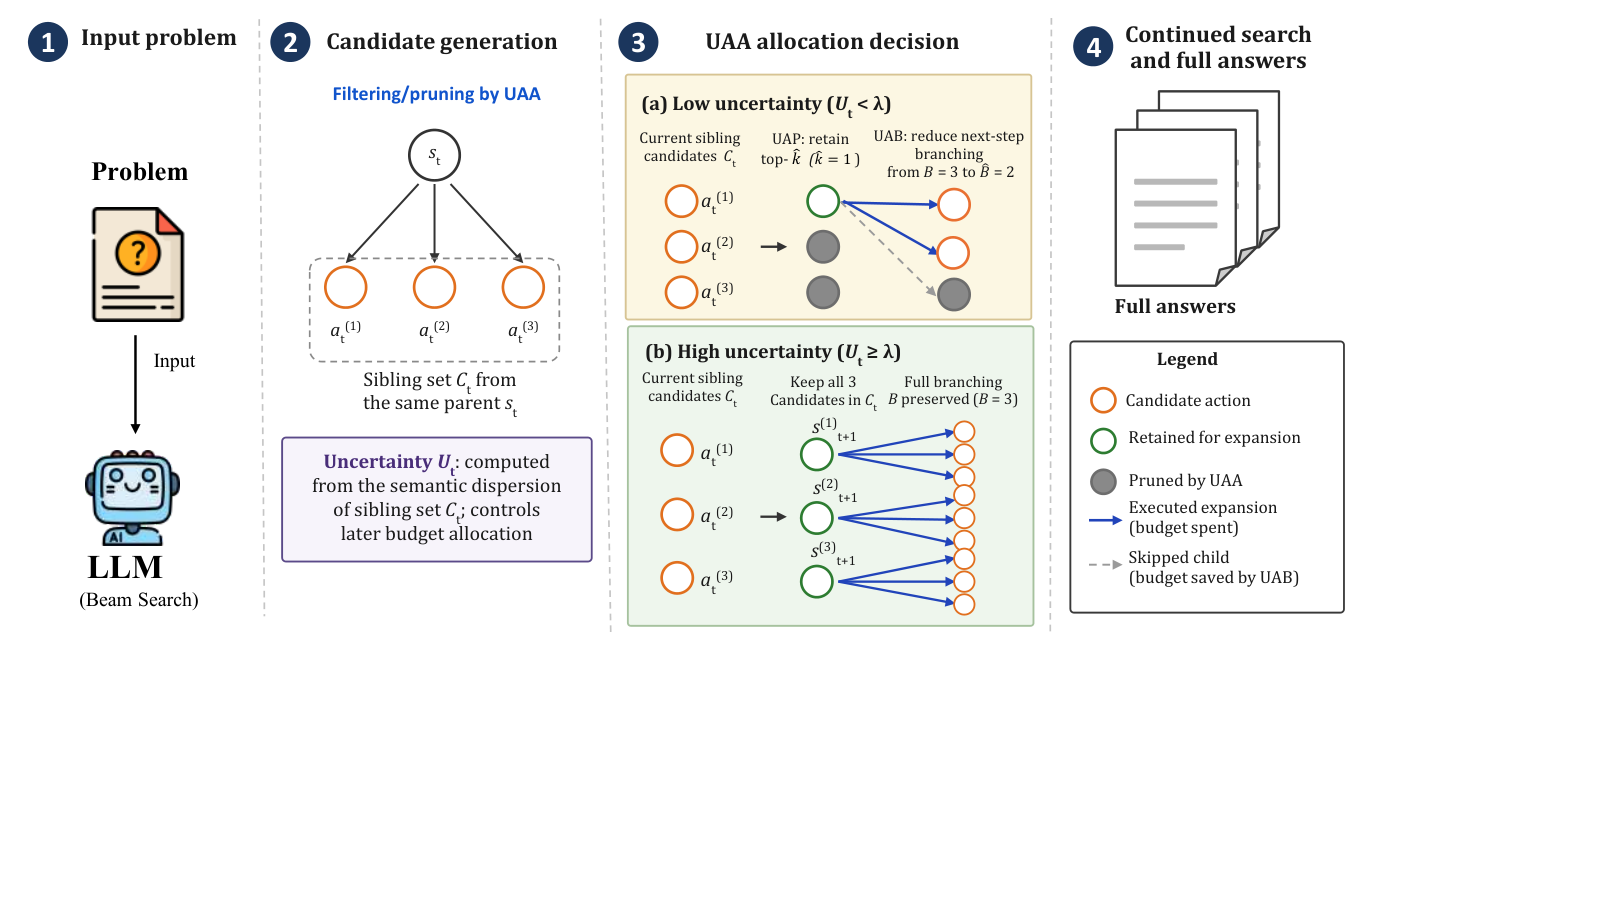
UAA измеряет разнородность соседних действий до раскрытия поддерева. Для каждого текста берут векторное представление, сравнивают все пары и усредняют косинусное расстояние. Близкие векторы означают низкую неопределённость: новые выборки с большой вероятностью повторят уже найденное направление.
Метод разделяет два решения, которые обычный поиск часто смешивает. Оценка качества определяет, какие кандидаты стоит сохранить, а неопределённость — сколько кандидатов раскрывать дальше. При низкой неопределённости UAA оставляет варианты с лучшей оценкой и уменьшает число потомков у каждого из них; при высокой сохраняет исходный бюджет.
В моделях с открытым доступом к внутренним состояниям векторы берут из признаков последнего сгенерированного токена, поэтому дополнительные вызовы LLM не нужны. При работе через закрытый API вместо них можно использовать разброс уверенности модели или оценок промежуточных шагов. Такой вариант проверили на GPT-4o.
Экономия сохраняется на разных алгоритмах и задачах
В экспериментах близость ветвей означала не только похожий текст. Однообразные продолжения давали меньше различных финальных ответов, а дополнительное раскрытие таких узлов почти не повышало точность. Наоборот, разнородные соседние шаги чаще оправдывали полный бюджет.
С Beam Search расход токенов на Qwen3-32B снижался примерно на 30% при сопоставимом качестве. В закрытом GPT-4o экономия составляла около 40%. На StrategyQA точность Qwen3-32B выросла с 64,33% до 72%, хотя модель использовала меньше токенов. Самый крупный выигрыш получился у MCTS, где исходная схема многократно возвращается к одним узлам.
Проверка охватила Beam Search, MCTS, DVTS и REBASE. В неё вошли математические задачи GSM8K, MATH-500 и AIME24, логические вопросы StrategyQA и планирование Blocksworld. Основными моделями были Llama3.1-8B-Instruct и Qwen3-32B; закрытый сценарий проверяли отдельно на GPT-4o.
Теоретическое обоснование связывает нужное число выборок с остаточной неопределённостью финального ответа. Оно опирается на предположение, что небольшое изменение векторного представления не вызывает резкого скачка этой неопределённости, а сходство текущих шагов сохраняется в продолжениях. Поэтому формула объясняет направление экономии, но не гарантирует качество отсечения и не выбирает параметры UAA автоматически.
Когда UAA меняет план внедрения
Работа не требует менять базовую LLM или обучать отдельный классификатор. Если продукт уже использует Beam Search, MCTS или похожий поиск, UAA можно добавить между генерацией кандидатов и раскрытием следующего уровня: рассчитать разнородность, отфильтровать слабые повторы и назначить оставшимся узлам новый бюджет.
Главное архитектурное решение — источник оценки неопределённости. При самостоятельном размещении модели доступны внутренние признаки, на которых метод показал наиболее устойчивое поведение. При внешнем API придётся собирать оценки уверенности или подключать модель, которая проверяет промежуточные шаги; это меняет состав вызовов и может уменьшить часть экономии.
Порог неопределённости, число сохраняемых ветвей и бюджет следующего шага остаются параметрами продукта. Их стоит подбирать на собственных задачах по трём метрикам одновременно: точности ответа, расходу токенов и задержке. Чем агрессивнее отсечение, тем меньше вычислений потребляет поиск, но тем выше риск удалить редкую полезную ветвь.
Для систем с одной линейной цепочкой рассуждения работа ничего не меняет: экономить там нечего, пока продукт не создаёт несколько альтернатив на шаг. Для сервисов, где древовидный поиск уже упирается в стоимость или время ответа, результат предлагает локальную оптимизацию вместо перехода на другую модель или сокращения всего дерева одинаковым коэффициентом.
Источники
Иллюстрация: рисунок из статьи «Uncertainty-Aware Budget Allocation for Efficient LLM Tree Search», Jianguo Huang, Zhiyi Lyu, Fuxiang Zhang и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


