
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
KV-кэш единой мультимодальной модели удалось сократить до пяти раз без заметной потери качества. В нерецензированном препринте все числа получены самими авторами: UniCache учитывает текущую задачу и тип сохранённых данных, поэтому не применяет одну политику ко всему кэшу. Для команд, которые запускают понимание, генерацию и редактирование изображений на одной модели, это способ снизить расход памяти без повторного обучения.
Одинаковое сжатие портит разные части результата
KV-кэш хранит ключи и значения механизма внимания, чтобы модель не вычисляла их заново на каждом шаге. Чем длиннее текстовый и визуальный контекст, тем больше памяти занимает кэш и тем дороже обращаться к нему во время вывода.
В единой мультимодальной модели состав кэша зависит от задачи. При понимании изображения модель хранит инструкцию и семантическое представление исходной картинки. При генерации ей нужна инструкция, а при редактировании добавляется детальное пространственное представление исходника.
Эти сегменты по-разному переносят сжатие. Внимание к инструкции и семантическим признакам обычно сосредоточено на небольшой части токенов: малоиспользуемые записи можно удалить. Но снижение разрядности способно исказить критичные признаки и ухудшить выполнение инструкции.
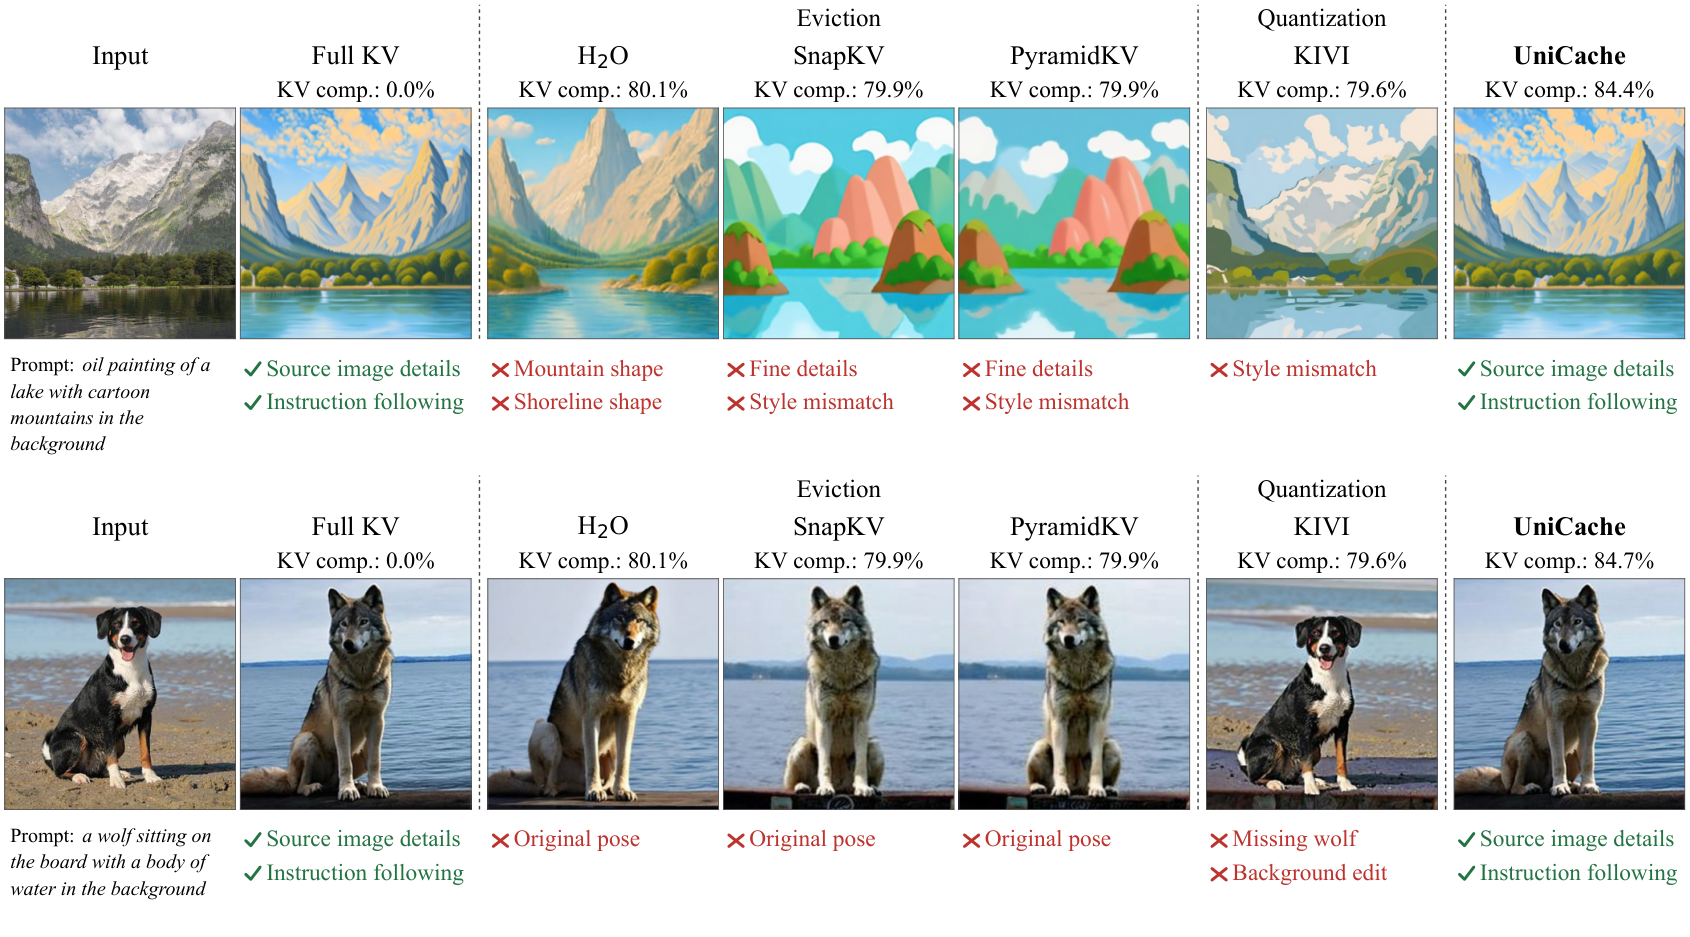
У детального представления изображения внимание распределено шире. Удаление отдельных токенов выбрасывает сведения о структуре и мелких элементах исходника, тогда как снижение разрядности сохраняет все позиции. Поэтому при редактировании единая политика даёт характерный выбор: модель либо теряет детали исходного изображения, либо хуже выполняет требуемое изменение.
Отдельно UniCache защищает граничные записи, на которых часто концентрируется внимание, и представление текущего скрытого изображения, которое пересчитывается на каждом шаге удаления шума. Их не включают в общий бюджет сжатия.
Как UniCache распределяет память между сегментами
Перед запуском UniCache проводит калибровку на примерах и измеряет, насколько разрежено внимание для каждой пары «задача — тип кэша». По этим данным система заранее назначает сегменту удаление токенов или снижение разрядности. Во время вывода выбранная политика не меняется, но меняется её интенсивность.
Доступную память распределяют пропорционально доле внимания, которую получают разные сегменты. Статистику собирают сразу для групп слоёв и шагов, а затем используют для следующего участка вычислений. Это сокращает частоту пересчёта бюджета.
Сегмент не может вернуть уже удалённые записи, поэтому его новый бюджет ограничен предыдущим. Если один тип кэша достиг этого предела, остаток памяти перераспределяют между другими сегментами, которые всё ещё получают внимание.
Общий бюджет также зависит от режима работы. При понимании изображения модель продолжает обращаться к исходному контексту во время авторегрессионной выдачи, поэтому доля сохранённого кэша остаётся постоянной. При генерации и редактировании внимание к условиям обычно ослабевает по мере удаления шума: UniCache постепенно уменьшает бюджет, но не опускает его ниже заданного минимума.
После распределения бюджета каждый сегмент сжимается независимо и параллельно. Затем сжатые и защищённые части собираются в исходном порядке для следующего вычисления внимания. Повторно обучать модель для этого не требуется.
Удаление сокращает число токенов, которые остаются в KV-кэше, а снижение разрядности уменьшает объём каждой записи. Речь идёт о хранимом контексте, а не о сокращении длины ответа или числа создаваемых моделью токенов.
Когда результат меняет планы по инфраструктуре
Метод проверяли на BAGEL и SenseNova-U1 в задачах понимания изображений, генерации по тексту и редактирования. Качество измеряли на MME, MMBench, MMMU, GenEval, PIE-Bench и GEdit-Bench, а сравнивали UniCache с полным кэшем и методами H2O, KIVI, StreamingLLM, SnapKV и PyramidKV.
Для генерации кэш BAGEL удалось сократить в 2,5 раза, сохранив результат GenEval практически на уровне модели с полным кэшем. В понимании и редактировании UniCache также удержал сбалансированное качество: альтернативные методы чаще выигрывали по одной метрике ценой просадки по другой.
Практический выигрыш проявился на длинном контексте. При примерно 20 тысячах KV-токенов на ветвь внимания пропускная способность выросла до 1,78 раза, а постоянный объём управляемого кэша уменьшился примерно на 80%. Эти замеры сделаны для BAGEL на NVIDIA A100 с 40 ГБ памяти.
Работа меняет планы в тех случаях, когда ограничением уже стала память под KV-кэш, а один сервис объединяет несколько мультимодальных режимов. Вместо отдельной модели или единой жёсткой политики сжатия можно заложить слой управления кэшем, который знает тип задачи, разделяет данные по смысловой роли и меняет бюджет по ходу вывода.
Переносить заявленный выигрыш на другую архитектуру напрямую нельзя: эксперименты охватывают две модели со смесью трансформеров, а измерение скорости относится к конкретной реализации BAGEL. Но сама схема даёт проверяемый план внедрения: сначала измерить распределение внимания, затем выбрать политику для каждого сегмента и только после этого включать динамический бюджет.
Источники
Иллюстрация: рисунок из статьи «UniCache: Task- and Type-Aware KV Cache Compression for Unified Multimodal Models», Wanqi Yang, Yuexiao Ma, Mei Xie и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


