
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Трансформер научили сам удалять ненужные токены из KV-кэша во время генерации, не ограничивая внимание фиксированным окном. В работе IBM Research и University of Illinois модель сжала кэш в 25 раз на контексте из 16 тысяч токенов, хотя препринт не рецензирован и все числа получили сами авторы. Для новых моделей это открывает путь к меньшему расходу памяти без отказа от обычного механизма внимания.
Как затухание превращается в критерий удаления
KV-кэш хранит ключи и значения для всех уже обработанных токенов, чтобы модель не вычисляла их заново на каждом шаге. Чем длиннее контекст и больше одновременных запросов, тем больше памяти занимает кэш.
Обычная стратегия сокращения кэша удаляет старые токены или сохраняет заранее заданное количество записей. Такой подход экономит память, но может выбросить ранний фрагмент, к которому модель должна вернуться через несколько тысяч токенов.
Universal Attention вместо возраста оценивает, насколько каждый токен ещё влияет на внимание. Архитектура сохраняет Softmax и позиционное кодирование RoPE, но добавляет к оценкам внимания обучаемое затухание. Оно постепенно уменьшает вклад старых ключей.
Затухание складывается из трёх сигналов. Первый определяет, сколько истории разрешает забыть текущий токен. Второй задаёт каждому сохранённому ключу собственную скорость исчезновения. Третий сравнивает ключи: если новый ключ похож на старый, старый можно быстрее признать избыточным.
Сигналы объединяются через среднее геометрическое. Если хотя бы один из них требует сохранить токен, итоговое затухание стремится к нулю. Так модель не удаляет запись только потому, что она старая или похожа на новую по одному признаку.
Для каждой пары ключа и значения хранится убывающая оценка. Когда соответствующая маска проходит выбранный порог, запись удаляется отдельно в каждой голове внимания. Оценка может только снижаться, поэтому удалённый токен уже не вернулся бы к значимости на следующих шагах.
Метод проверяли на трансформере с 1 млрд параметров, обученном с нуля на 50 млрд токенов Dolma. В тесты вошли естественный язык, синтетические задачи, поиск сведений в длинном контексте, отслеживание состояний и ответы на вопросы. UA сравнили с Llama3, Mamba2, Gated DeltaNet, гибридными архитектурами и методами удаления записей из кэша; модели обучали в одинаковых условиях.
Кэш уменьшается сильнее на длинном контексте
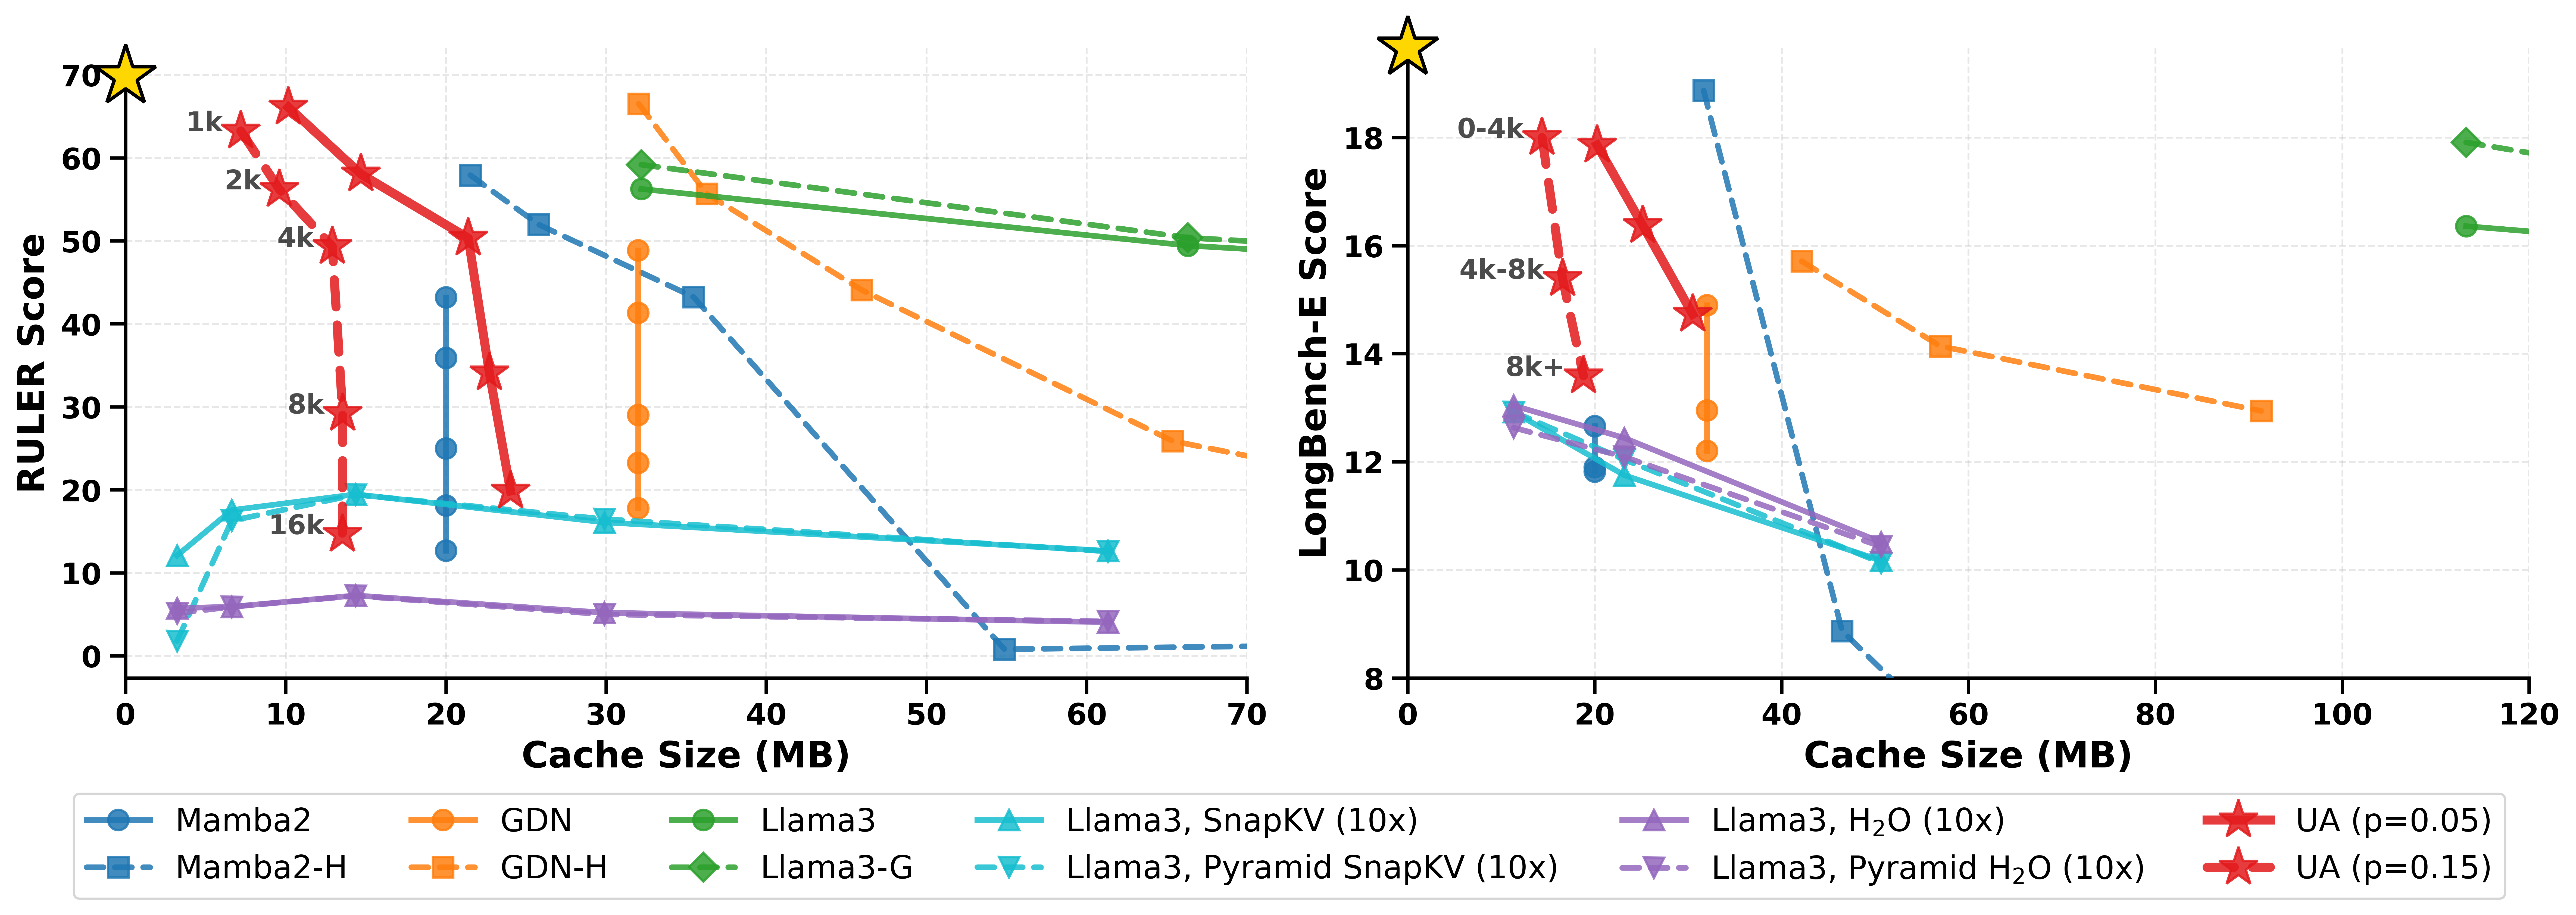
На естественном языке и синтетических задачах Universal Attention дала десятикратное сжатие KV-кэша и при этом улучшила результаты относительно сопоставленных базовых моделей. Она также обошла необрезанный Llama3, хотя тот сохранял все записи. Возможное объяснение — обучаемое забывание убирает не только расход памяти, но и помехи от малозначимых фрагментов.
На контексте из 16 тысяч токенов сжатие достигло 25 раз. Размер кэша не оставался постоянным: модель накапливала записи на содержательных участках и резко очищала их после смены фрагмента. Два входа одинаковой длины поэтому могли требовать разный объём памяти.
При агрессивной настройке порога LongBench-E показал среднее сжатие в 21,4 раза, а итоговая оценка и перплексия изменились менее чем на один пункт. Единого лучшего порога нет: качество снижается постепенно, поэтому его придётся выбирать под доступную память и требования продукта.
Слабее всего UA справлялась с задачами, где ответ нужно собрать из множества небольших свидетельств по всему контексту. Архитектура лучше сохраняет отдельные значимые элементы, чем суммирует рассеянные сигналы. В работе этот недостаток смягчали гибридной моделью, которая сочетает UA с другим механизмом памяти.
Планы меняются только для команд, готовых обучать архитектуру
Universal Attention пока не выглядит заменой кэша, которую можно подключить к готовой LLM на этапе развёртывания. Основные результаты получены после полного обучения новой архитектуры. Авторы пробовали адаптировать готовый Llama3, но такой вариант всё ещё уступал модели, обученной с UA с самого начала.
Командам, которые проектируют собственную модель или планируют крупное дополнительное обучение, стоит учитывать UA как альтернативу фиксированному окну, линейному вниманию и удалению по внешней эвристике. Метод сохраняет привычные Softmax и RoPE, а объём кэша подстраивает под конкретный вход. Это особенно полезно, если нагрузку определяют длинные запросы и число параллельных сеансов.
Для внедрения потребуется не только изменить обучение. UA дополнительно вычисляет маски затухания, а динамически разреженный кэш требует специальных ядер и диспетчера памяти. В текущей реализации нет полностью объединённого и оптимизированного механизма для инференса, поэтому уменьшение кэша ещё не гарантирует пропорционального ускорения генерации.
Практический вывод узкий: работа меняет выбор архитектуры для будущих моделей, но не даёт готового способа удешевить обслуживание уже развёрнутых. Перед ставкой на UA нужно отдельно проверить задачи с распределёнными по контексту свидетельствами и подтвердить выигрыш на целевом оборудовании.
Источники
Иллюстрация: рисунок из статьи «A Self-Pruning Transformer: Extreme KV-Cache Compression with Universal Attention», Davis Wertheimer, Haochen Shen, Ahan Gupta и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


