
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Одну замороженную языковую модель научили отбирать факты и из большого корпуса, и из длинного запроса без отдельной поисковой модели. UNREAL добавляет меньше 500 тыс. обучаемых параметров; поскольку препринт не проходил рецензирование, результаты получили сами авторы. Подход позволяет строить поиск и обработку длинного контекста как два режима одного компонента, а не как конкурирующие архитектуры.
Как одна модель ищет и отвечает
Обычная генерация с поиском по внешней базе (RAG) разделяет работу между поисковой моделью и LLM. Первая кодирует документы и находит подходящие фрагменты, вторая читает их и формирует ответ. Команде приходится обучать, обновлять и обслуживать оба компонента.
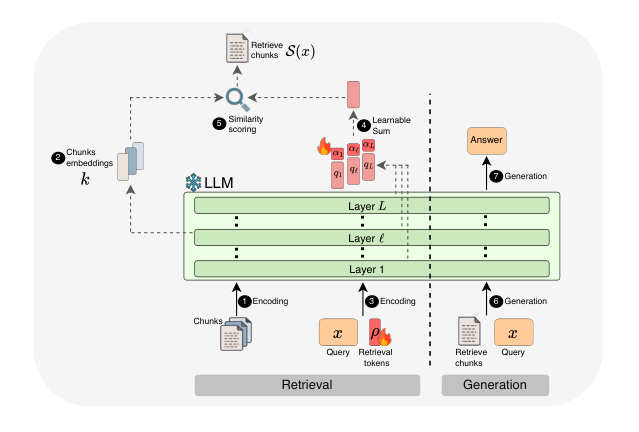
UNREAL использует для поиска ту же LLM, которая затем отвечает на вопрос. Модель заморожена: её основные веса не меняют. Система добавляет обучаемую последовательность служебных токенов и коэффициенты, которые смешивают внутренние состояния разных слоёв.
Фрагменты корпуса заранее пропускают через LLM и сохраняют их внутренние представления в индексе. При запросе служебные токены собирают поисковое представление из состояний модели. Система сравнивает его с представлениями фрагментов, ранжирует кандидатов и передаёт выбранный текст той же LLM для генерации.
Механизм работает и внутри уже сформированного длинного запроса. Его делят на фрагменты, ранжируют тем же способом и удаляют отвлекающий текст до генерации. Модель получает не всё окно контекста, а только выбранные части.
Авторы проверяли подход на полном индексе Wikipedia из 21 млн фрагментов и на контекстах длиной до 256 тыс. единиц текста. В корпусном поиске использовали вопросы по Wikipedia, а в длинном контексте — задачи, где ответ зависит от небольшого числа фрагментов среди множества отвлекающих. В тестах участвовали модели с обычным вниманием, линейным вниманием и гибридной архитектурой Mamba.
Отбор фактов помог сильнее, чем расширение окна
Для корпусного поиска основной метрикой стала полнота первой десятки: вопрос засчитывали, только если выдача содержала все размеченные фрагменты с доказательствами. На HotpotQA лучший вариант UNREAL поднял её с 49,1 до 73,2%. На других многошаговых задачах сохранился тот же эффект: механизм чаще находил полный набор фактов, а не отдельный подходящий отрывок.
Улучшение поиска дошло до конечных ответов. Авторы фиксировали генератор и меняли только способ отбора контекста. UNREAL обошёл BM25, модели эмбеддингов, повторное ранжирование и их комбинации на проверенных задачах с несколькими источниками доказательств.
В длинном контексте преимущество появилось там, где полный запрос мешал модели выделить нужный фрагмент. На NoLiMa точность в самом длинном режиме выросла с 1,0 до 24,83%. Один и тот же отборщик применяли без отдельного обучения на длинных контекстах: его перенесли из корпусного поиска как есть.
Результат не означает, что любая длинная задача сводится к поиску. Эксперименты сосредоточены на разреженных доказательствах, когда для ответа достаточно нескольких частей входа. Работа не проверяет задачи, где модели нужно сопоставить почти весь документ, проследить развитие аргумента или агрегировать множество записей.
Когда UNREAL меняет архитектурный план
Работа даёт основание не выбирать заранее между RAG и максимальным окном контекста. Если продукт отвечает по большой базе, но иногда получает объёмные документы целиком, один механизм может ранжировать и корпус, и части входного запроса. При этом поисковые представления соответствуют той LLM, которая будет читать найденный текст.
UNREAL не превращает весь процесс в один проход и не устраняет поисковую инфраструктуру. Корпус нужно разбить, закодировать и хранить в многовекторном индексе; для начального контекста метод использует BM25. После поиска модель ещё раз обрабатывает выбранные фрагменты для генерации.
Такой индекс занимает больше места, чем плотный индекс с одним вектором на документ. Замена базовой LLM также потребует пересчитать представления корпуса, потому что они сняты с её внутренних слоёв. Поэтому выигрыш от отказа от отдельной поисковой модели нужно сопоставлять со стоимостью запуска основной LLM на этапе поиска.
Для длинных запросов расчёт выглядит убедительнее: UNREAL начинает снижать число вычислений и время до первого токена примерно от 32 тыс. токенов, а затем разрыв растёт. Это относится к контекстам с редкими полезными фрагментами; если ответ требует читать материал целиком, ранний отбор может удалить нужные связи.
Практический следующий шаг — не заменять действующий RAG целиком, а проверить общий отборщик на собственном корпусе. Сравнивать стоит полноту найденных доказательств, качество конечного ответа, размер индекса и задержку всего пути. Если одна базовая LLM уже утверждена для продукта, UNREAL предлагает способ сократить число моделей в контуре; если поиск должен быть дешёвым и независимо масштабироваться, отдельный компактный поисковик может остаться удобнее.
Источники
Иллюстрация: рисунок из статьи «UNREAL: Unifying Retrieval and Long-Context with a Single Model», Edan Kinderman, Elad Hoffer, Yochai Blau и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


