
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Ошибочный ход многоходового агента научились перехватывать до исполнения, чтобы он не уводил всю учебную траекторию в тупик. В работе UC Irvine и University of Michigan, которая не прошла рецензирование и приводит числа самих авторов, метод UOPD превзошёл обычную дистилляцию на собственных траекториях во всех проверенных средах. Команде потребуется не новый цикл обучения целиком, а дополнительное правило: оценить предложенное действие и при высокой неопределённости передать ход учителю.
Почему исправлять действие нужно до исполнения
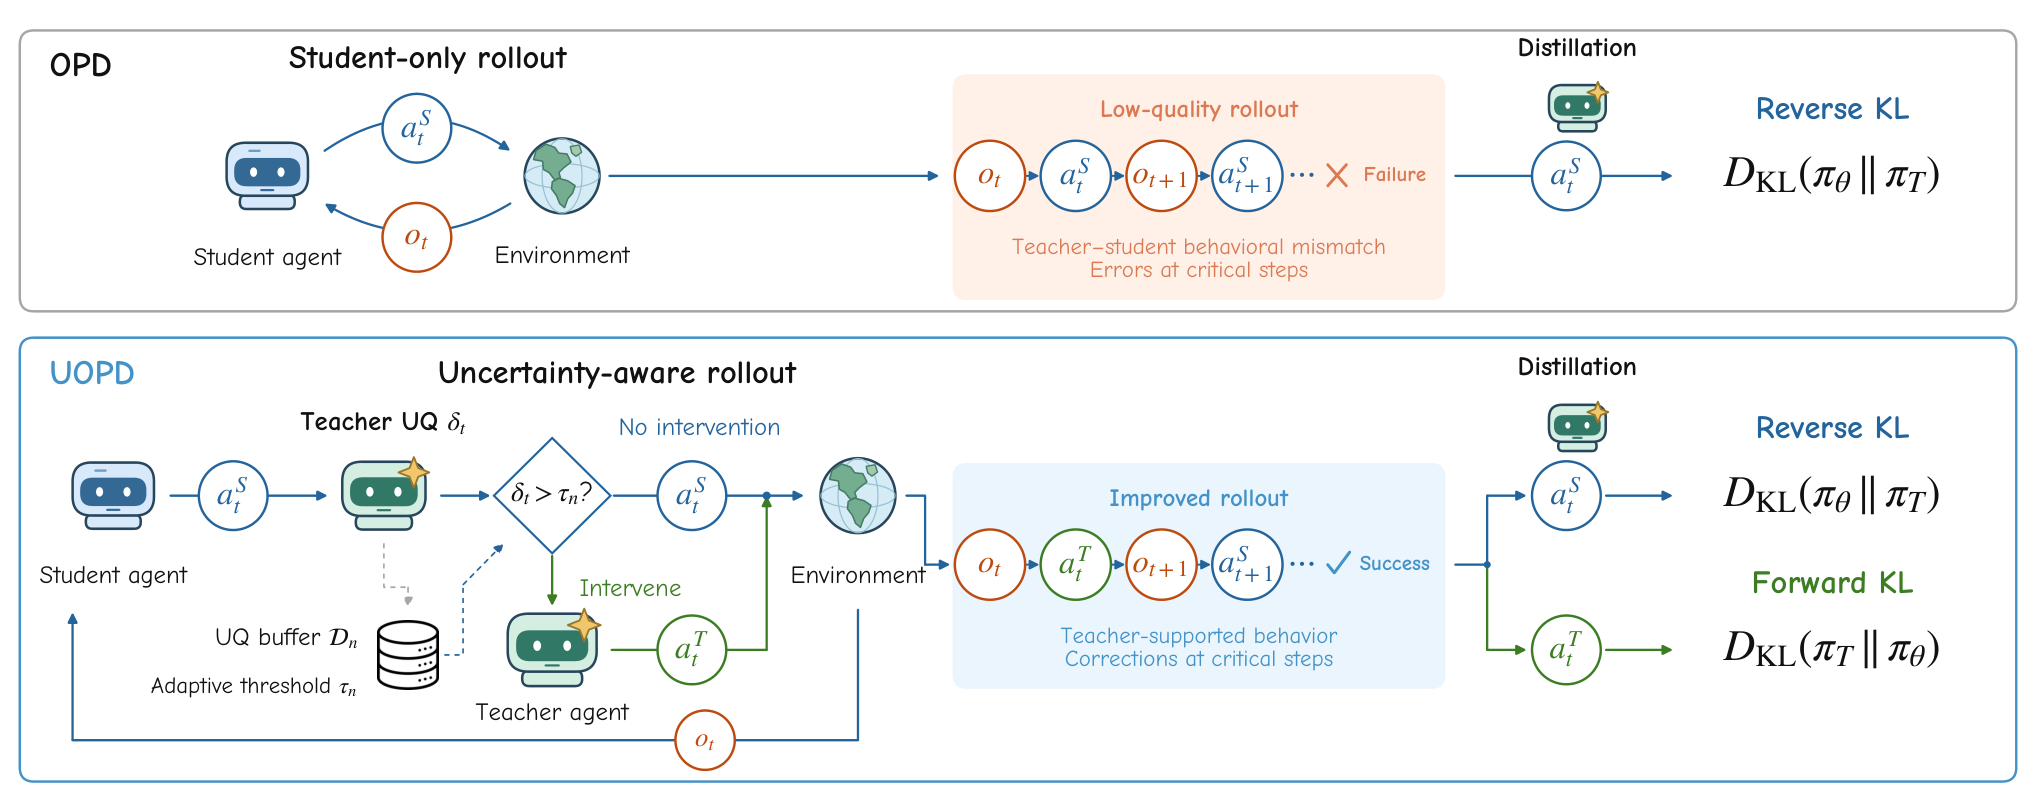
При дистилляции на собственных траекториях (on-policy distillation, OPD) ученик сам взаимодействует со средой, а более крупная модель-учитель задаёт ему распределение вероятностей для обучения. Такой подход показывает учителю именно те состояния, в которые попадает ученик, но не мешает ученику выполнить плохое действие.
Для многоходового агента это принципиально. Ошибка меняет следующее наблюдение: агент открывает не тот предмет, переходит не на ту страницу или отправляет поисковый запрос, после которого продолжает работу уже в неудачном контексте. Учитель затем корректирует ответы вдоль этой испорченной траектории, а не возвращает агента к полезному состоянию.
В контрольном опыте на ALFWorld параметры моделей не меняли. Учитель один раз заменял действие ученика, после чего ученик снова действовал самостоятельно. Если замену ставили в ход с низкой уверенностью учителя, доля выполненных заданий выросла примерно с 14% до 26%; случайно выбранный ход помог слабее.
После точечной коррекции учитель выше оценивал и последующие самостоятельные действия ученика. Значит, вмешательство исправляло не только один ответ: оно переводило агента в состояние, из которого тот лучше продолжал задачу.
Как UOPD выбирает момент для вмешательства
На каждом ходу ученик сначала предлагает действие, но среда его пока не исполняет. Учитель оценивает, насколько это действие согласуется с его собственным распределением ответов. Низкая уверенность превращается в высокий показатель неопределённости.
UOPD хранит недавние оценки и выставляет порог по их распределению. Команда задаёт желаемую долю вмешательств, а порог автоматически выбирает самые неопределённые ходы. По мере обучения доля снижается, поэтому в начале учитель чаще направляет траекторию, а затем передаёт управление ученику.
Ниже порога выполняется действие ученика. Модель обучается через обратную дивергенцию Кульбака — Лейблера: она усиливает варианты, которые уже умеет генерировать и которые поддерживает учитель.
Выше порога UOPD отбрасывает предложенное действие, получает новое от учителя и исполняет его. Ученик имитирует эту коррекцию через обучение с учителем, что соответствует прямой дивергенции Кульбака — Лейблера. Так в его распределение попадают полезные действия, которые он сам почти не выбирает.
У коррекции поэтому две функции. Она служит учебным примером и одновременно меняет следующие состояния среды. Теоретическая гарантия улучшения зависит от содержательного условия: в выбранных точках действия учителя должны в среднем вести к большей итоговой награде, чем предложения ученика.
Когда метод стоит включать в план обучения
UOPD проверяли на ALFWorld, WebShop и многошаговом поиске. Учениками служили Qwen2.5-1.5B-Instruct и Qwen2.5-3B-Instruct, учителями — специализированные модели семейства Qwen2.5 размером 7B. Это ограничивает прямой вывод интерактивными задачами с относительно небольшими учениками и учителем, который лучше решает конкретную задачу.
На WebShop оценка младшего ученика выросла с 66,3 до 76,8, а средняя траектория сократилась с 7,9 до 6,8 хода. На ALFWorld метод показал лучший результат как на знакомых, так и на новых заданиях, а в поиске обошёл OPD на каждом использованном наборе данных.
Разбор компонентов подтвердил, что одного присутствия учителя недостаточно. Случайный выбор ходов работал хуже отбора по неопределённости, отказ от имитации коррекции снижал качество, а слишком частое вмешательство не давало устойчивого выигрыша. Важен не только более сильный ответ, но и момент, когда он заменяет действие ученика.
Работа меняет планы команд, которые уже обучают агента на его собственных взаимодействиях со средой. В цикл сбора траекторий нужно добавить предварительную проверку действия, буфер оценок неопределённости, адаптивный порог и два режима функции потерь. Среда также должна позволять заменить действие до исполнения и продолжить эпизод из нового состояния.
В описанной конфигурации учитель должен отдавать оценки вероятности, а не только готовый текст. Если используемый API скрывает такие сигналы или обучение идёт на фиксированном наборе завершённых траекторий, UOPD нельзя перенести без другого способа измерять неопределённость. Для доступного учителя и интерактивной среды метод предлагает точечную доработку OPD, а не отдельную архитектуру агента.
Источники
Иллюстрация: рисунок из статьи «UOPD: Uncertainty-Aware Intervention for On-Policy Distillation of Multi-Turn Agents», Wenbo Zhang, Pengcheng Xu, Weizhi Du и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


