
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Удалённые из LLM знания можно защитить от восстановления при последующем дообучении, не лишая модель способности осваивать новые задачи. Jie Li, Youming Tao, Bowei He и Meng Ding получили этот результат в нерецензированном препринте, где все числа рассчитали сами авторы: точность на новой задаче выросла в среднем на 3,5 пункта. Для команд, которые выпускают модель для дальнейшей настройки, одной проверки качества удаления теперь недостаточно — нужно отдельно измерять, сохранила ли модель способность учиться.
Проблема возникает при машинном забывании (unlearning): модель удаляет выбранные сведения, но позднее дообучение может вернуть их даже на данных, где этих сведений нет. Защита от такого возврата обычно сравнивает обновлённую модель с её состоянием до обновления. Тогда полезные изменения тоже считаются ошибкой, и модель учится сопротивляться любому дообучению.
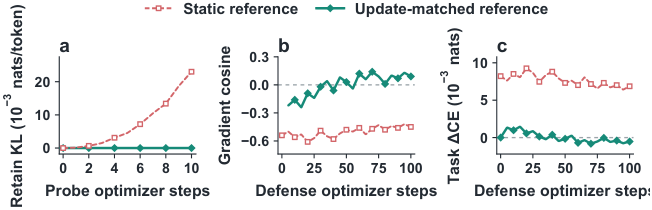
Метод Update-Matched Unlearning, или UMU, меняет точку сравнения. Авторы применяют одно и то же имитированное обновление к защищаемой модели и эталонной копии. Полезные изменения появляются в обеих, поэтому штраф учитывает только дополнительный эффект защиты. При выборе итоговой версии UMU также проводит короткие испытания на новых задачах и отбрасывает варианты, которые разучились обучаться.
В среднем UMU снизил восстановление удалённых знаний после вредоносного дообучения на 30,4 пункта, а после обычного — на 9,9 пункта. В контрольном опыте защита без обновления эталона показывала почти такую же устойчивость, но уступала полной UMU по точности на новой задаче на 5,5–6,3 пункта. Низкая восстанавливаемость сама по себе поэтому может означать не точечную защиту, а общую потерю обучаемости.
Метод проверили поверх трёх способов удаления знаний на наборах TOFU и FaithUn, моделях Llama-3.2-3B и Qwen3-4B. Новые навыки оценивали на классификации новостей AGNews, а последующие обновления выполняли через низкоранговую адаптацию. Результат относится к этому масштабу и способу дообучения: практический тест для другого контура должен повторять реальные обновления, которые модель получит после выпуска.
Источники
Иллюстрация: рисунок из статьи «Not All Change Is Damage: Update-Matched Unlearning for Large Language Models», Jie Li, Youming Tao, Bowei He и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


