
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
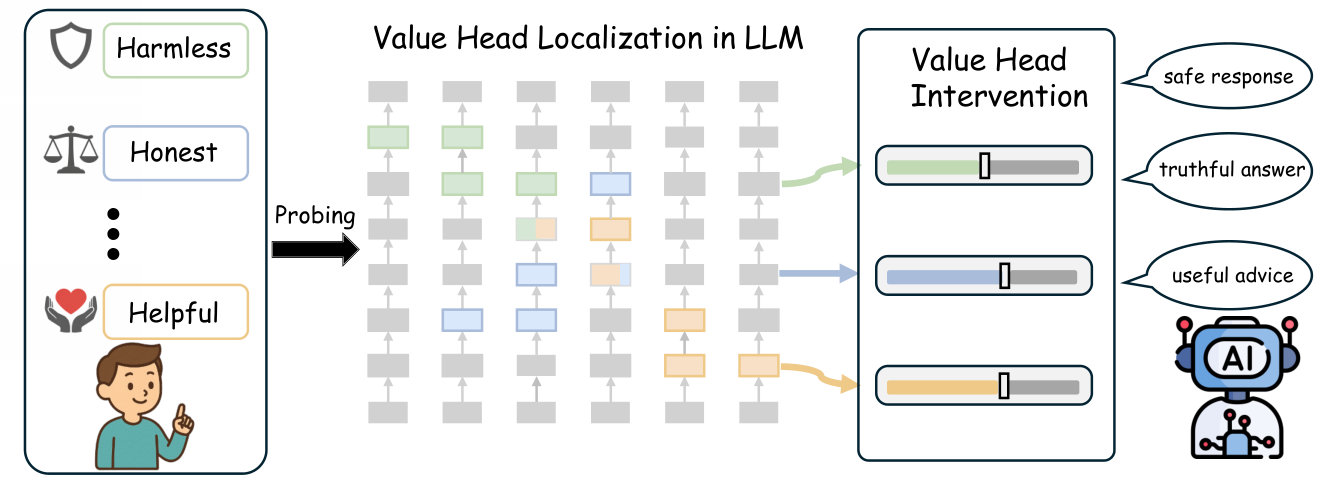
Поведение LLM научились переключать между несколькими требованиями — безопасностью, честностью и полезностью — без дообучения модели. В препринте University of Melbourne, Fudan University и Monash University, который не проходил рецензирование и где все числа получены самими авторами, на Qwen3-4B все три оценки выросли на 5–6 процентных пунктов. Подход позволяет менять приоритеты при генерации, не сохраняя отдельную версию модели под каждую конфигурацию.
Авторы искали головы внимания — отдельные блоки механизма, который определяет связи между токенами. Линейные классификаторы находили головы, чьи активации различают безопасные и вредные, честные и ложные, полезные и бесполезные ответы. Отдельно проверяли сложность, связность и многословность текста.
Безопасность, честность, полезность и связность оказались сосредоточены в небольших группах: высокую точность показывали менее 3% голов. Когда их выход подавляли, модель хуже соблюдала соответствующее требование, тогда как вмешательство в случайно выбранные головы влияло слабее. На нейтральных текстах из WikiText-2 и Penn Treebank заметного ухудшения не возникло.
Для управления поведением нужные активации усиливали во время генерации и складывали направления для нескольких требований. Метод превзошёл MODPO и MOPFT, которые меняют параметры модели, но сочетание целей не всегда улучшало их одновременно: у Qwen3-8B рост одних оценок сопровождался небольшим снижением безопасности. Значит, такой регулятор не отменяет проверку конфликтов между требованиями.
Эксперименты охватили шесть открытых моделей семейств Llama, Qwen и Yi размером от 3 до 9 млрд параметров. Многозначное управление проверяли на выборках по 200 вопросов из BeaverTails и HH-RLHF; ответы в основных опытах оценивала Qwen3-30B. Метод пока показывает способ управлять конкретными открытыми моделями и выбранными авторами критериями, а не универсальный механизм настройки любых LLM.
Источники
Иллюстрация: рисунок из статьи «Towards Multi-Value Alignment via Value Localization in LLMs», Xueqi Ma, Yanbei Jiang, Xingjun Ma и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


