
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
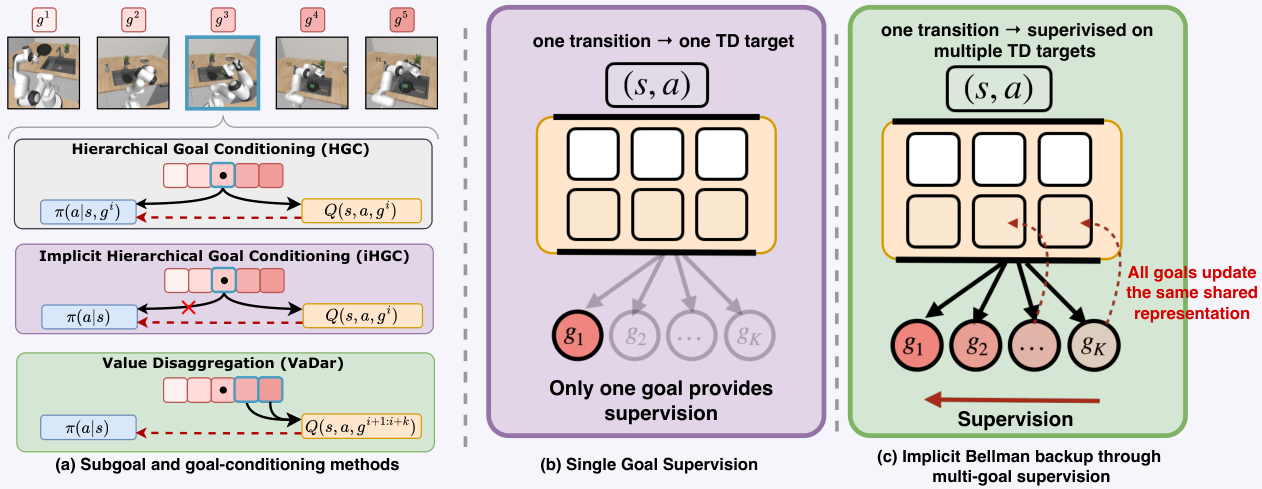
Робота для длинной задачи можно обучить на подцелях, не передавая ему текущую подцель во время работы. В препринте CMU и Amazon, который не рецензирован и числа в котором получили сами авторы, VaDar не уступил обычному обучению с явными целями и часто превзошёл его. Это позволяет убрать из рабочего контура планировщик подзадач или VLM, который следит за их выполнением.
Почему текущая подцель может мешать всей задаче
В длинных робототехнических сценариях итоговая награда приходит поздно. Чтобы связать её с отдельными действиями, задачу обычно делят на этапы: взять предмет, перенести его, освободить место, установить следующий предмет. Политика — алгоритм, который выбирает действие по состоянию среды, — получает текущую подцель вместе с наблюдением.
Такой подход требует определять активную подцель не только при обучении, но и после развёртывания. Если выполнение этапа распознаёт VLM, модель приходится вызывать во время каждого рабочего эпизода. Если правила написаны вручную, их нужно поддерживать вместе с контроллером.
Локальная цель также провоцирует близорукие действия. В одном примере из работы робот ставил чайник на поднос так, что для кружки не оставалось места. В другом он опускал сковороду в раковину в положении, при котором сверху уже нельзя было устойчиво положить губку. Текущий этап формально завершался, но выбранное действие осложняло следующий.
Авторы отдельно сравнили этот подход с политикой, которая не получает подцель, но всё ещё обучается только по оценке текущего этапа. Удаление цели из входа упрощало запуск, однако не устраняло близорукость: контроллер по-прежнему не учитывал, как действие повлияет на дальнейшие части задачи.
Как VaDar переносит подцели в обучение критика
VaDar оставляет подцели в обучающем контуре, но убирает их из входа политики. Контроллер видит состояние среды и сразу выбирает действие. Отдельная модель-критик оценивает, насколько это действие полезно для каждой подзадачи.
Каждый переход между состояниями обучает критик сразу по всем подцелям, а не только по активной. Близкий этап даёт частый и понятный сигнал, пока оценка далёкого финала ещё неточна. Поскольку оценки строит общая нейросеть, признаки, найденные на промежуточных этапах, помогают предсказывать успех всей задачи.
Политика обучается максимизировать взвешенную сумму этих оценок. В неё можно включить текущие и будущие этапы, чтобы робот не завершал ближайший шаг способом, который блокирует продолжение. Во время исполнения остаётся одна плоская политика без переключения между специализированными контроллерами.
Разложение не требует строго линейного сценария. Подзадачи можно связать направленным графом зависимостей и учитывать несколько доступных целей одновременно. Тем же способом критик может совмещать выполнение задания с дополнительным условием, например избеганием препятствия.
Ключевая проверка отделяла пользу дополнительных учебных сигналов от выбора действий по нескольким оценкам. В варианте VaDarLast-Q промежуточные подцели обучали общий критик, но политика ориентировалась только на ценность финального результата. Этот вариант всё равно учился лучше обычного критика с редкой итоговой наградой. Значит, выигрыш даёт не только планирование будущих этапов: сами промежуточные предсказания улучшают представление состояния.
Когда результат меняет архитектуру системы
VaDar проверяли на непрерывном управлении роботами в Robocasa365 и Robomimic. Эксперименты охватывали SAC, FQL и OGPO, а также схему, где политику сначала обучают копировать демонстрации, а затем дообучают взаимодействием со средой. Для задач Robocasa365 использовали фиксированные начальные условия.
В этих условиях VaDar был не хуже и часто лучше иерархического обучения с явной целью. Он также превзошёл обучение с повторным использованием неудачных попыток и варианты с плотной наградой, построенной по предпочтениям. На выбранных длинных задачах Robocasa365 метод довёл до сходимости политики, которые после начального копирования демонстраций почти не выполняли задание.
Для продуктовой архитектуры работа предлагает разделить два контура. Разметка подцелей, правила их завершения и возможные обращения к VLM остаются в обучающей инфраструктуре. В рабочий контур попадает только политика, которая получает наблюдение и выдаёт действие. Это сокращает число зависимостей при запуске и исключает ошибку, когда внешний планировщик выбирает не ту текущую цель.
Такой пересмотр оправдан, если подзадачи известны заранее, их завершение можно надёжно оценить при сборе опыта, а порядок действий не должен жёстко задаваться во время исполнения. Особенно полезен он там, где способ завершить один этап влияет на возможность выполнить следующий.
Метод всё ещё требует спроектировать фиксированный набор подцелей и граф их связей. Эксперименты относятся к робототехническому управлению с заранее заданной структурой задачи, поэтому они пока не обосновывают тот же выбор для открытых языковых агентов или целей, которые задаются произвольным текстом и изображениями. Для робототехнической команды VaDar скорее меняет место декомпозиции: она становится способом обучить критик, а не протоколом исполнения.
Источники
Иллюстрация: рисунок из статьи «VaDar: Implicit Goal Conditioning via Value Disaggregation», Shashwat Saxena, Mehul Goel, Sreyas Venkataraman и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


