
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Визуальный поиск научили самостоятельно проходить цепочку изображений и возвращаться из тупиков, не заставляя LLM описывать каждую новую подсказку текстом. VHop-Router повысил успешность агентного поиска на 52,7%, тогда как замена агента на более сильную модель дала 3,7%; препринт не рецензирован, а все числа получили сами авторы. Для систем, которые ищут по фотоархивам и другим визуальным базам, узким местом может оказаться ретривер, а не LLM.
Поисковик проходит визуальную цепочку без текстовых запросов
Обычный ретривер получает запрос, сравнивает его с векторными представлениями изображений и возвращает ближайшие результаты. Если задача требует нескольких переходов, агент должен изучить выдачу, сформулировать следующую подсказку и снова вызвать поиск.
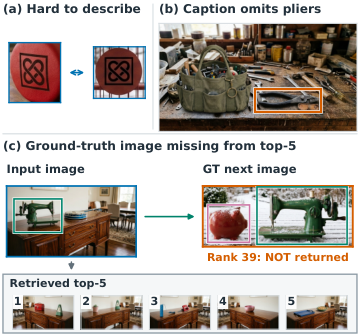
Такая схема ломается, когда важную деталь трудно назвать словами или её нет в подписи. Изображение может показывать нужный инструмент, символ или предмет, но текстовый запрос теряет эту деталь. Если следующий элемент цепочки не попал в выдачу, LLM не сможет рассуждением восстановить то, чего не видит.
VHop-Router получает исходное изображение, инструкцию и текущую цепочку найденных кадров. На каждом шаге он выбирает новое изображение, возвращается на предыдущую развилку либо завершает поиск. Кандидатов он оценивает непосредственно по их визуальным представлениям, поэтому промежуточные текстовые запросы не нужны.
Для агента вся процедура выглядит как один вызов инструмента, который возвращает связанную цепочку изображений. Саму LLM менять или дополнительно обучать не требуется: она получает уже собранные свидетельства и выбирает ответ.
Возврат из тупика пришлось обучать отдельно
Основой VHop-Router стала Qwen3-VL-Embedding-2B. Её разделили на кодировщик текущего состояния и кодировщик изображений-кандидатов. Представления базы можно вычислить заранее, а при поиске пересчитывать только состояние, куда входят инструкция и активная цепочка.
Обучение проходит в три этапа. Сначала обучение с учителем показывает правильные продолжения готовых маршрутов. Затем обучение подражанием запускает текущую версию ретривера на её собственных траекториях и учит исправлять ошибки, возвращаться назад и вовремя останавливаться. Наконец, обучение с подкреплением выдаёт награду только за завершение на допустимом ответе.
Для экспериментов создан VHop — генератор визуальных миров с общими предметами, цветовыми и пространственными условиями, похожими объектами и ложными ветками. Символьная проверка подтверждает допустимые маршруты до отрисовки изображений. Точные инструкции задают единственную цепочку, а расплывчатые допускают несколько корректных концовок.
Ретривер обучали на уровне L4 с цепочками из трёх переходов, а проверяли на уровнях L1–L5 в непересекающихся мирах. В сравнение вошли Qwen3, Gemini Embedding 2 и агенты на Gemini 3.5 Flash и Gemini 3.1 Pro. Основная часть проверки использует сгенерированные сцены; отдельные опыты охватывают более реалистичные запросы, логотипы и печатный текст.
Без многошагового обучения успешность самостоятельного ретривера оставалась ниже 5%, а VHop-Router достиг 76,3%. В агентной схеме он сократил расход токенов на 61%. По сравнению с базовым вариантом, который возвращал расширенную выдачу на каждом шаге, в контекст попало в 23 раза меньше изображений, а совокупный объём данных в запросах к API уменьшился в 35 раз.
Командам стоит проверить ретривер до замены LLM
Работа меняет порядок технических экспериментов для продуктов, где ответ складывается из последовательных визуальных подсказок. Если агент многократно переформулирует запросы, раздувает контекст изображениями или пропускает детали без текстовых подписей, сначала стоит проверить обучаемый многошаговый ретривер. Более дорогая LLM не получит свидетельство, которое поисковый слой не смог вернуть.
Архитектурно это отдельный компонент: индекс изображений сохраняется, а одношаговую модель заменяет политика, которая хранит активный маршрут и умеет выбирать, возвращаться и останавливаться. Такой подход позволяет оставить промпты, модель агента и логику ответа без изменений. Кэшированные представления кандидатов также отделяют поиск по базе от повторной обработки каждого изображения моделью.
Перенос в продукт потребует собственных проверенных цепочек или способа получить их из журналов поиска. VHop опирается на явно заданные связи между объектами, и авторы считают масштабирование такого генератора сложной задачей. Ретривер также хуже переносит длину маршрута, которой не было при обучении.
Поэтому результат пока обосновывает прототип, а не прямую замену промышленного поиска. Проверку следует проводить на реальном архиве с теми же тупиками, неоднозначными подсказками и ограничениями API, которые встречаются в продукте. Для одношагового поиска или базы с полными текстовыми описаниями работа не показывает сопоставимого преимущества.
Источники
Иллюстрация: рисунок из статьи «Learning to Route in Visual Space via Multi-Step Embedding Retrieval», Tianyu Chen, Mingyuan Zhou, Jiaxing Wu, CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


