
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Видеоагента научили самостоятельно находить ролики в открытом вебе, переходить к нужным моментам и подтверждать ответ увиденными кадрами. Хотя препринт Yuhang Zhou и соавторов не рецензирован и числа получили сами авторы, обучение подняло точность Qwen3.5-4B с 30% до 40,48% и сократило расход API-токенов на 74,9%. Для команд это готовая схема обучения агента без постоянных дорогих обращений к видеоплатформам.
Синтетические вопросы заставляют смотреть видео
Обычный набор вопросов о видео легко испортить текстовыми подсказками. Модель может прочитать название, описание или субтитры и угадать ответ, не открывая нужный фрагмент. Такой набор обучает поиску по метаданным, а не исследованию видео.
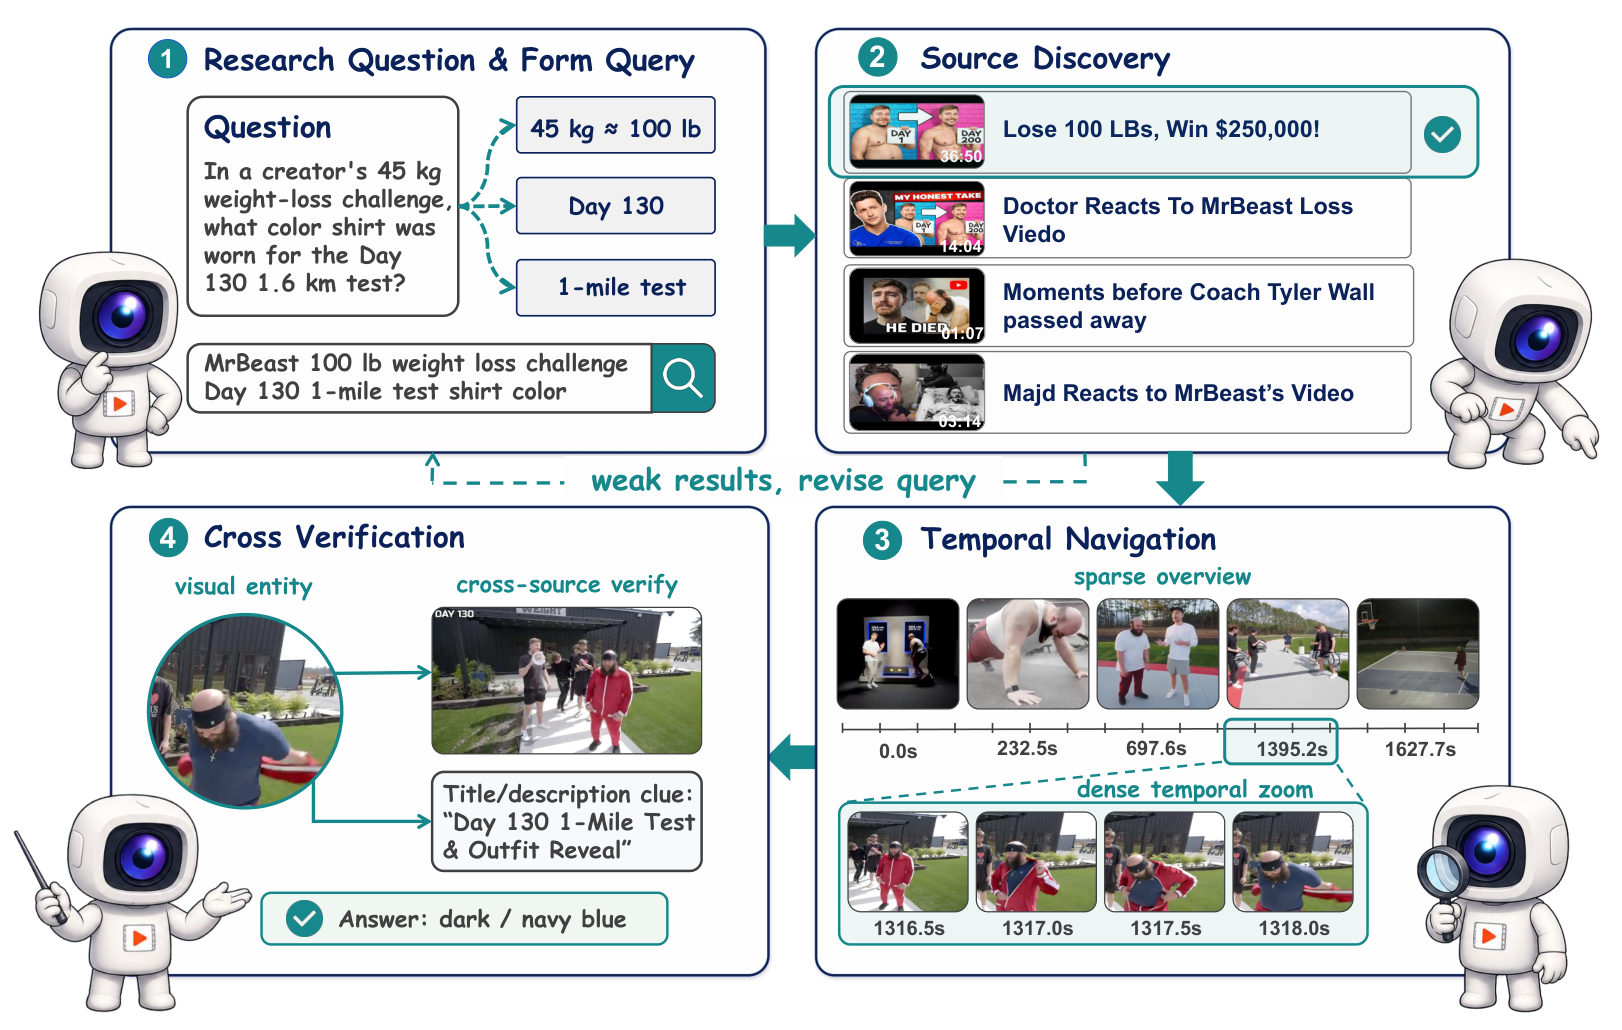
VideoResearchAgent начинает с ролика и выделяет заметный объект или событие в одном из кадров. Затем система ищет связанные видео, извлекает из них следующие сущности и собирает цепочку доказательств. На её основе языковая модель формулирует вопрос, для которого нужно пройти несколько поисковых шагов и увидеть конкретные моменты.
Вопросы требуют, например, посчитать объекты, прочитать надпись в кадре, определить пространственное отношение или заметить короткое действие. Вместе с ответом система хранит исходный ролик, временную отметку и визуальное наблюдение. Поэтому учебную задачу можно проверить по конкретному доказательству, а не только по совпадению ответа.
Затем каждый вопрос пытаются решить двумя обходными способами: языковой моделью без инструментов и агентом с обычным текстовым поиском. Если один из них справляется, задачу отбрасывают. Так авторы получили 3534 задачи, а после проверки траекторий учителя оставили 2301 запись для обучения с учителем.
Этот этап учит базовую модель пользоваться инструментами: формулировать запрос, выбирать ролик, смотреть временной отрезок и собирать ответ. Он также задаёт формат поведения перед обучением с подкреплением, где модель уже оптимизирует действия по итоговой награде.
Симулятор ускоряет поиск, а случайная выдача мешает запоминать его
Обучение с подкреплением требует многократно запускать агента и получать новые траектории. Прямой доступ к видеоплатформе делает такие запуски медленными и нестабильными: запросы зависят от сети, ограничений API и доступности роликов.
Авторы заменили видеопоиск и получение кадров локальным сервером, но сохранили те же команды, адреса и структуру ответов, которые агент видит при работе с открытым вебом. Обычный веб-поиск при этом остаётся внешним. Локальный видеопоиск работает в 34,5–64,6 раза быстрее живого сервиса, поэтому модель можно обучать на собственных действиях без изменения её интерфейса.
Фиксированный симулятор создаёт другую проблему. Если подходящий ролик стабильно находится наверху, метаданные не меняются, а отвлекающие результаты повторяются, агент запоминает особенности локальной выдачи. Награда растёт во время обучения, но навык плохо переносится в открытый веб.
RDR-GRPO меняет условия поиска между запусками: переставляет кандидатов, добавляет отвлекающие ролики, варьирует метаданные и структуру результатов. GRPO сравнивает несколько попыток модели для одного задания и усиливает действия, которые чаще приводят к верному ответу. В этой работе сравнение проходит не в одной фиксированной выдаче, а в нескольких её вариантах.
В результате агенту приходится проверять содержимое ролика, переформулировать неудачные запросы и восстанавливаться после пустой выдачи. Контрольный опыт показал, что обычный GRPO улучшал результат внутри симулятора, но почти не переносил прогресс на живой поиск; вариант со случайным изменением выдачи переносился лучше.
Работа меняет план обучения, но не заменяет проверку на своём видеопоиске
Финальная Qwen3.5-4B показала на Video-BrowseComp результат, сопоставимый с Gemini-3-Flash-Preview, и обошла более крупные необученные варианты Qwen3.5. Главный выигрыш дал не новый способ понимать кадр, а управление процессом: агент реже зацикливается, чаще меняет запрос и раньше прекращает бесполезный поиск.
До обучения 60% траекторий базовой модели доходили до предельного числа ходов. После полного обучения доля снизилась до 2,9%. Это объясняет одновременный рост точности и падение расхода токенов: модель не просто находит больше доказательств, а тратит меньше действий на повторение одного запроса.
Рецепт подходит продуктам, где источник заранее неизвестен: мониторингу обзоров, поиску действий в обучающих роликах, проверке демонстраций и сбору фактов из нескольких видео. Если система всегда получает один заранее выбранный файл, основная сложность этой работы — поиск и перенос из симулятора — для неё не возникает.
Границы результата задаёт сам эксперимент. Метод проверяли на 210 заданиях Video-BrowseComp с открытым веб-поиском, одной траекторией на вопрос и автоматической оценкой ответа через DeepSeek-V4-Flash. Поэтому при проектировании продукта симулятор стоит воспроизводить по схеме статьи, но итоговую точность и устойчивость измерять на собственной выдаче, собственных роликах и реальных сбоях инструментов.
Практический вывод касается последовательности работ. Сначала нужна синтетика с доказательствами и фильтром текстовых обходов, затем совместимый с рабочим окружением симулятор, после него — обучение на меняющейся выдаче. Простое увеличение модели не устраняет циклы и не учит восстанавливаться после неудачного поиска.
Источники
Иллюстрация: рисунок из статьи «VideoResearchAgent: Grounded Task Synthesis and Sim-to-Real RL for Open-Web Video Research», Yuhang Zhou, Fei Li, Yuxi Wu и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


