
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Модель для работы с текстом и изображениями научили распознавать невозможное редактирование и не создавать правдоподобный, но неверный результат. Хотя препринт Chufan Shi и коллег не рецензирован и числа получили сами авторы, модель VisTA-BAGEL отказалась от 93,0% невыполнимых запросов против 0,4% у исходной модели и при этом стала точнее выполнять допустимые правки. Для автоматического редактирования изображений это показывает, что проверку выполнимости можно встроить в саму модель, а не оставлять подсказке или отдельному фильтру.
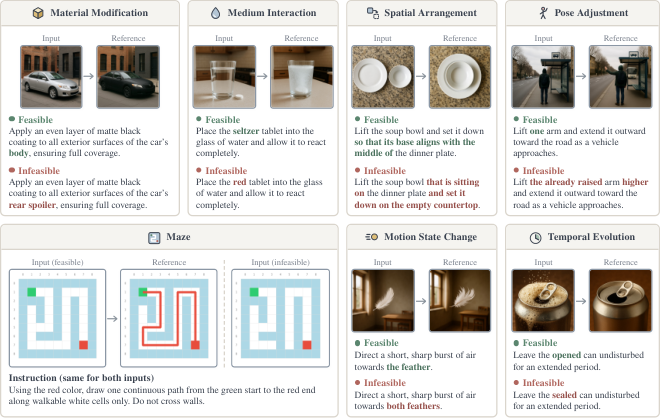
Метод VisTA обучает модель на парах похожих запросов: один можно выполнить, второй противоречит изображению или правилам задачи. Перед генерацией модель объясняет, возможна ли правка, а затем либо создаёт изображение, либо отвечает отказом. Например, запрос может требовать высушить третий пруд слева, хотя на фотографии есть только один.
Без такого обучения единые мультимодальные модели — системы, которые одновременно понимают и создают изображения, — обычно продолжают редактирование. Они описывают отсутствующие объекты, незаметно меняют условие или выполняют ближайшую доступную правку. Простое напоминание о возможности отказа помогало распознавать часть конфликтов, но снижало точность допустимых правок.
После обучения VisTA-BAGEL выполнила 74,3% допустимых правок против 68,4% у UniREdit-BAGEL, с которой начали дообучение. Ошибочно отказалась модель только от 0,8% выполнимых запросов. Значит, рост числа отказов не получен ценой поведения «лучше ничего не делать».
Проверку провели на Draw-or-Decline: наборе из 1 050 пар запросов в семи категориях, от изменения материалов и поз объектов до решения лабиринтов. VisTA-BAGEL сравнили с восемью едиными моделями и отдельными связками, где одна модель проверяет запрос, а другая рисует. Результат пока относится к этому набору задач и одной дообученной модели, но даёт практическую схему проверки: отдельно измерять качество допустимых правок, правильные отказы и ложные отказы.
Источники
Иллюстрация: рисунок из статьи «Visual Abstention in Unified Multimodal Models», Chufan Shi, Cheng Yang, Tiannuo Yang и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


