
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Мультимодальную LLM научили оценивать клинический риск и отвечать на вопросы по нерегулярным рядам измерений, не меняя веса исходной модели. В нерецензированном препринте, где все числа получили сами авторы, Junyi Gao и коллеги показали площадь под ROC-кривой 0,7376 против 0,7380 у GPT-5.6 Sol при прогнозе острого повреждения почек; этот показатель отражает, насколько хорошо модель разделяет случаи с разным исходом. Результат предлагает промежуточный вариант между передачей чисел как текста и настройкой самой LLM.
Числа корректируют уже знакомое модели изображение
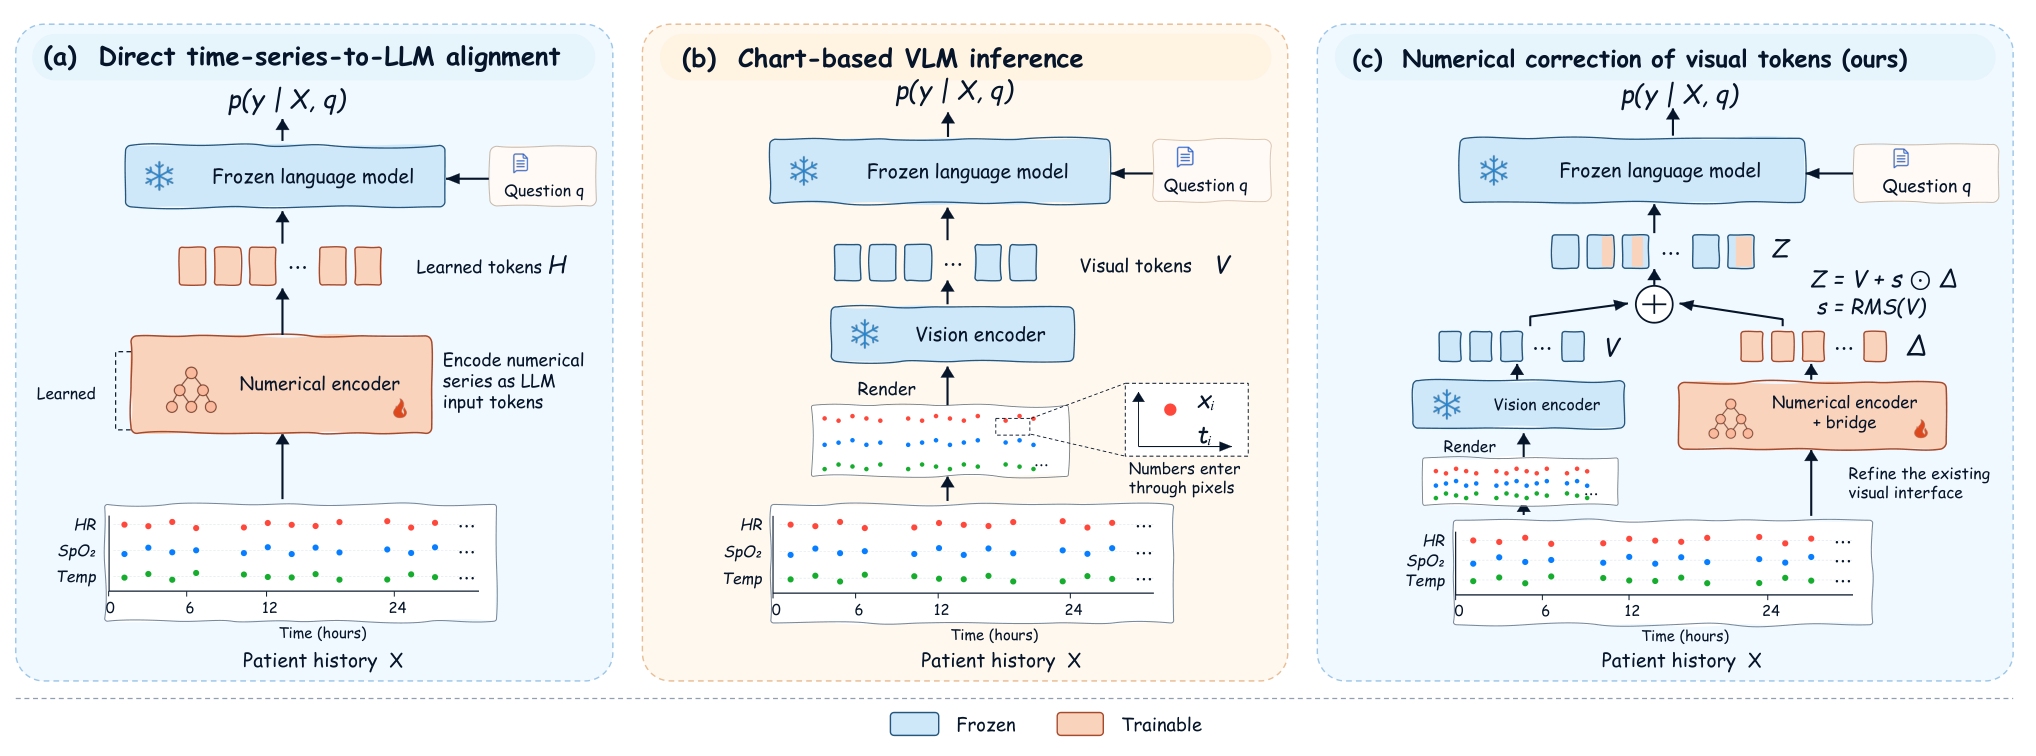
ViSTA работает поверх мультимодальной модели Qwen3.5 с визуальным входом. Система строит отдельный график для каждой клинической переменной и пропускает изображения через штатный визуальный кодировщик. Поэтому LLM получает токены в том формате, который уже встречала при предварительном обучении.
Одновременно небольшой кодировщик читает исходные измерения. Для каждого события он учитывает значение, время относительно начала наблюдения, интервал после предыдущего измерения и тип переменной. Отсутствующие измерения тоже получают отдельное представление, поэтому модель может отличить пропуск от нормального значения.
Затем адаптер собирает события в компактную память. В совместном варианте сведения по разным переменным смешиваются сразу; в раздельном каждая переменная сначала сохраняет собственную историю. Первый вариант лучше удерживал сочетания признаков для оценки риска, а второй чаще помогал в вопросах о пропусках и отдельных рядах.
Связующий модуль извлекает из этой памяти сведения для каждой позиции на графике и добавляет поправку к соответствующему визуальному токену. Его выход сначала равен нулю, поэтому обучение начинается с исходного поведения модели. Размер поправки нормируется относительно визуального токена: числовой сигнал дополняет изображение, а не заменяет его.
Визуальный кодировщик, проектор, языковая модель и выходной слой остаются замороженными. Через один языковой интерфейс система выдаёт бинарный прогноз или выбирает ответ на вопрос, но для прогнозирования и вопросов исследователи обучали разные адаптеры.
Малый адаптер выигрывает в прогнозе, но не догоняет LoRA в вопросах
На прогнозировании ViSTA показала лучшие средние результаты среди адаптаций Qwen по всем использованным метрикам. Для острого повреждения почек средняя точность по положительному классу выросла относительно сильнейшего конкурента на 3,15%, для внутрибольничной смертности — на 7,59%. Эта метрика учитывает качество ранжирования при редком положительном исходе и потому дополняет ROC-кривую.
После отдельного обучения на вопросах лучший вариант ViSTA дал точность 69,27%. Он отстал от адаптации LoRA на 2,82–4,88 процентного пункта: настройка частей языкового декодера оставила модели больше свободы под конкретную задачу. При этом ViSTA обучала более чем на 90% меньше параметров, поскольку меняла только интерфейс между временным рядом и замороженной моделью.
Обучение лишь на прогнозах не превратило адаптер в полноценную систему вопросов и ответов. Некоторый перенос появился, но высокий результат потребовал отдельного набора вопросов с правильными вариантами. Значит, общий языковой выход сам по себе не устраняет специализацию под задачу.
Когда ViSTA меняет архитектурный план
Подход подходит командам, которые уже выбрали мультимодальную LLM и хотят добавить структурированные временные ряды, не обновляя её веса. Он сохраняет исходный декодер, использует точные значения вместе с графиками и позволяет держать адаптацию отдельным небольшим модулем. Это упрощает замену базовой модели по сравнению с архитектурой, где числовые признаки глубоко встроены в декодер.
Компромисс зависит от продукта. Для фиксированного прогноза ViSTA оказалась сильнее сравнённых способов адаптации, а качество росло при переходе от моделей с 2 до 9 миллиардов параметров. Для ответов на разнообразные вопросы LoRA сохранила преимущество, а закрытая GPT-5.6 Sol заметно опередила открытые модели без специального обучения на этих вопросах.
Проверку провели на MIMIC-IV: использовали записи одного больничного комплекса, первый день пребывания в реанимации, два клинических исхода и автоматически сформированные вопросы с выбором ответа. Эксперименты запускали с одним начальным состоянием обучения. Такие условия показывают, что интерфейс работает на ретроспективных данных, но пока не дают основания заменять им проверенную клиническую модель или переносить результат на другую больницу без внешней оценки.
Работа сравнивает число обучаемых параметров, но не стоимость обучения и задержку при работе системы. Меньший адаптер сокращает объём изменяемых весов, однако графики, числовой кодировщик и сама LLM всё равно участвуют в каждом запросе.
Источники
Иллюстрация: рисунок из статьи «ViSTA: A Simple Bridge Extends Visual Alignment to Clinical Time-Series Understanding in Multimodal LLMs», Junyi Gao, Yu Shi, Pingzhao Hu и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


