
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Мультимодальная модель завершила все публичные игры ARC-AGI-3 без программной модели мира. В препринте MIT, который не рецензирован, а числа в нём получили сами авторы, VISTA подняла результат Claude Opus 5.0 с 40,68 до 100 баллов. Для команд, которые строят агентов поверх скриншотов, работа предлагает сначала улучшить память и доступ к изображениям, а уже затем менять модель.
Почему одного скриншота в контексте недостаточно
Обычный визуальный агент получает изображение, один раз преобразует его во внутреннее представление и продолжает рассуждать по этому представлению. По мере заполнения контекста старые изображения приходится удалять или заменять текстовыми сводками, поэтому мелкая деталь может исчезнуть раньше, чем модель поймёт её значение.
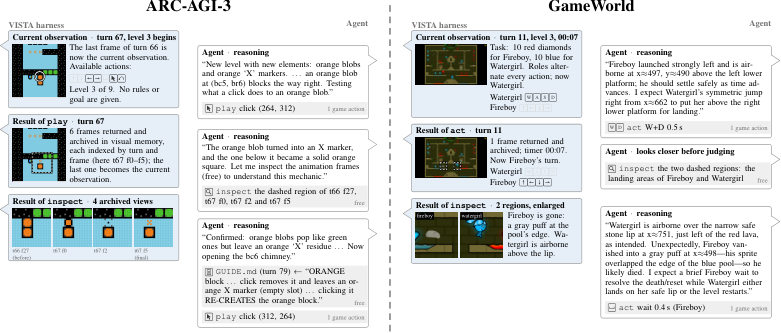
VISTA хранит каждый полученный кадр в исходном виде, включая промежуточные кадры анимации. Модель может запросить изображение из любого прошлого хода, сопоставить несколько состояний, увеличить прямоугольный фрагмент или прочитать значения отдельных пикселей.
Это не отдельная обученная модель, а механическая обвязка вокруг готовой мультимодальной модели. Она исполняет запросы на просмотр памяти и действия в среде, но не решает, какой кадр важен: момент и область просмотра выбирает сам агент в ходе рассуждения.
Кроме изображений, агент ведёт две заметки. В одной он сохраняет правила среды, которые пригодятся на следующих уровнях, в другой — текущее состояние задачи. Когда контекст заканчивается, модель пишет краткую сводку и продолжает в новом контексте, а кадры, заметки и история действий остаются доступны.
Такой подход сохраняет не всё внутри запроса к модели, а возможность заново получить нужное свидетельство. Например, после сброса игрового поля агент восстановил карту по кадрам из прошлых ходов. В другой задаче он увеличил небольшие блоки и различил маркеры ориентации, которые терялись на полном изображении.
Память о кадрах довела ARC-AGI-3 до полного прохождения
Основной тест — 25 публичных игр ARC-AGI-3. В них агенту не сообщают правила и цель: он должен экспериментировать, замечать изменения на экране и переносить найденные закономерности между уровнями.
Claude Opus 5.0 с VISTA получил 100 баллов по показателю относительной эффективности действий человека. Метрика учитывает, завершил ли агент уровни и сколько действий потратил по сравнению с людьми, которые играли впервые. Официальная реализация с той же моделью получила 40,68 балла, хотя режимы рассуждения различались: VISTA запускали с более высоким уровнем вычислительных усилий.
При полном прохождении агент использовал на 57,4% меньше действий, чем человеческая база сравнения. Результат показывает не только способность модели найти цель, но и то, что она могла возвращаться к прежним наблюдениям вместо повторного исследования среды.
Проверка не ограничилась одним типом игр. Ту же схему применили к браузерным играм GameWorld и AI GameStore, а также к статическим визуальным задачам BabyVision. В последнем случае истории взаимодействия не было: выигрыш дала возможность увеличивать выбранные области и проверять отдельные пиксели.
Сначала стоит проверить обвязку, а не менять модель
Работа меняет порядок экспериментов для агентов, которые долго работают со скриншотами. Если модель забывает расположение объектов, повторяет разведку или принимает решение по неточной текстовой сводке, следующий прототип стоит строить вокруг внешнего архива исходных кадров и управляемого поиска по нему.
Архитектурно полезно разделить три операции: сохранить наблюдение без преобразований, прочитать прошлое состояние и выполнить действие, которое меняет среду. Чтение памяти должно оставаться безопасной операцией, а модель должна сама выбирать кадры и области по мере появления новых гипотез. VISTA показывает, что заранее составленная сводка хуже подходит для деталей, важность которых становится понятна лишь через несколько шагов.
При этом работа проверяет подход прежде всего на публичных визуальных играх и головоломках с Claude Opus 5.0 и GPT-5.6 Sol. Эти модели вышли после тестовых наборов, поэтому нельзя исключить попадание игр в обучающие данные; частный набор ARC-AGI-3 в проверку не входил. В статье также не приведён разбор задержки и стоимости хранения и повторной передачи изображений, без которого нельзя оценить производственную экономику такой памяти.
Поэтому VISTA пока не доказывает, что тот же результат сохранится в интерфейсах бизнеса или физических средах. Она даёт более узкий практический вывод: перед дообучением модели или переходом на более дорогую версию стоит проверить, не ограничивает ли агента способ хранения и повторного просмотра визуальной истории.
Источники
Иллюстрация: рисунок из статьи «VISTA: A Visual Harness for Reasoning in an Interactive World», Qiushi Han, Keya Hu, Linlu Qiu и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


