
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Головы внимания в LLM меняют поведение прямо во время генерации, поэтому назначенная заранее политика хранения KV-кэша быстро устаревает. В нерецензированном препринте числа получил сам автор: на Mistral-7B метод WakeKV снизил долю промахов в семь раз при том же объёме памяти. Командам, которые обслуживают длинные контексты, работа предлагает заменить необратимое удаление данных на возврат с CPU по запросу.
Большинство голов хотя бы раз меняют область внимания
KV-кэш хранит ключи и значения для уже обработанных токенов, чтобы модель не вычисляла их заново на каждом шаге. Каждая голова внимания читает из этого кэша свой набор позиций. Когда контекст растёт, весь набор перестаёт помещаться в память GPU, и системе приходится решать, что оставить, перенести или удалить.
Многие методы принимают такое решение один раз: до запуска либо после первичной обработки запроса. Одни головы получают плотный кэш, другим оставляют сокращённый набор. Эта схема работает, только если голова сохраняет одну роль до конца ответа.
Utkarsh Ranjan из UC San Diego сравнил наборы позиций, которые головы читали на соседних шагах, и отдельно искал устойчивые сдвиги с поправкой на случайное совпадение. Хотя постоянно нестабильными оказались лишь 2–9% голов, хотя бы один заметный сдвиг пережили 63–85%. Значит, основная проблема не в небольшой группе хаотичных голов: роль эпизодически меняет большинство.
Предсказать такой переход заранее не получилось. Изменение пересечения страниц, динамика распределения внимания и другие дешёвые сигналы не давали надёжного результата во всех режимах. Признаки в сгенерированных токенах помогали при длинных рассуждениях, но не переносились на поиск спрятанного фрагмента и многоходовое воспроизведение контекста.
WakeKV не удаляет страницу окончательно
WakeKV отказывается назначать голове постоянный класс. Для каждой головы метод держит на GPU ограниченный набор страниц — блоков сохранённых ключей и значений — и упорядочивает их по давности использования. Когда место заканчивается, самая давно не востребованная страница переезжает в оперативную память.
Состояние страницы сохраняется полностью. Если голова снова запрашивает её, система возвращает данные через PCIe до завершения текущего шага внимания. Ошибочное решение поэтому вызывает задержку на одну передачу, а не навсегда лишает модель части истории.
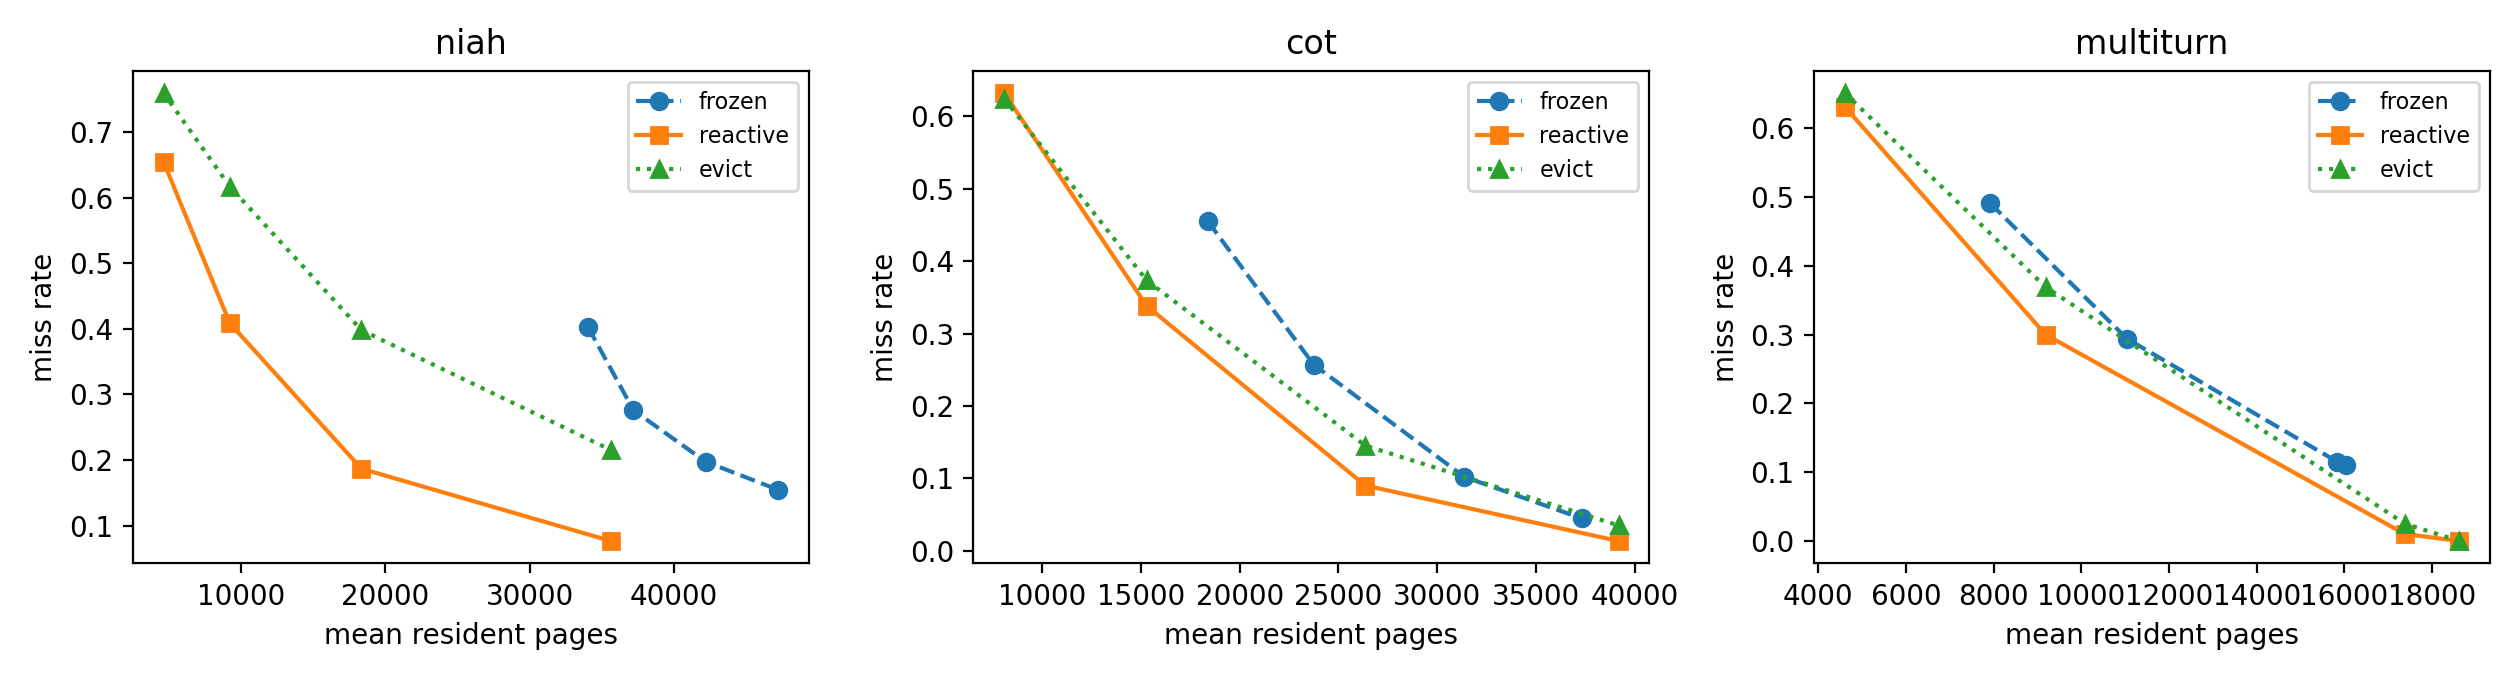
Такой резерв отличает WakeKV и от фиксированной классификации, и от динамических методов, которые освобождают память необратимо. При одинаковом фактическом расходе памяти WakeKV выиграл все 32 сравнения со SnapKV, uniform R-KV и ReasonAlloc. В сравнении с удалением по тому же расписанию он уступил только один раз — при самом тесном бюджете на длинном рассуждении.
Проверка на реальной системе использовала надстройку над FlexiCache и vLLM. В строгом режиме, где размещение пересматривается на каждом шаге, пропускная способность оказалась на 34% выше штатной конфигурации FlexiCache, а результат LongBench сохранился на уровне 97,4%. Выигрыш связан не только с переносом памяти: конфигурация также уменьшала объём вычислений внимания.
Архитектуру стоит менять сначала в виде ограниченного прототипа
Работа поддерживает конкретное решение для сервинга: не пытаться идеально предсказать будущую важность головы, а хранить удалённые страницы так, чтобы их можно было вернуть. Такая схема требует резерва в оперативной памяти, учёта страниц для каждой головы и обработки промахов без продолжения вычислений на неполном состоянии.
Проверка охватила модели размером от 1,5 до 8 млрд параметров и три режима: NIAH с контекстом примерно на 5000 токенов, длинные математические рассуждения и воспроизведение сведений после нескольких ходов диалога. Симулятор измерял долю промахов, а не реальную задержку каждого возврата. Аппаратный эксперимент прошёл только на Mistral-7B с одним GPU A30 и одной конфигурацией длинного контекста.
Поэтому работа пока не обосновывает полную замену существующей системы кэширования во всех нагрузках. Она обосновывает отдельный эксперимент: добавить обратимый резерв к текущей политике, измерить задержки PCIe, пропускную способность и качество на собственных запросах. Если переносы не съедают выигрыш от меньшего рабочего набора на GPU, статическая классификация голов становится необязательной частью архитектуры.
Источники
Иллюстрация: рисунок из статьи «WakeKV: Reactive, Reversible KV Residency for Heads That Change Their Minds», Utkarsh Ranjan, CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


