Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Нейронный оператор научили обучаться без решений от численного решателя и при этом не застревать на искусственном распределении данных. В препринте Caltech и University of Toronto, который не прошёл рецензирование и приводит числа из замеров самих авторов, WaSP снизил относительную ошибку решения в 3,9–9,5 раза против сильнейшего из соперничающих методов. Такой подход позволяет сократить число дорогих обучающих пар там, где у команды уже есть уравнение и набор целевых входных данных.
Почему точные искусственные пары не решают задачу
Нейронный оператор приближает решение уравнения в частных производных (PDE): получает начальные условия, граничные условия или внешнее воздействие и возвращает поле решения. Обычное обучение требует множества пар «вход — решение», которые получают численным моделированием, измерениями или наблюдениями.
Обойти численный решатель можно двумя способами. Физически обусловленное обучение подставляет ответ модели в уравнение и штрафует его за невязку. Метод искусственных решений действует в обратную сторону: сначала создаёт произвольное поле решения, а затем применяет к нему оператор уравнения и получает соответствующий вход.
Второй способ даёт сколько угодно математически точных пар, но они могут почти не пересекаться с данными, которые модель увидит после запуска. В гауссовской модели функций авторы показывают, что искусственное и целевое распределения могут оказаться взаимно сингулярными: они занимают разные области пространства функций. Чтобы избежать этого напрямую, пришлось бы подбирать разброс каждой частотной компоненты, а для этого нужно почти столько же знаний о решениях, сколько требует само уравнение.
У обучения по невязке другая проблема. Слабая норма упрощает оптимизацию, но малая невязка тогда не гарантирует близкое решение. Более строгая норма лучше контролирует ошибку, однако повышает разброс оценок на мини-пакетах и усложняет обучение. На уравнении Kuramoto–Sivashinsky коэффициент, связывающий невязку с ошибкой решения, также может расти экспоненциально при ослаблении диссипации.
Как WaSP строит путь к целевым входам
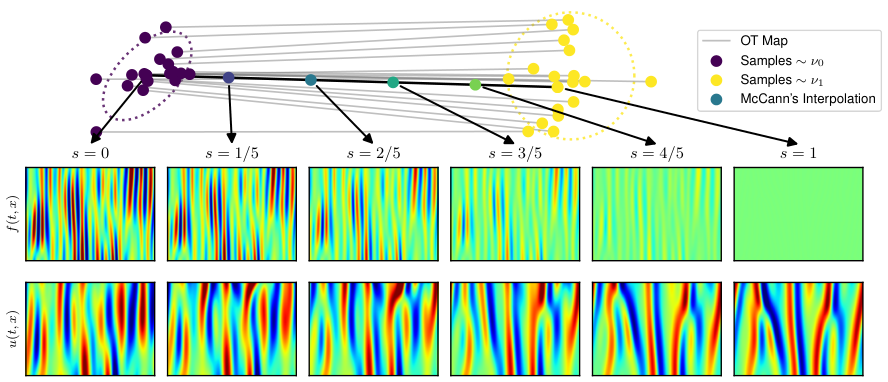
WaSP начинает с искусственных решений и применяет к ним оператор уравнения. Так возникает исходное распределение входов и точные обучающие пары. Отдельно метод получает неразмеченные входы из целевого распределения — без рассчитанных для них решений.
Затем WaSP оценивает оптимальный перенос между двумя распределениями и прокладывает между ними путь в метрике Вассерштейна. Вместо одного скачка модель проходит последовательность близких распределений: от удобных искусственных примеров к входам, которые встретятся при использовании оператора.
На каждом этапе текущая модель предсказывает решения для следующей части пути. WaSP снова применяет к этим решениям точный оператор уравнения и получает скорректированные входы. Поэтому новая пара точно удовлетворяет уравнению, даже если исходный прогноз модели был неточным. Локальный штраф за невязку удерживает синтезированные примеры рядом с намеченным путём, а адаптивное расписание добавляет этапы там, где ошибка растёт быстрее.
На Allen–Cahn относительная ошибка оказалась в 3,9 раза ниже, чем у сильнейшего базового метода, на Kuramoto–Sivashinsky — в 9,5 раза, на complex Ginzburg–Landau — в 4,6 раза. Сравнение включало физически обусловленный нейронный оператор PINO, обучение на искусственных данных и варианты, где перенос или физический штраф добавляли по отдельности.
Для двух хаотических систем WaSP также точнее воспроизвёл инвариантные распределения, пространственные и временные автокорреляции и энергетический спектр. Это существеннее одной средней ошибки: суррогат хаотической системы может быстро разойтись с отдельной траекторией, но всё ещё должен сохранять её долгосрочную статистику.
Когда WaSP стоит добавить в план разработки
Работа меняет план эксперимента, если численные решения дороги, но команда может дёшево применять сам оператор уравнения и собирать неразмеченные целевые входы. В таком случае WaSP предлагает промежуточный вариант между полной генерацией датасета решателем и обучением только по невязке: основным сигналом остаётся обычная регрессия на парах, а физика исправляет входы и ограничивает дрейф.
Метод не устраняет подготовку исходного распределения. Для каждого уравнения авторы вручную задавали меру искусственных решений; удачный выбор сокращает путь переноса и облегчает обучение. Также приходится оценивать транспорт между распределениями и обучать оператор в несколько этапов, поэтому конвейер сложнее одиночного запуска PINO.
Проверка охватывает одномерные периодические эволюционные уравнения и одну архитектуру — Fourier Neural Operator. По расходу памяти на GPU WaSP сопоставим с PINO, но требует больше инфраструктуры на CPU и хуже масштабируется на нём. Хотя сам алгоритм не привязан к архитектуре, результаты пока не показывают, как он поведёт себя в более высоких размерностях, на сложной геометрии или с другими нейронными операторами.
Практический вывод узкий: WaSP стоит включать в прототипирование как отдельную ветку, когда главный расход создаёт разметка целевых входов численным решателем. Работа не обосновывает замену действующего решателя во всех задачах, но показывает, как превратить большой разрыв между искусственными и рабочими данными в последовательность локальных переходов.
Источники
Иллюстрация: рисунок из статьи «WaSP: Wasserstein Data Synthesis Pipeline for Solver-Free Operator Learning», Ryan Liu, Chuwei Wang, Ricardo Baptista и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.